SaProt蛋白质语言模型:结构感知如何突破「只读序列」的局限
发布于 2026年11月5日
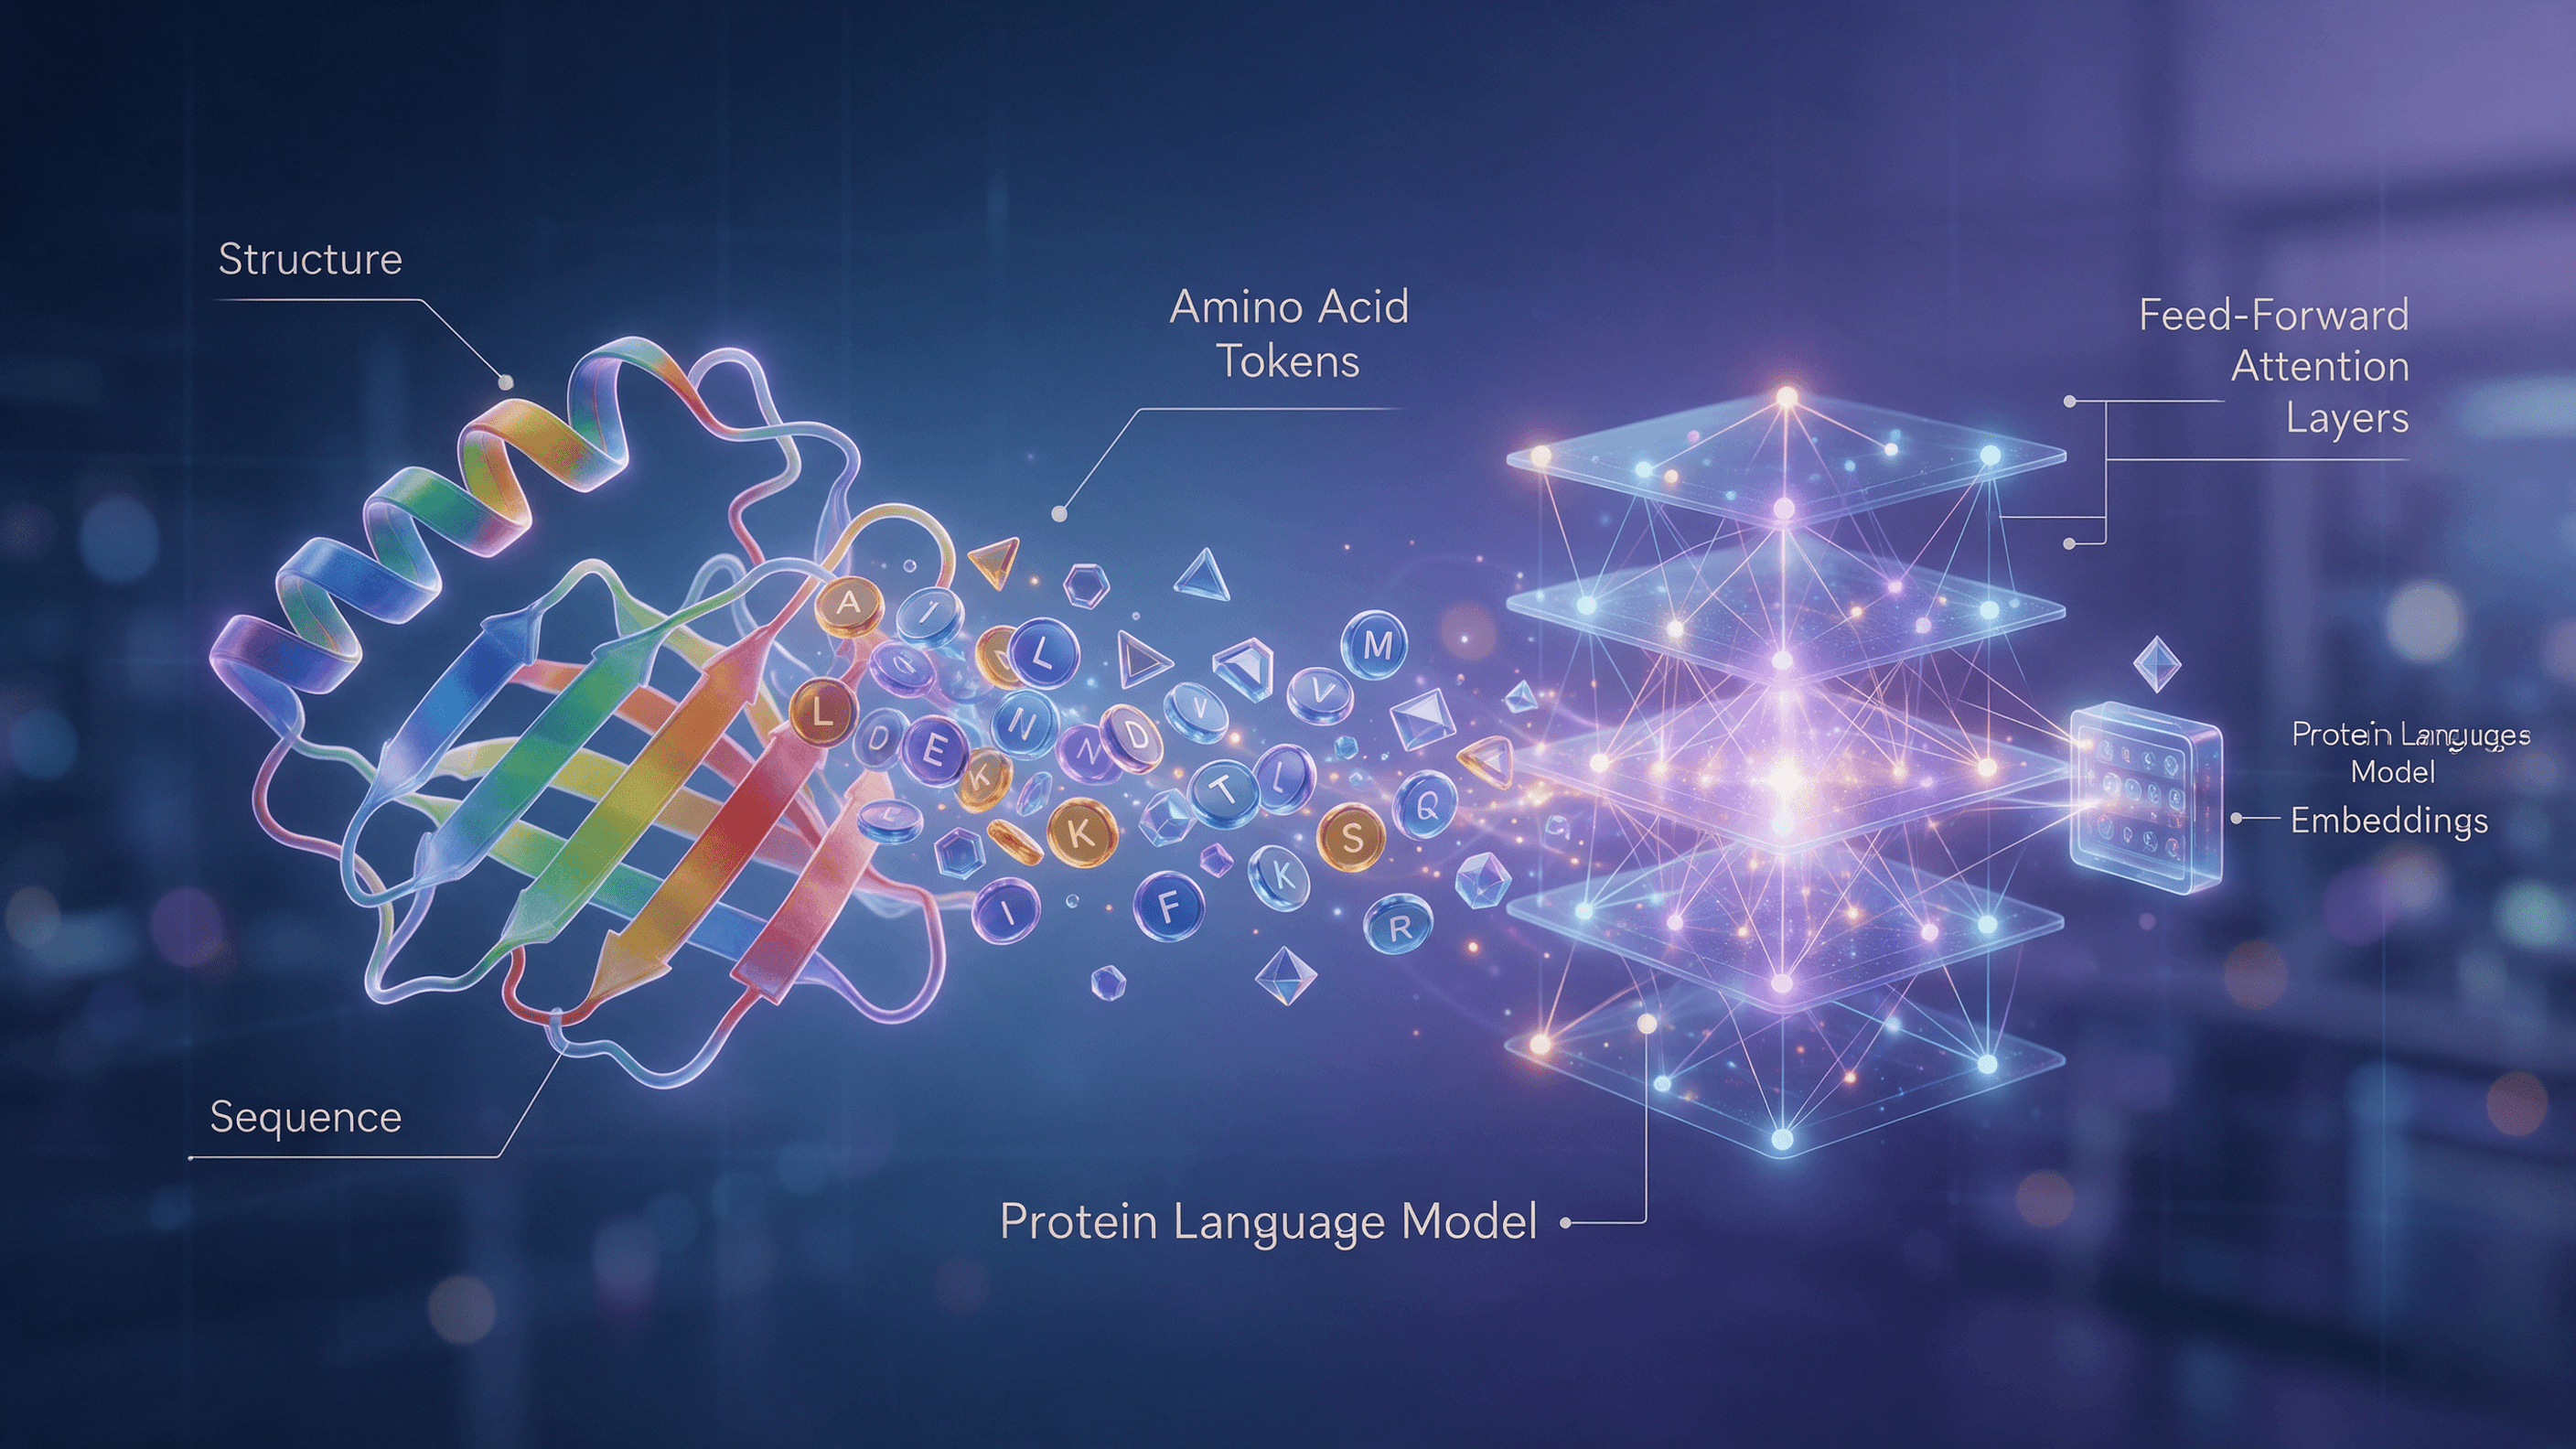
图1 SaProt结构感知蛋白质语言模型:从序列与结构走向功能预测
当语言模型不仅能读「氨基酸序列」,还能「看懂」每个残基所处的局部三维结构,蛋白质功能预测会发生什么?SaProt给出了一个可复现的答案。
为什么蛋白质语言模型需要「看得见」结构?
蛋白质语言模型(Protein Language Model,PLM)的崛起,源自一个朴素而强大的事实:氨基酸序列决定了可折叠出的三维结构,而结构又决定了功能。过去几年,以ESM家族为代表的PLM通过在数亿条天然序列上做无监督预训练,学会了「序列→隐式生物学规律」的映射,在结构预测、功能注释、变体效应评估等任务上表现亮眼。
但「只读序列」有一个天然盲区:同一条氨基酸序列在不同环境下,或作为蛋白质不同结构域的一部分时,局部构象可能显著不同;而相同功能往往来自相似的三维结构而非完全相同的序列。序列token无法显式携带残基所处的空间环境信息,模型需要从序列中去「猜」结构。
于是问题变成:能不能把明确的结构信息直接「喂」给语言模型,而不是让它从序列里隐式推断?
SaProt的思路正是从这里出发——把3D结构转化为可被Transformer直接消费的离散token,与氨基酸token并列,构成一张「结构感知词表」。
SaProt 的「结构感知词表」是如何工作的?

图2结构感知词表:氨基酸token与3Di结构token的乘积组合
核心机制:一张把「序列」和「结构」同时编码进token 的词表
传统PLM的词表是20种氨基酸+特殊token。SaProt的做法是:
1. 残基token:沿用氨基酸类型(如A、V、L、D…),代表「这是什么残基」;
2. 结构token:用Foldseek 的「3Di」局部结构字母(约20个3Di状态)编码「这块区域的三维折叠形态」,代表「这个残基处于什么样的局部结构中」;
3. 符号化组合:把「残基×结构」两两相乘,得到一张结构感知词表——21(20氨基酸+掩码)× 21(20结构态+掩码)≈ 441个token。每个位点由一个「氨基酸字母+三维状态字母」的二元符号表示,让模型在同一个注意力空间里同时看到序列与结构。
预训练与架构
有了这张词表,SaProt采用BERT式掩码语言建模(Masked Language Modeling)在约 4000万条蛋白质序列与结构上预训练(结构主要来自AlphaFoldDB与PDB)。架构上沿用ESM-2(约6.5亿参数),但因为词表扩大,其嵌入层(embedding layer)相应加大以容纳441个token。官方发布 35M / 650M / 1.3B 三档参数权重,并额外提供一个在PDB结构上微调的650M版本,用户可按任务规模与算力选型。
示意图说明:上图以抽象方式示意「氨基酸token × 3Di结构token →结构感知词表」的融合逻辑,并非某个具体蛋白的真实残基标注,非按比例,仅作原理示意。
能力边界(重要)
正因为「结构感知」依赖3D结构输入,SaProt的边界也随之出现:
· 需要有结构:对每个目标蛋白/突变体都需要先有3D结构(实验解析或AlphaFold2等预测);
· 结构质量敏感:若结构低置信(如低pLDDT区域),对应的3Di token可靠性下降,会连带影响下游判断;
· 并非"结构兜底":它融合的是「局部构象」信息,不等于完整的de novo结构建模,也不能替代完整的三维结构预测与实验验证。
这些边界,恰恰说明了「模型+实验+工程化平台」协同的必要性。
SaProt 能在哪些任务上更强?
SaProt论文在多类下游任务上系统评估,整体性能优于ESM-1b、ESM-2等成熟基线。这既包括蛋白层级任务,也包括残基层级任务:
任务类型 | 代表任务 | SaProt的表现方向 |
结构/功能注释 | 二级结构、可及性、接触图预测 | 结构token提供直接几何先验,整体优于序列模型 |
蛋白层级属性 | 稳定性预测、适应性、荧光预测 | 在ProteinGym等变体效应榜单上表现突出 |
互作与功能 | 蛋白-蛋白相互作用、临床变异解读 | 结构感知带来更强的泛化与判别力 |
生成/迁移 | 蛋白序列设计、定向进化评估 | 为批量打分(fitness landscape)提供更强的判别基座 |
值得强调的是,SaProt并非只在「结构类」任务上占优,它在纯粹基于序列的评测(如零样本变体效应、稳定性和功能预测)上也整体领先,说明结构信息的引入能反哺序列语义的建模。
真实效果以实测为准:以上为论文与公开基准上的「模型层」结果。落到具体蛋白与工艺,需要结合实验数据与目标体系验证,不能脱离实测直接套用。
如何在蛋白工程中使用SaProt?
要让SaProt发挥价值,通常遵循「结构准备→打分/嵌入→实验验证→迭代」的闭环:
1. 准备结构:对目标蛋白,拿实验结构或AlphaFold2预测结构;
2. 生成结构感知序列:用Foldseek将结构编码为3Di结构token,与氨基酸序列拼接;
3. 推理打分:用SaProt词表做掩码预训练/微调,或直接抽取embedding,用于变体效应打分、稳定性排序、功能预测;
4. 实验验证:对高分候选做湿实验(如酶活性、热稳定性、表达量)验证;
5. 闭环迭代:把验证结果反馈进模型,持续修正打分偏好。

图3 SaProt在蛋白工程中的应用与干湿闭环
社区实践也印证了这条路径:据公开报道,SaProt/ColabSaProt已在超过10个蛋白上获得湿实验验证(涵盖酶突变、荧光蛋白修饰与荧光预测等),并曾位列ProteinGym权威榜单第一。
工程化提示:SaProt是开源的判别/表征模型(MIT许可,GitHub与HuggingFace可获取)。但要在真实研发中规模化使用,仍需要把「结构获取、打分、实验、数据回流」串成自动化的干湿闭环,并控制好结构质量与批次一致性。
MatwingsVenus®(晓鹜®)的赋能:从「模型」到「干湿闭环」
MatwingsVenus®(晓鹜®)对SaProt这类结构感知模型的价值,不在于重复造一个模型,而在于把模型的预测真正变成可验证、可迭代的研发结果:
· wet-lab湿实验服务:为SaProt的高分候选提供酶活、热稳定性、表达量等实测,把「预测」闭环成「实测」,避免只停留在数字打分;
· expert-center专家中心:结合蛋白工程与生信专家,完成从结构准备、模型选型到实验设计的整体方案;
· dry-wet-closed-loop-platform干湿闭环平台:把「结构感知打分→实验验证→数据回流」串成自动化闭环,支持批量序列设计、变体排序与下一代候选生成。
换句话说:SaProt提供「更聪明的判别器」,MatwingsVenus®(晓鹜®)提供「让判别器被实验验证、并持续自我修正」的工程化体系。 二者结合,才能把结构感知模型的潜力落到真实研发。
FAQ 常见问题
SaProt 是什么?
SaProt(Structure-aware Protein Language Model)是一种结构感知蛋白质语言模型,由西湖大学团队提出,通过「氨基酸残基+ 3Di局部结构」双词表,把3D结构显式编码进语言模型的token空间。
SaProt 和 ESM-2 有什么不同?
两者都基于Transformer架构,SaProt在架构上沿用ESM-2(约6.5亿参数),但把词表从20氨基酸扩展到包含3Di结构token的结构感知词表(约441 token),因此嵌入层更大,并显式融合了结构信息。
SaProt 需要什么输入?
需要目标蛋白的氨基酸序列+ 3D结构(实验结构或AlphaFold2等预测结构),结构会被Foldseek编码为3Di结构token后与序列token拼接。
SaProt 主要能预测什么?
它可用于蛋白功能与结构注释、稳定性/适应性/变体效应预测、蛋白-蛋白相互作用、临床变异解读,并可作为蛋白序列设计与定向进化评估的判别基座。
SaProt 的能力边界在哪里?
它依赖可靠的3D结构输入,结构低置信时3Di token可靠性下降;它编码的是局部构象信息,不能替代完整的三维结构建模或实验验证,需与实验/工程化平台协同。
我应该用哪个规模的SaProt?
官方提供35M / 650M / 1.3B 三档权重,另有PDB微调的650M版本。小蛋白/轻量任务用35M更省算力;追求上限用650M–1.3B;需要更强结构对齐可用PDB调优版,具体以任务与算力权衡。
SaProt 是开源的、可商用吗?
是。SaProt以 MIT许可开源,代码在GitHub(westlake-repl/SaProt),预训练权重在HuggingFace可获取,支持社区与商业场景二次开发与再训练。
总结
SaProt的核心洞察是:把「结构」从序列的隐式背景,变成语言模型可显式消费的token。通过「氨基酸残基× 3Di局部结构」的结构感知词表,它在约4000万蛋白结构与序列上完成预训练,并在变体效应、稳定性等10项任务上整体领先传统序列模型,成为「序列-结构-功能」一体化建模的代表性开源底座。
但正如所有模型一样,SaProt有其边界——结构质量、输入依赖、以及"预测不等于实测"。真正把它的能力转化为研发成果,需要模型+湿实验验证+干湿闭环平台三者协同。MatwingsVenus®(晓鹜®)正是围绕「让结构感知模型被实验验证、并持续自我修正」来赋能蛋白工程,把AI的预测变成可交付的研发进展。
本文基于公开论文与开源资料整理,具体蛋白体系请以实测试验为准;文中对SaProt的性能描述为模型层面/公开基准结果,非针对任何特定蛋白的实测承诺。