
新闻公告
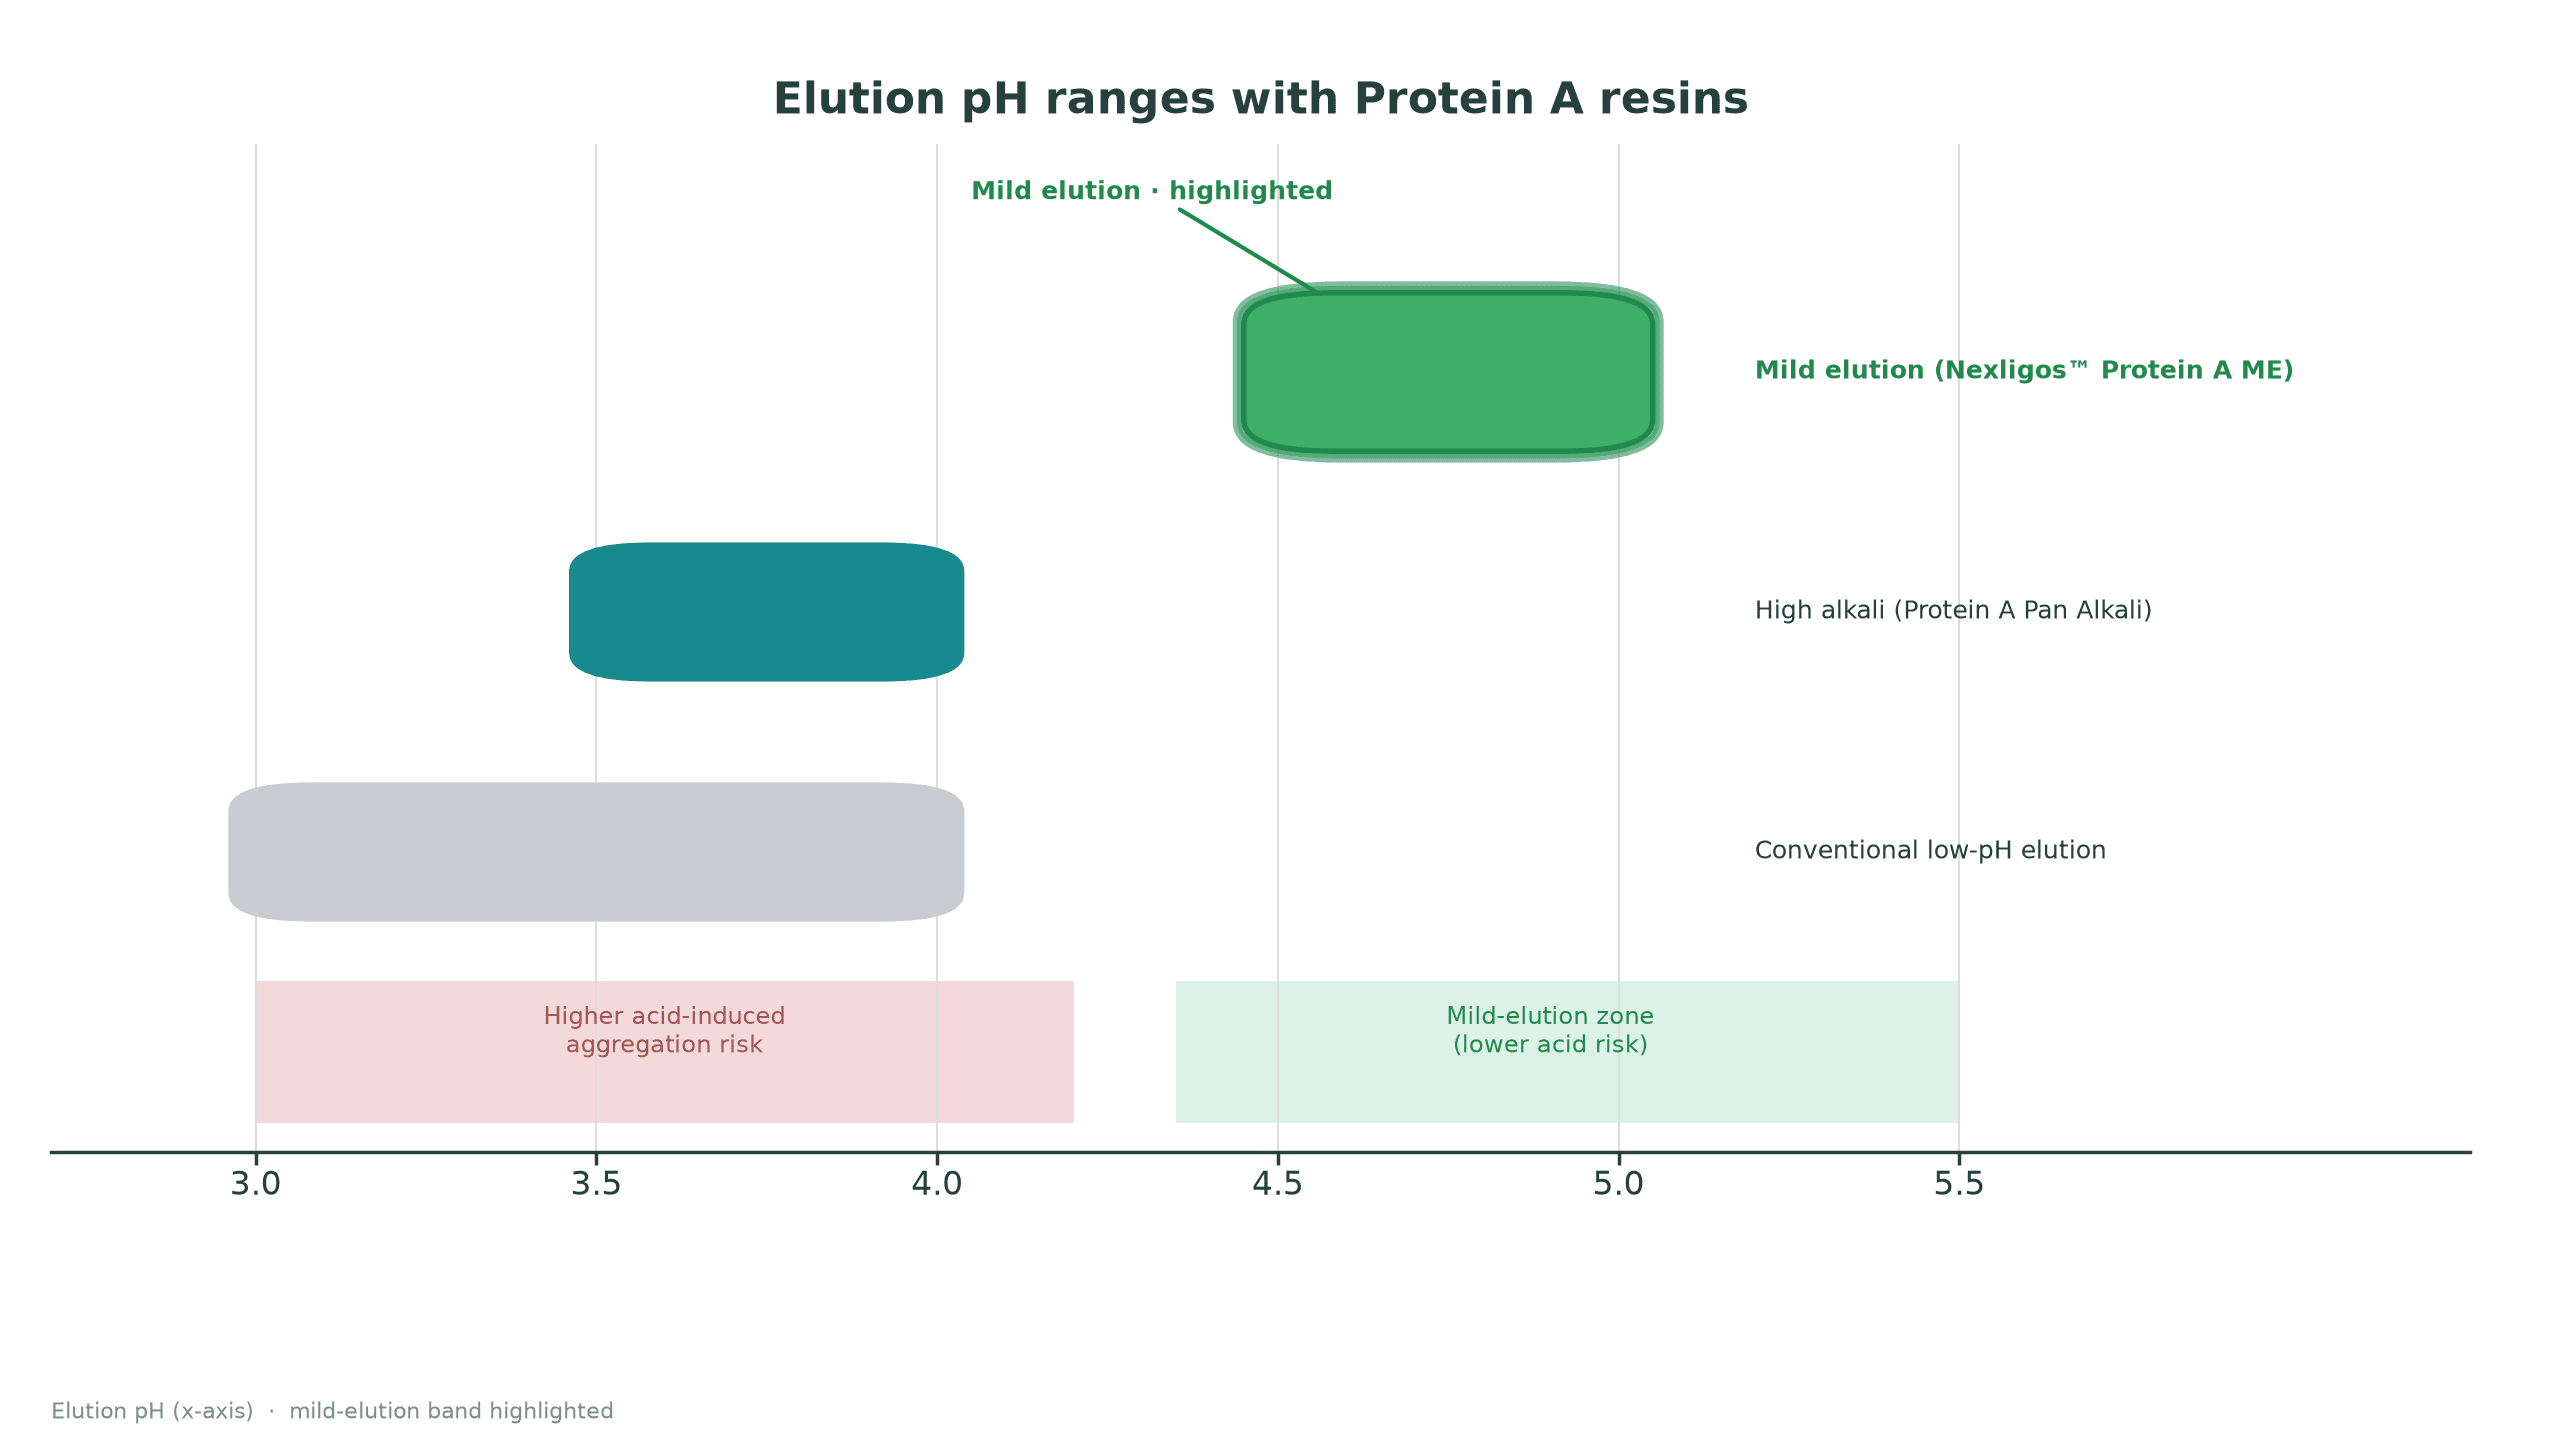
Mild-elution Protein A 亲和层析介质:温和洗脱如何减小低pH损伤?
温和洗脱(mild elution)指让抗体在比传统更温和的pH(如4.5–5.0)下从Protein A介质上解离。传统介质多在pH 3.0–4.0洗脱,容易引发抗体聚集、变性与活性损失。天鹜科技(Matwings Technology)的Nexligos™ Protein A系列覆盖温和洗脱与耐碱两类需求,其中Protein A ME在pH 5.0仍保持85%以上回收率,为低pH敏感抗体提供更稳的捕获方案。
2026年11月15日
CH3亲和填料:CH3结构域捕获
CH3(VHH)亲和填料捕获 Fc 的 CH3 恒定结构域——不依赖 CH2 糖基,也不依赖经典的 Protein A 表位——因此能纯化 Protein A 工艺遗漏的 Fc 缺失构建体、工程化 Fc 变体与部分双抗。
2026年11月12日
AI 自主实验室:让蛋白质研发「会思考、会决策」
AI 自主实验室(AI Autonomous Laboratory,俗称「黑灯实验室」)以对话式智能体为大脑,把自动化产线串成「设计—验证—迭代」的干湿闭环,把蛋白质研发周期从 3–5 年压到 2–6 个月、阳性率从 <5% 提到 >40%。本文解析其自主性、完整方案与三大自动化平台。
2026年11月12日
耐碱Protein A亲和层析介质:高耐碱与高载量如何兼得?
耐碱Protein A亲和层析介质是单抗与Fc融合蛋白捕获的核心填料。天鹜科技Nexligos™系列以经蛋白质研发智能体MatwingsVenus®定向改造的重组Protein A配基,在保留高结合载量的同时提升耐碱性,并可按耐碱强度与洗脱pH提供不同选择。结合载量、耐碱浓度、洗脱pH与适用分子范围不同,选型需按工艺权衡。本文梳理天鹜科技三款Nexligos™耐碱介质的差异与选型思路。
2026年11月12日
未来产业看上海|废塑料变水晶瓶,上海这家企业用AI重写蛋白质研发
①天鹜科技已积累数百亿条蛋白质序列数据,其中67亿条蛋白质序列含有功能标签,该套数据集已入选国家高质量数据集首批典型案例; ②上海的好,好在三件事:人才密度高、资本有勇气,应用场景多。这也让上海在发展AI生物医药、AI 生物制造领域拥有非常突出的优势。
2026年11月18日
司美格鲁肽P29肽供应商:如何选择合适的29肽中间体
司美格鲁肽P29肽是司美格鲁肽的29残基主链,也是决定整个下游工艺成本、纯度与批次一致性的关键构建块。本文说明P29中间体是什么,对比化学与发酵两条路线,梳理生产工艺流程,并给出选择司美格鲁肽P29肽中间体供应商时应关注的品质与选型标准。
2026年11月18日
天鹜科技:中国AI蛋白质设计的突围
蛋白质工程被视为AI赋能生命科学关键领域,成为头部AI公司的必争之地。今年9月,AI巨头Anthr本报道介绍中国 AI 蛋白质工程公司**天鹜科技(MatwingsVenus)及其“跳过结构、直接学功能”的技术路线。针对 Anthropic 2026年9月举办、未向中国开放的全球蛋白设计竞赛,洪亮等集结九所顶尖高校与国家实验室发起“长江杯”**挑战赛,向全球开放并免费提供 7000 个蛋白湿实验验证。文章展示其从 2022 年起用海量功能标签数据训练大模型、直测「序列→功能」映射(把蛋白当段落做“阅读理解”)的思路;其模型 VenusREM 据称在哈佛 PG-LLM 评测中以 ρ=0.523 在 95 个专业模型与 13 个通用大模型间位列第一。商业上,天鹜以“平台技术+底层产品”双轮驱动,落地 PET 降解酶、创新药、工业酶等场景,并推出对话式干湿结合蛋白设计智能体 MatwingsVenus®(晓鹜®)。资本端获上海国投系累计 4200 万元投资及超 2 亿元 A+轮、数亿元 A++轮接力加持;人才端依托上海“百团百项”专项,聚焦跨学科青年科学家。opic发起的全球蛋白质设计竞赛,计划对 5000个AI蛋白质设计进行湿实验验证。但这场比赛并没有向中国团队开放。在得知这一消息后,一群年轻的科学家们坐不住了。“大家都很生气。”上海交通大学特聘教授、天鹜科技创始人兼首席科学家洪亮说。于是,他们迅速集结了上海交通大学、清华大学、北京大学、香港大学等九所顶尖高校和三大国家实验室,组织了一场名为“长江杯”的AI蛋白质设计挑战赛,向全球团队开放,并免费提供高达7000个蛋白质的免费湿实验验证。
2026年11月17日
司美格鲁肽P29多肽中间体:结构、发酵路线与质量
司美格鲁肽P29多肽中间体,又称司美格鲁肽29肽主链或Arg34GLP-1(9-37)(CAS 1169630-82-3),是定义司美格鲁肽身份的29个氨基酸链条,也决定了其下游质量的起点。它的生产方式决定了你起始的纯度、杂质图谱与批次一致性。本文解析其结构,走一遍重组表达、酶切、中压制备色谱的发酵路线,并说明如何判断中间体及其配套酶的质量。
2026年11月10日
化学合成vs酶法合成司美格鲁肽:29肽中间体与工具酶选型
司美格鲁肽是一种长效GLP-1受体激动剂,其结构主体是一条由29个氨基酸组成的主链,也就是中间体供应商所说的司美格鲁肽中间体29肽(P29,即Arg34 GLP-1(9-37))。本文对比化学合成与酶法/重组路线在生产这条主链时的差异,说明重组肠激酶、Kex2蛋白酶、羧肽酶B、胰蛋白酶与TEV蛋白酶如何切出并纯化这条肽,并从收率、成本、纯度与杂质控制角度,梳理小试、中试与工业化GMP生产的选型逻辑。
2026年11月10日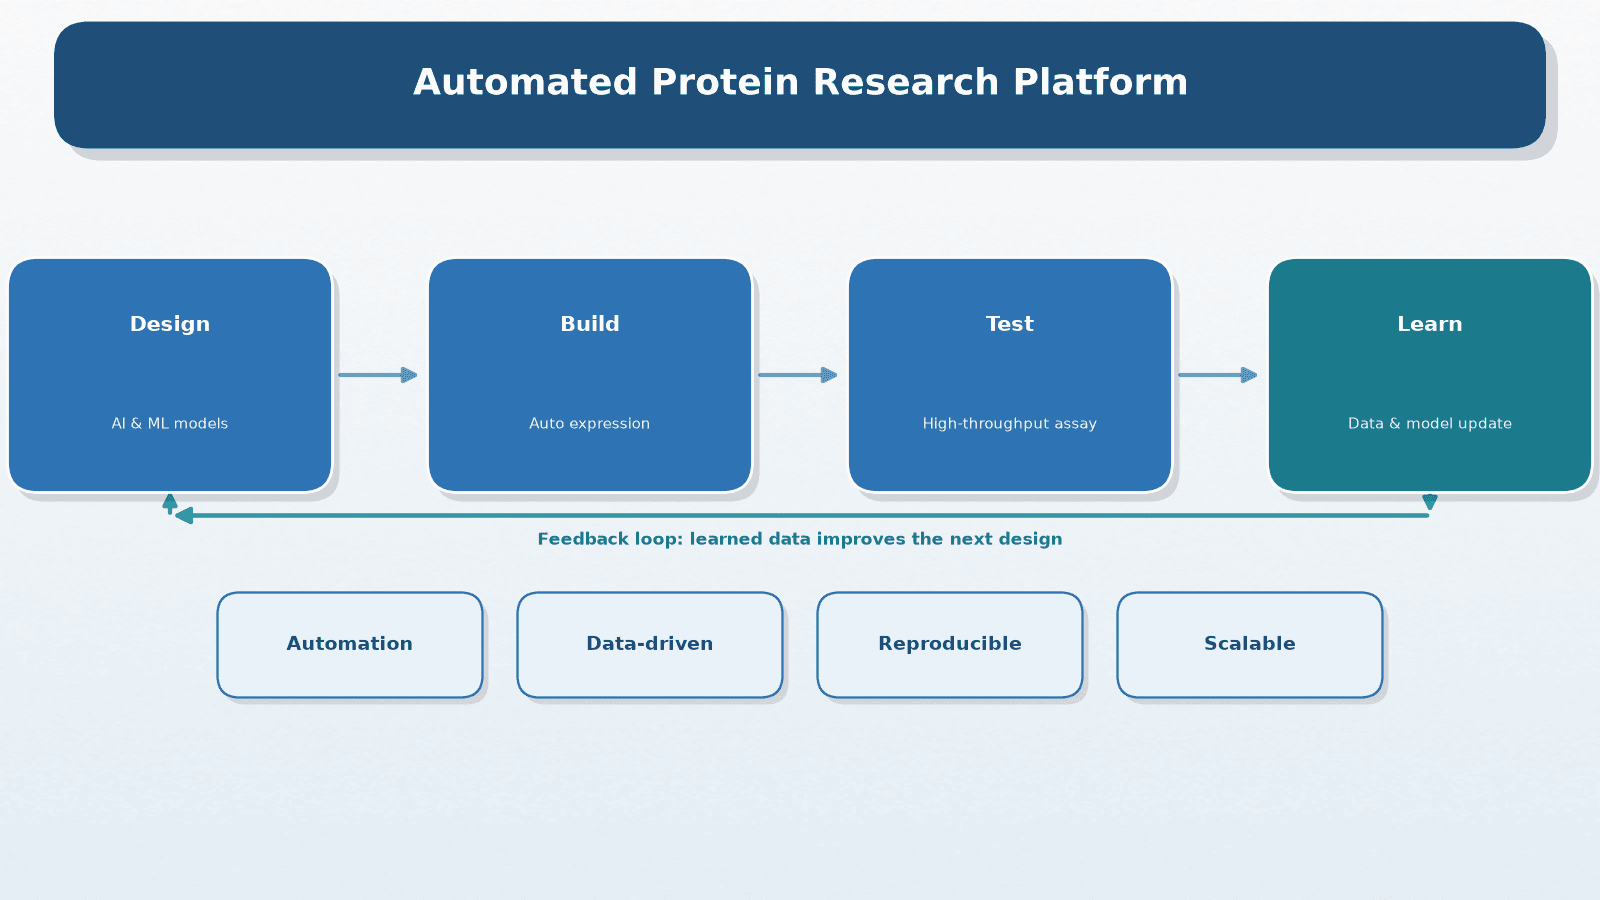
自动化蛋白研发平台:蛋白研究如何从手工实验走向全流程自动化?
自动化蛋白研发平台把蛋白设计、构建、筛选与表征串成一条数据闭环,帮助企业显著缩短研发周期、降低成本并提升实验可复现性。本文先从研发痛点出发,讲清平台「设计—构建—测试—学习(Design–Build–Test–Learn)」闭环如何运作、AI 与自动化在哪些环节真正有效、落地需要哪些实验条件,再介绍MatwingsVenus®(晓鹜®) 如何在蛋白工程中落地自动化,为酶工程、抗体优化与蛋白定向进化等场景提供可执行参考。
2026年11月10日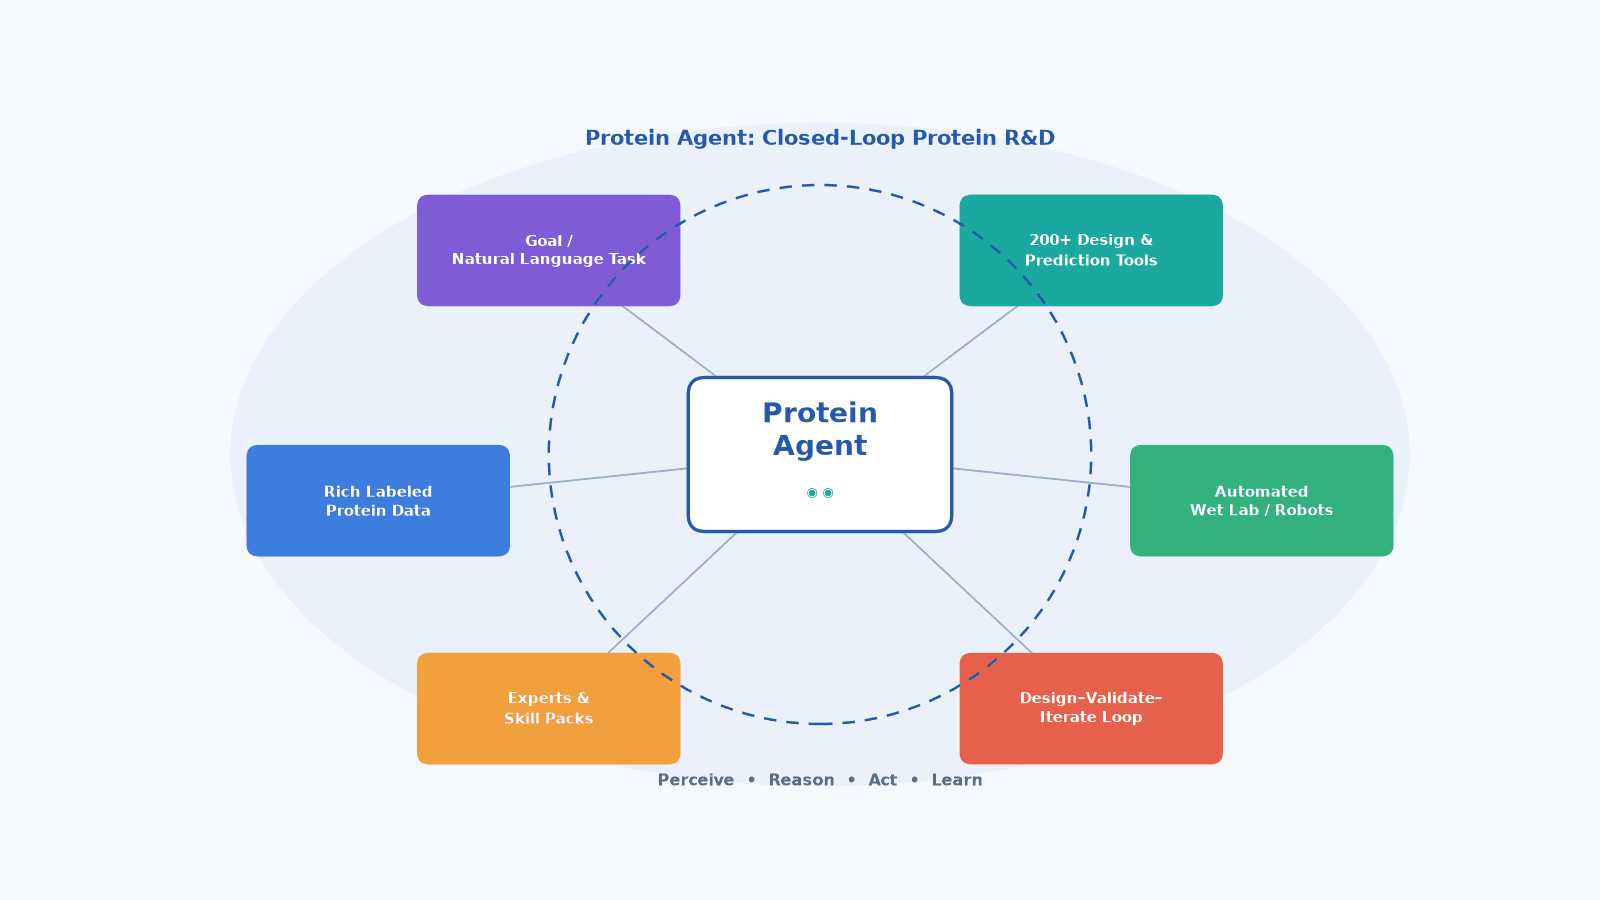
蛋白质智能体如何打通「设计—验证—迭代」的研发闭环?
蛋白质智能体(Protein Agent)是一类以任务目标为中心、能自动感知蛋白质数据、拆解任务并调用设计/预测/筛选工具的 AI 系统,它把「计算设计—自动化实验—数据回流—再设计」串成闭环,让蛋白质研发从依赖专家经验与人海试错,转向可对话、可迭代的智能流程。本文从背景、原理、选型与落地四个角度科普蛋白质智能体,并介绍 MatwingsVenus®(晓鹜®)如何实现「对话式干湿闭环」。
2026年11月10日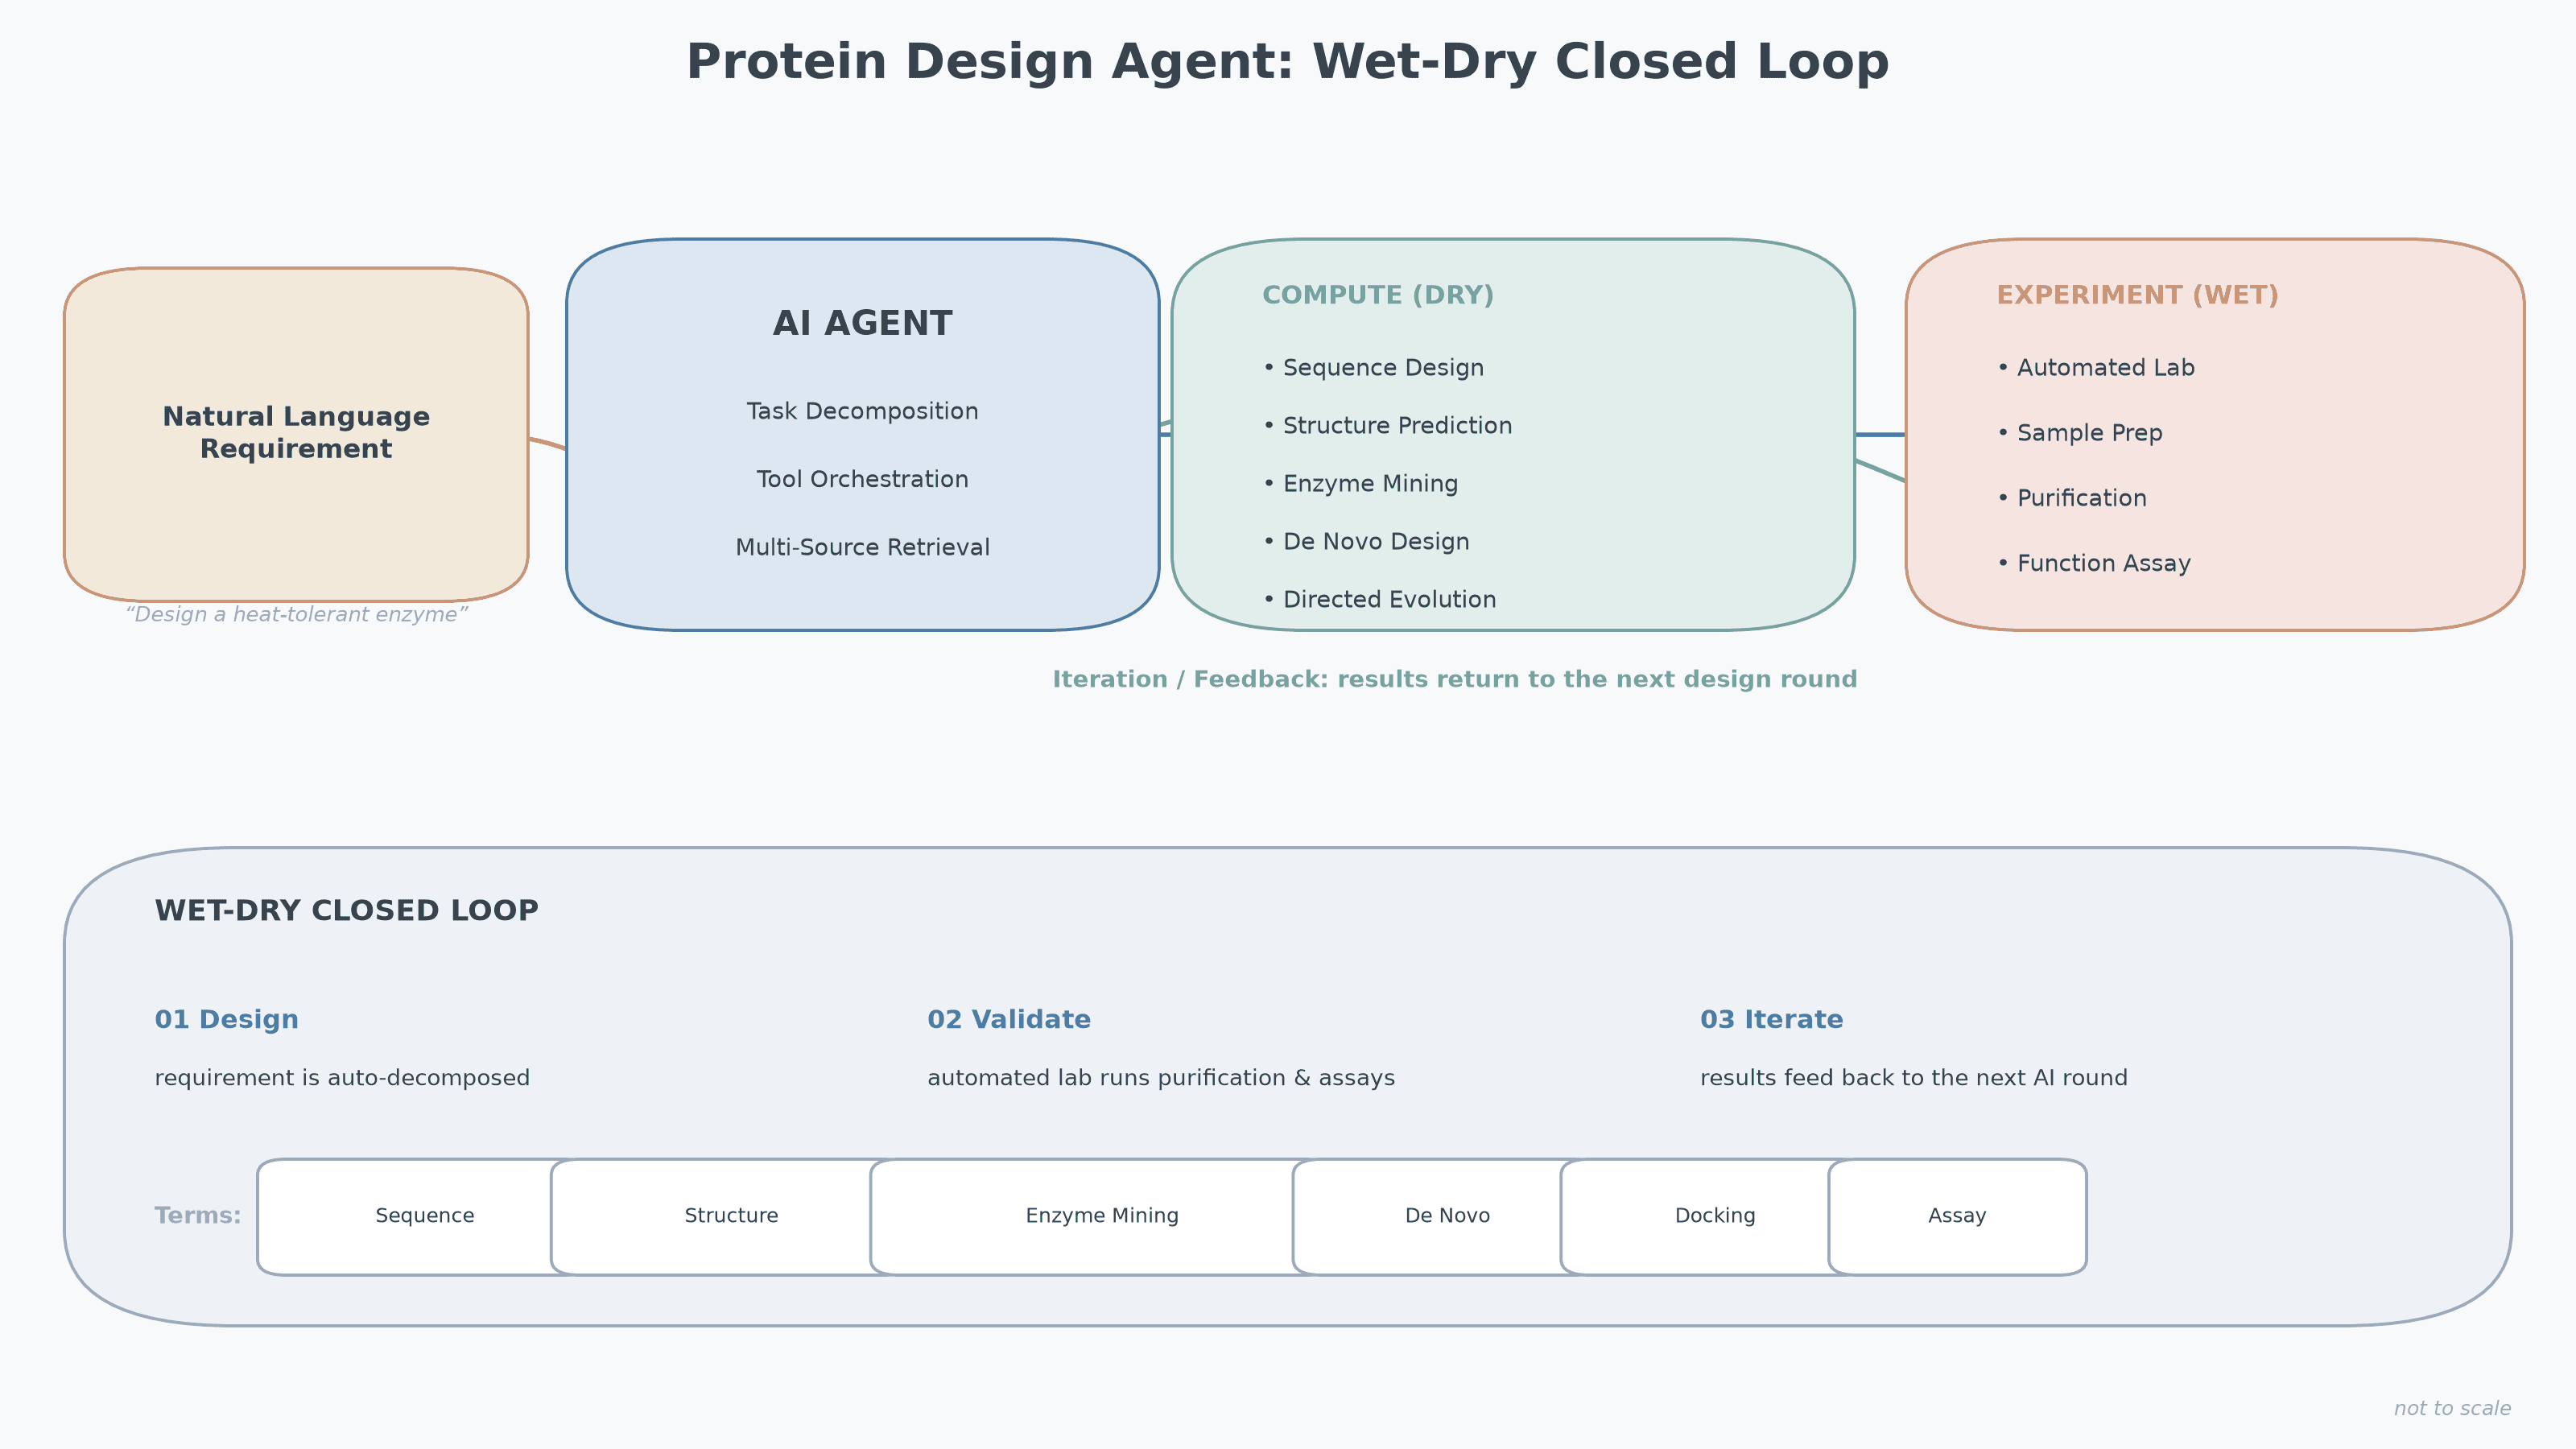
蛋白质设计智能体:AI驱动的对话式蛋白质研发
蛋白质设计智能体(Protein Design Agent)是以智能体(AI Agent)为核心的对话式蛋白质研发工具,用自然语言驱动序列设计、结构预测、酶挖掘与实验验证。本文从传统蛋白研发瓶颈切入,解析智能体概念与能力边界,介绍MatwingsVenus®(晓鹜®)的定位、核心能力与干湿闭环范式,并给出适用场景、客观局限与选型参考。
2026年11月10日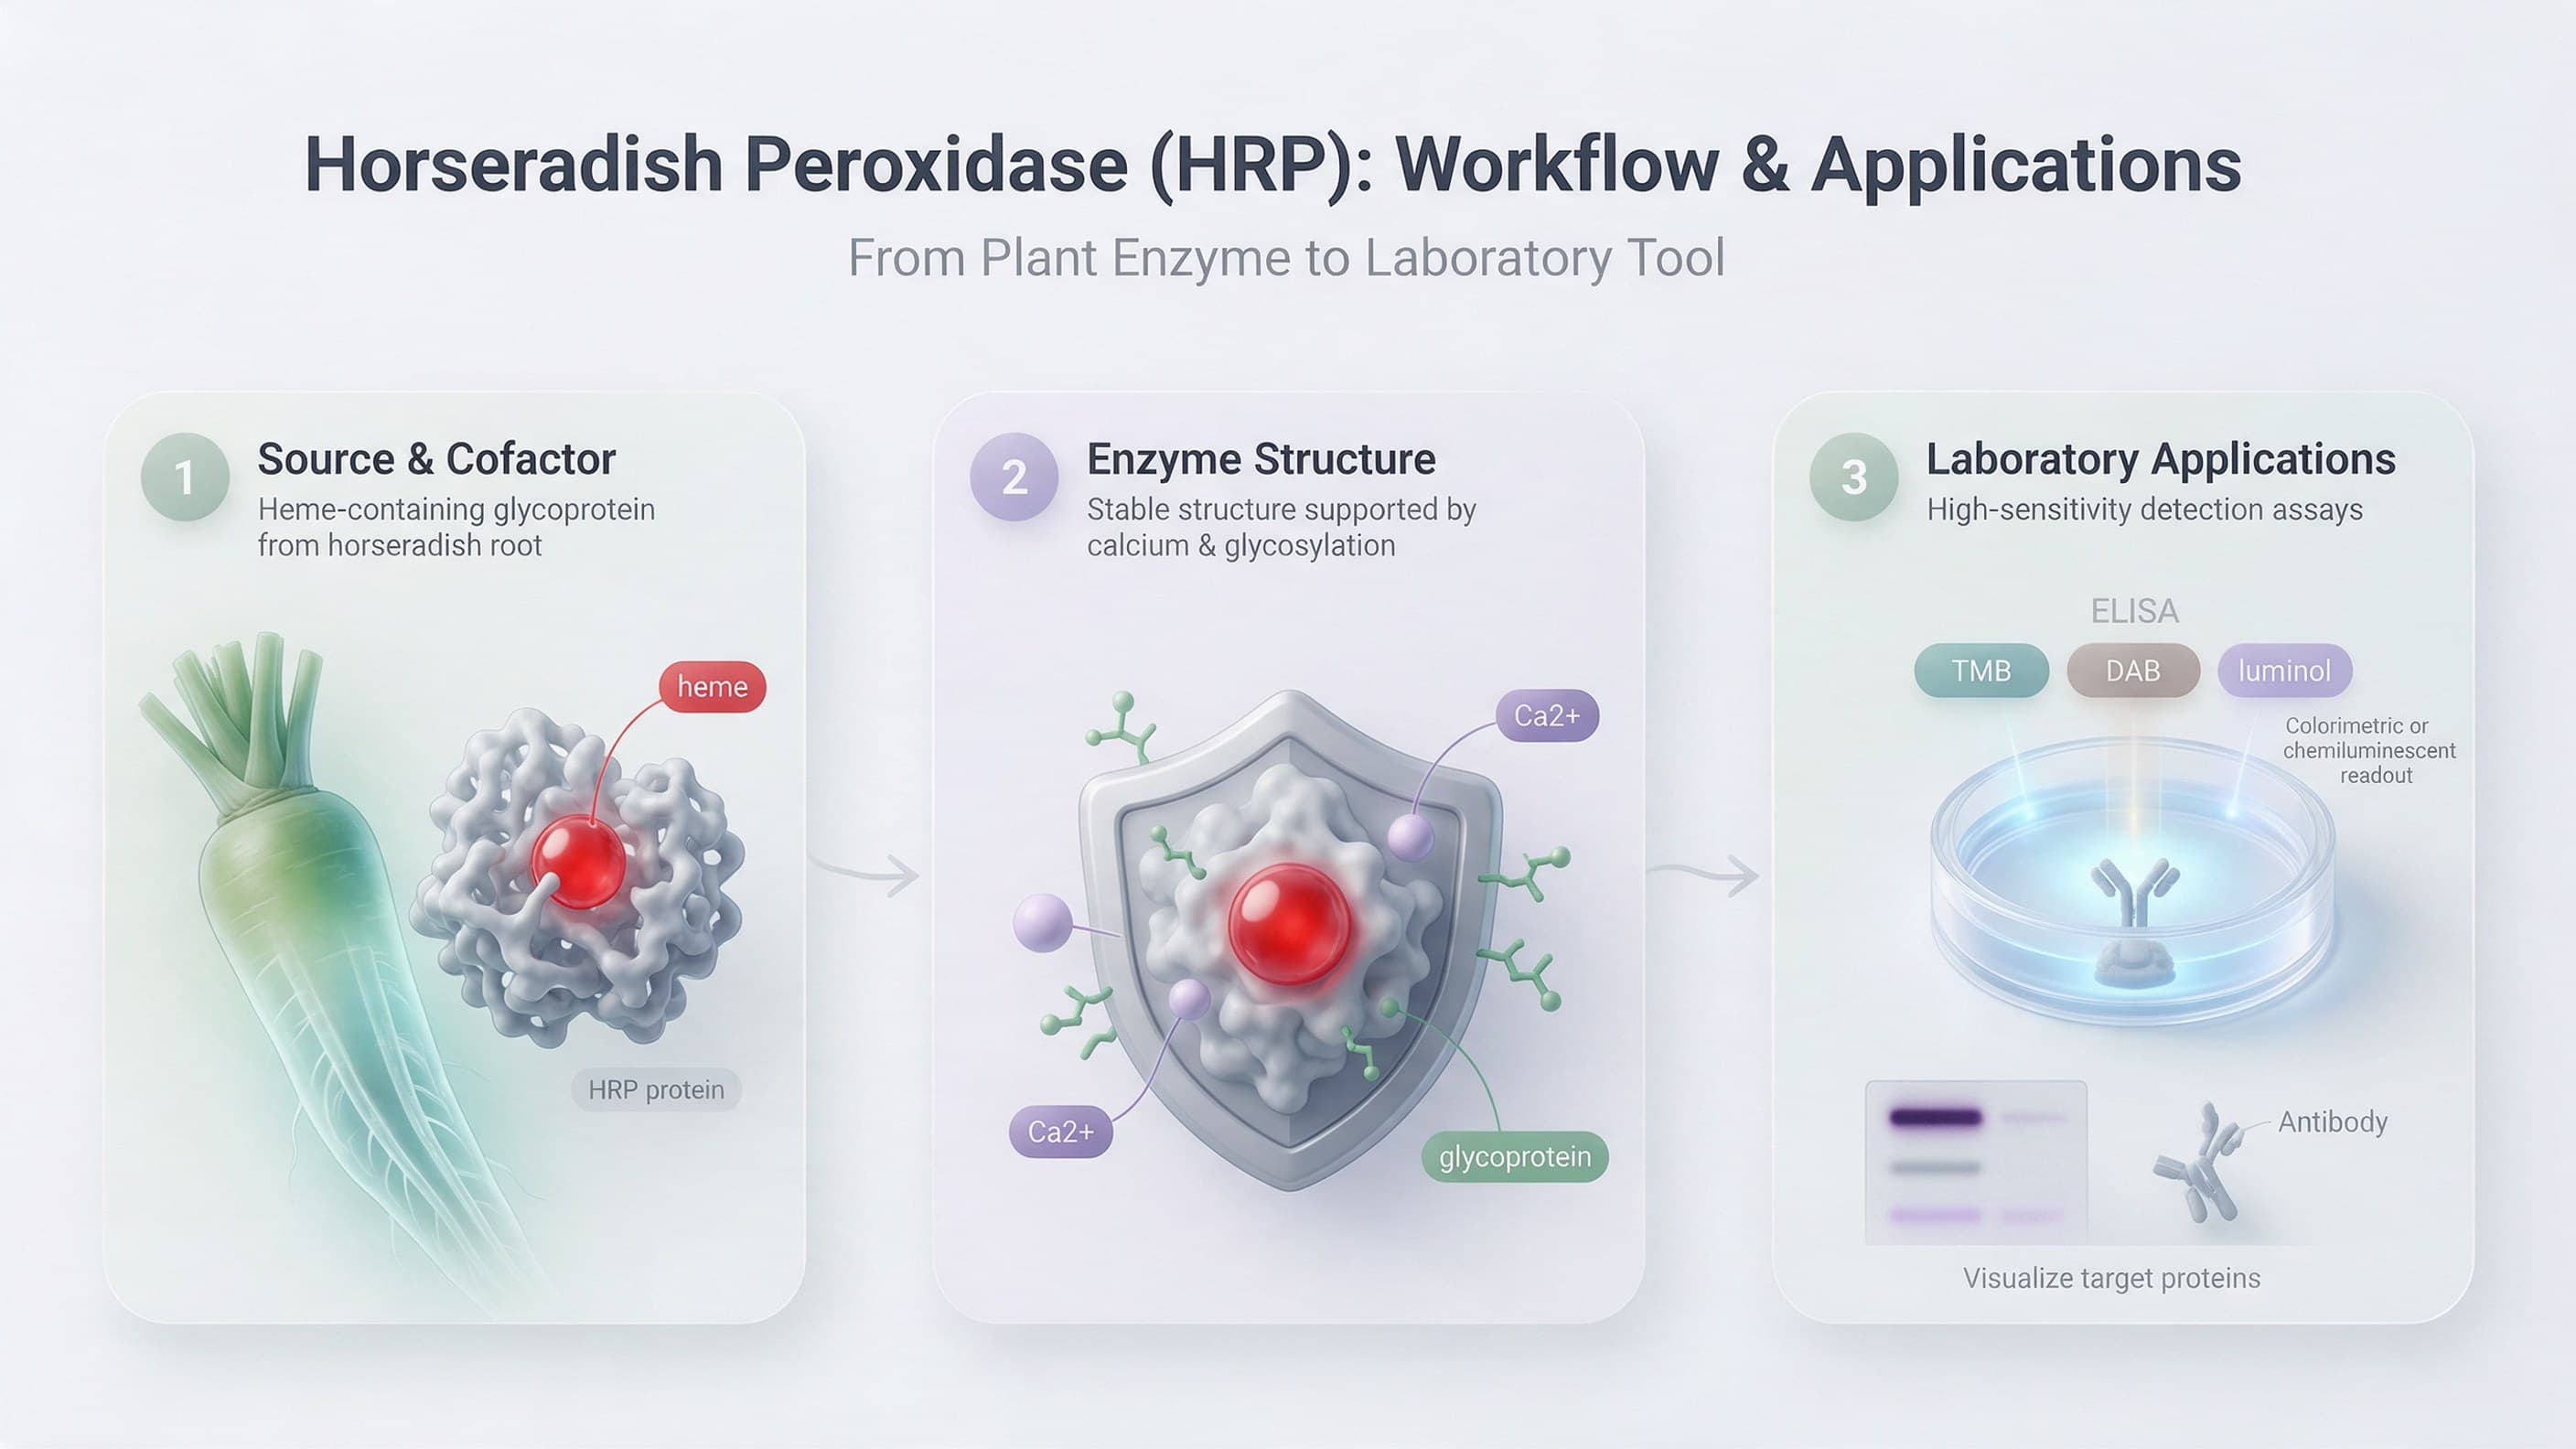
辣根过氧化物酶:血红素“信号放大枪”,从 ELISA 到免疫组化一文讲清
辣根过氧化物酶(Horseradish Peroxidase, HRP;EC 1.11.1.7)是一种含血红素辅基的糖蛋白工具酶,来自辣根(Armoracia rusticana)根部。它以过氧化氢为氧化剂,把多种供体底物氧化显色或发光,因而成为免疫检测中应用最广的酶标之一:ELISA、免疫组化、免疫印迹乃至生物传感器都离不开它。本文从“信号放大枪”的比喻切入,依次拆解其血红素催化核心、双钙离子稳定的结构、Compound I 到 Compound II 的三步催化循环、影响因子与工程化方向,最后落到工业化适配与选型逻辑,并简短过渡到晓鹜商城的定制工具酶开发能力。
2026年11月9日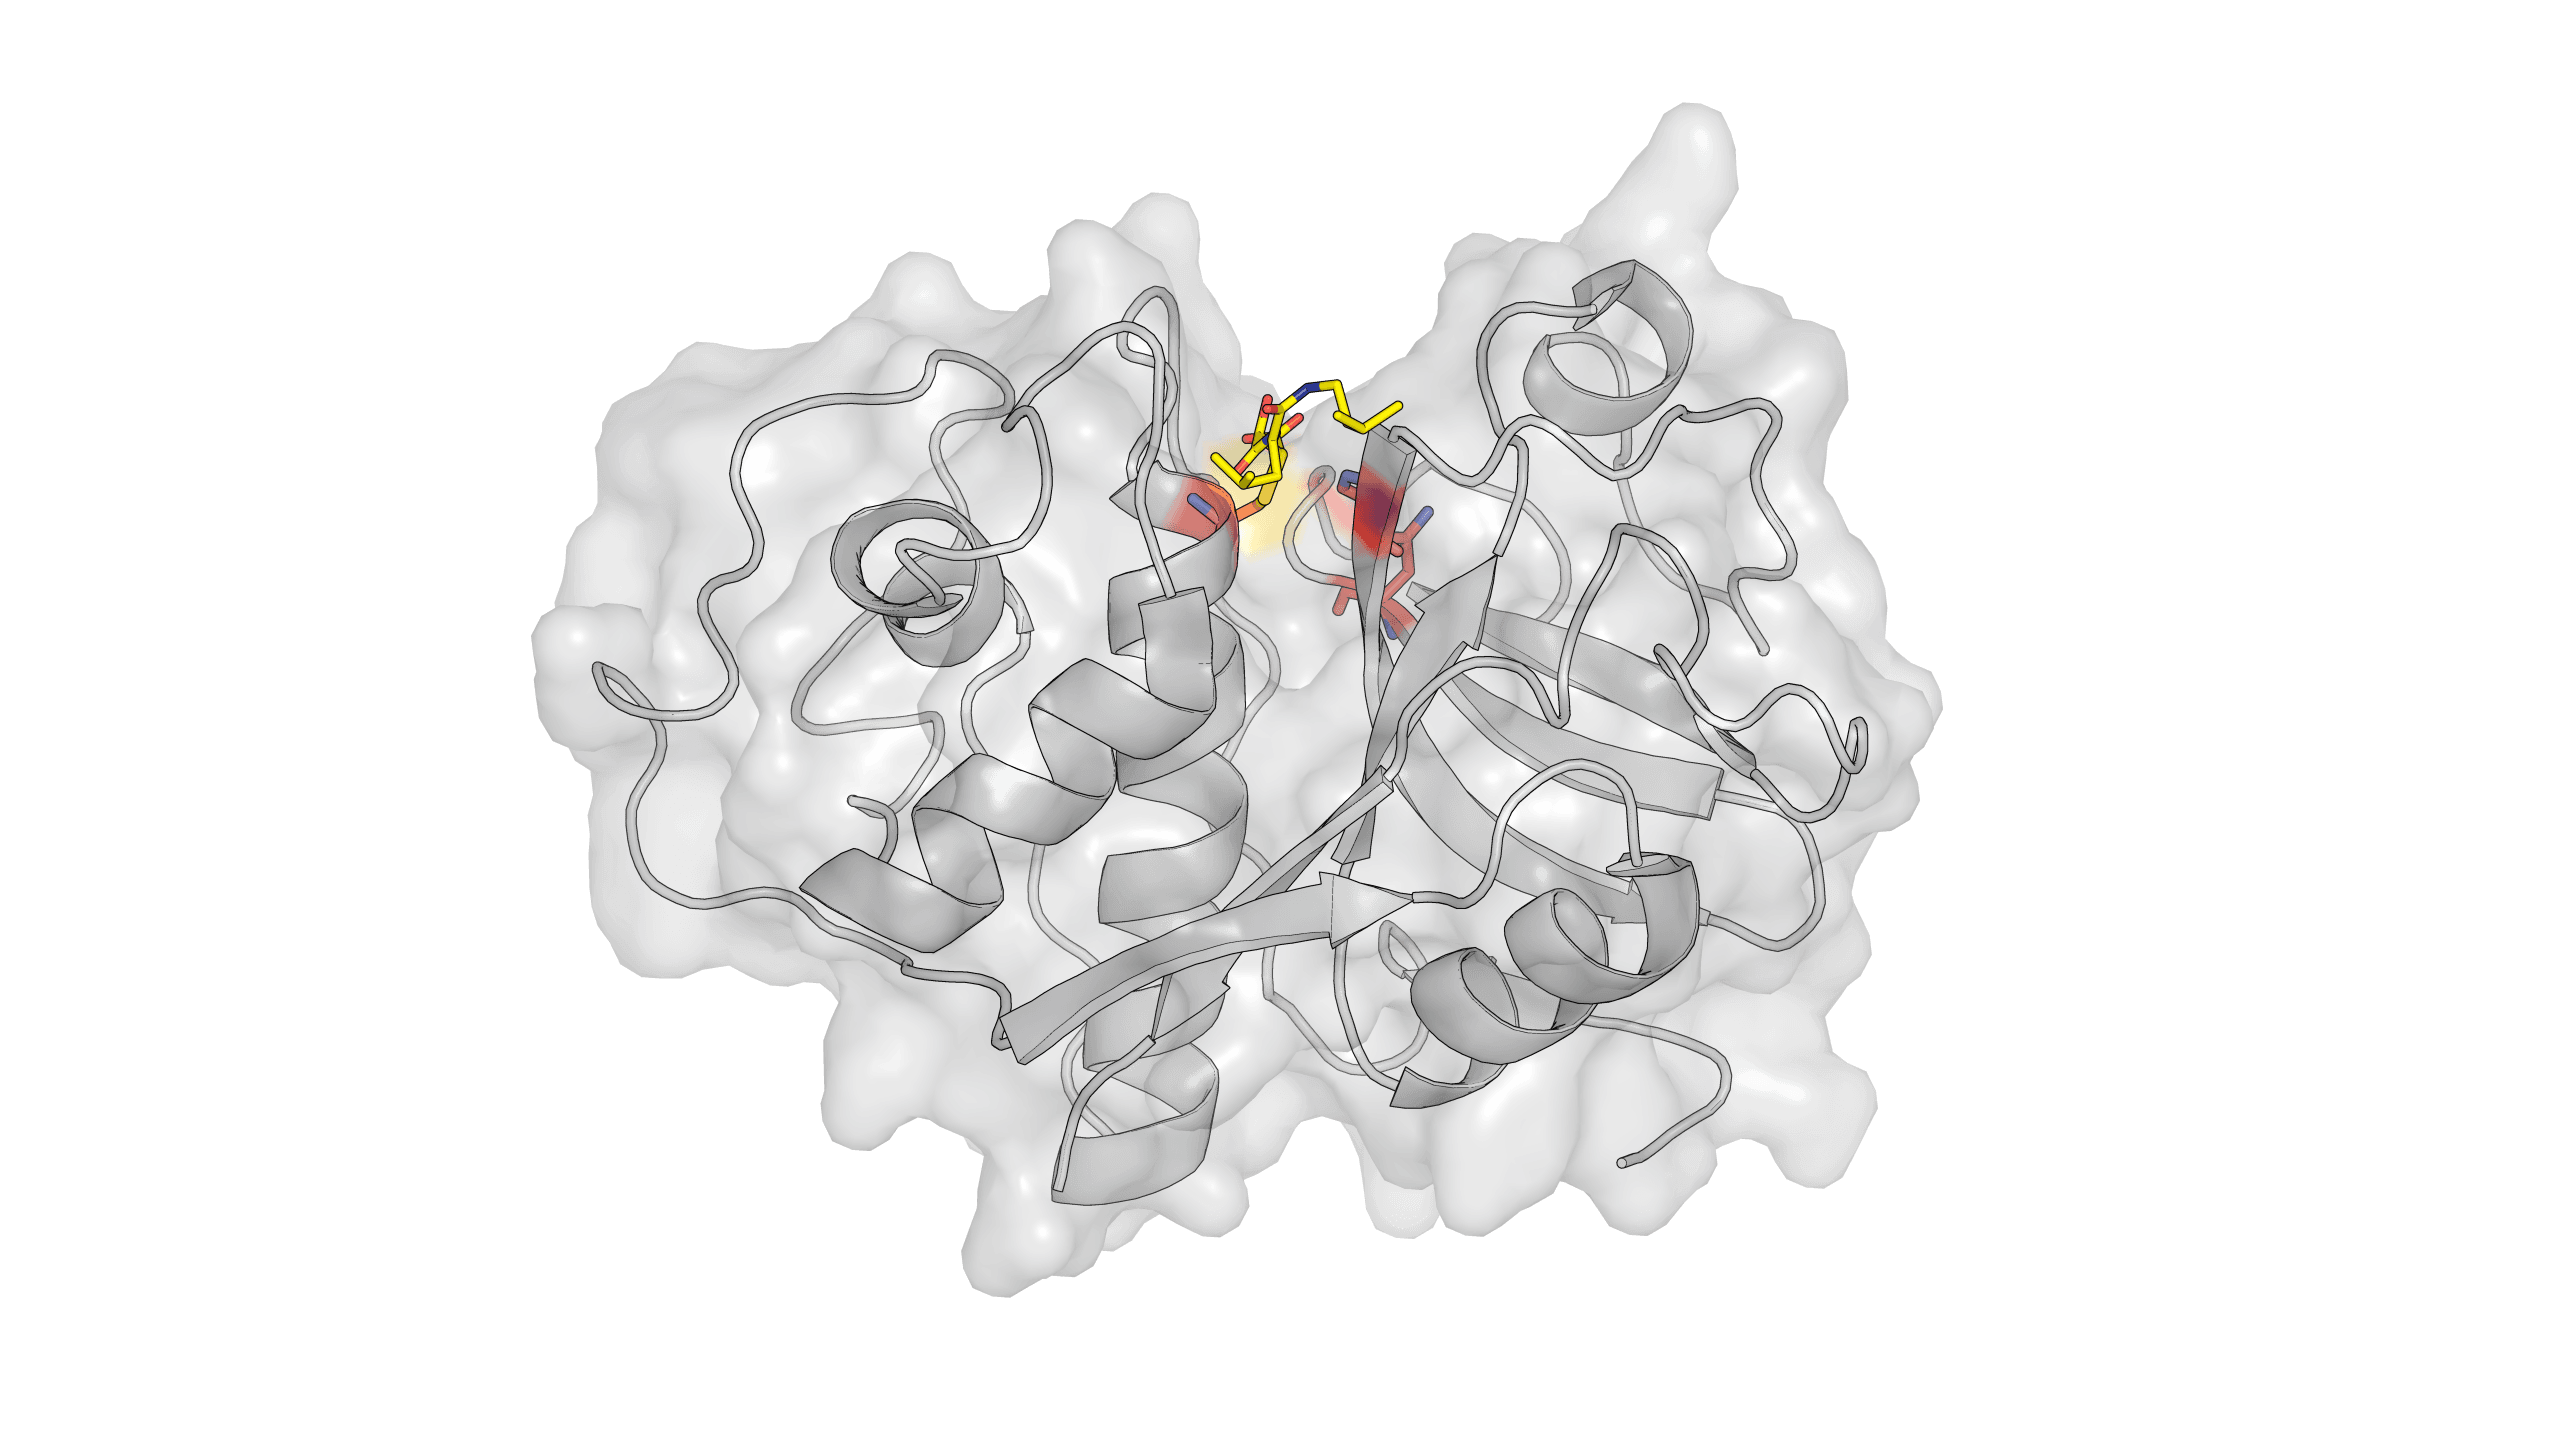
BRENDA酶活性数据查询:从EC编号到动力学参数
BRENDA酶活性数据查询是酶学研究与工业生物催化开发的基础步骤。本文介绍BRENDA(Braunschweig Enzyme Database,布伦瑞克酶数据库)的定位与数据分类,说明以EC编号、底物、生物体为入口查询Km、kcat、Ki、IC50及最适pH/温度的常见路径,并解释这些动力学参数如何用于酶工程与工艺条件设计,最后给出MatwingsVenus®(晓鹜®)如何帮助团队把酶活数据落到可验证的实验与生产环节。
2026年11月9日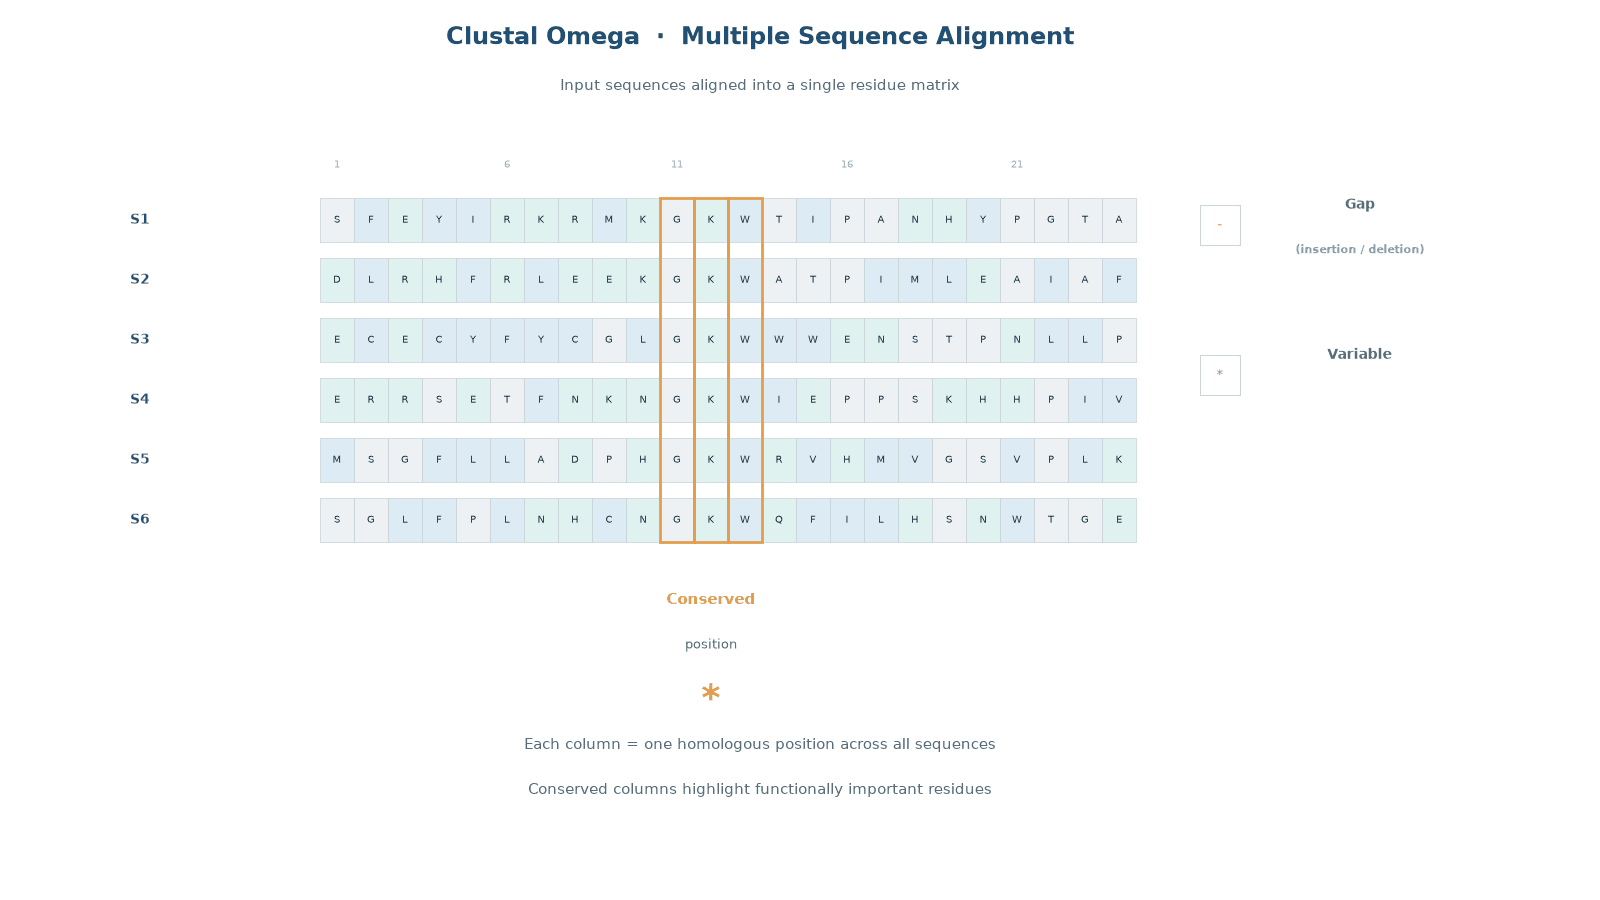
Clustal Omega序列比对:大蛋白家族快速精准分析
Clustal Omega是Clustal家族新一代的多序列比对(MSA)工具,专为大规模蛋白序列设计。它用mBed构建指导树、用HHalign对齐profile-HMM,兼顾速度与精度。相比ClustalW,Clustal Omega能处理成千上万条序列,常用于保守位点识别、结构域注释与进化分析。本文解析其核心原理、适用边界与使用要点,并说明它如何在蛋白工程流程中发挥作用。
2026年11月9日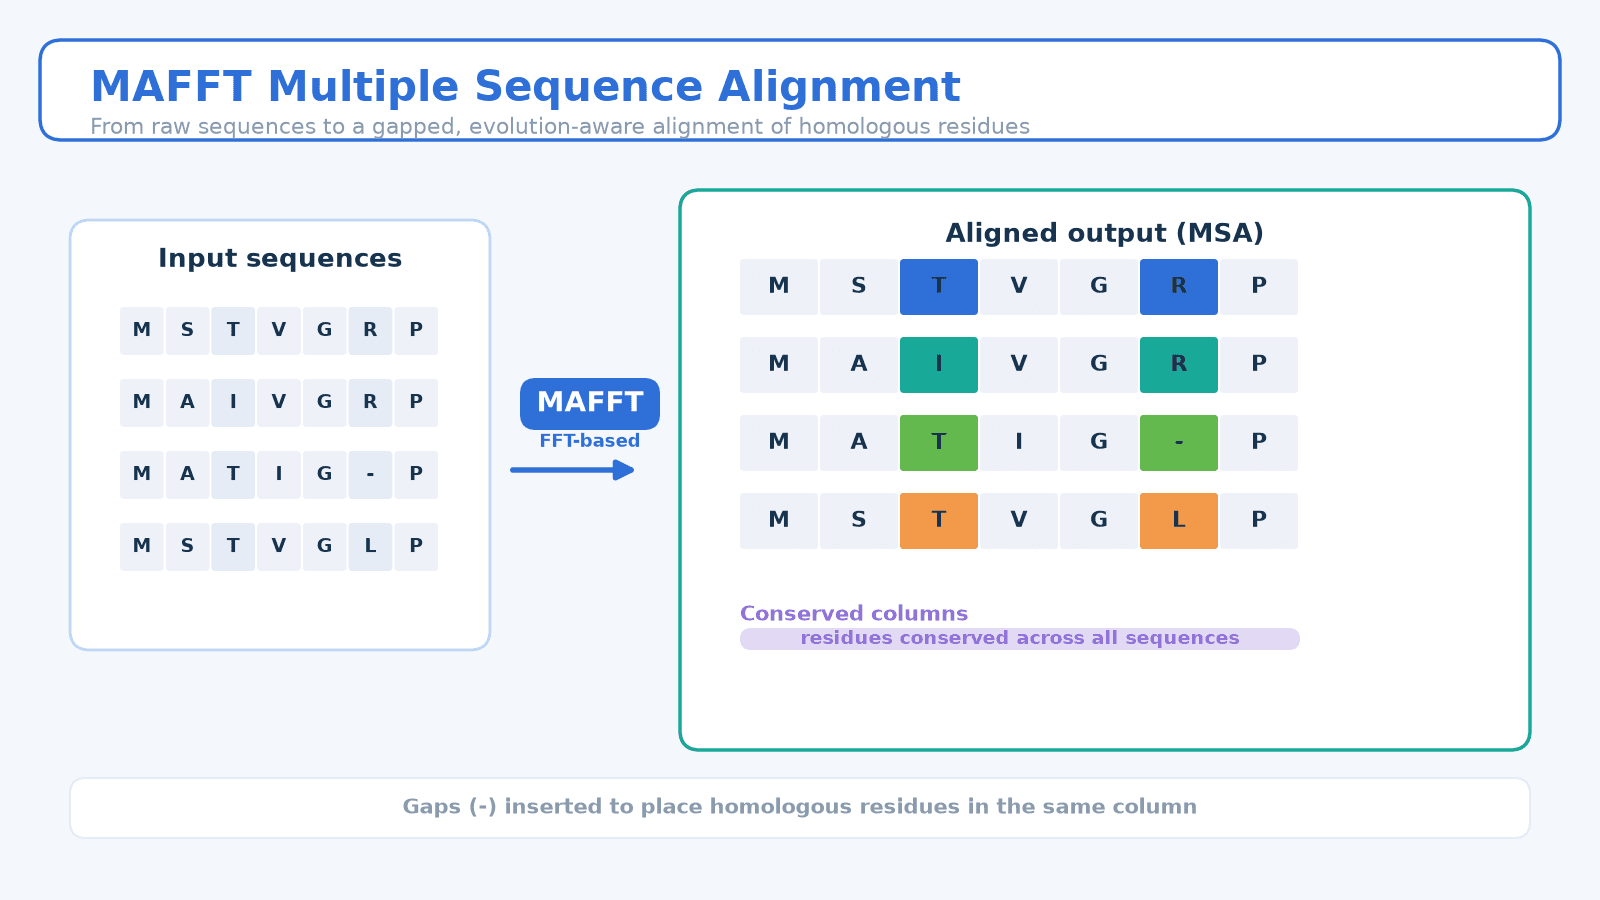
MAFFT多序列比对:快速傅里叶变换如何让同源序列对齐又快又准
MAFFT多序列比对(Multiple Alignment using Fast Fourier Transform,基于快速傅里叶变换的多序列比对)是一种高效的多序列比对算法,由大阪大学 Katoh 等人于2002年提出。它利用FFT快速定位同源区域,并借助渐进式与迭代精化兼顾速度与准确度,成为系统发育分析、保守位点识别与蛋白工程的前置步骤。本文详解MAFFT的五步流程、算法策略选型(L-INS-i、FFT-NS-2等)与关键参数,并解读其如何为AI蛋白工程提供进化先验。
2026年11月9日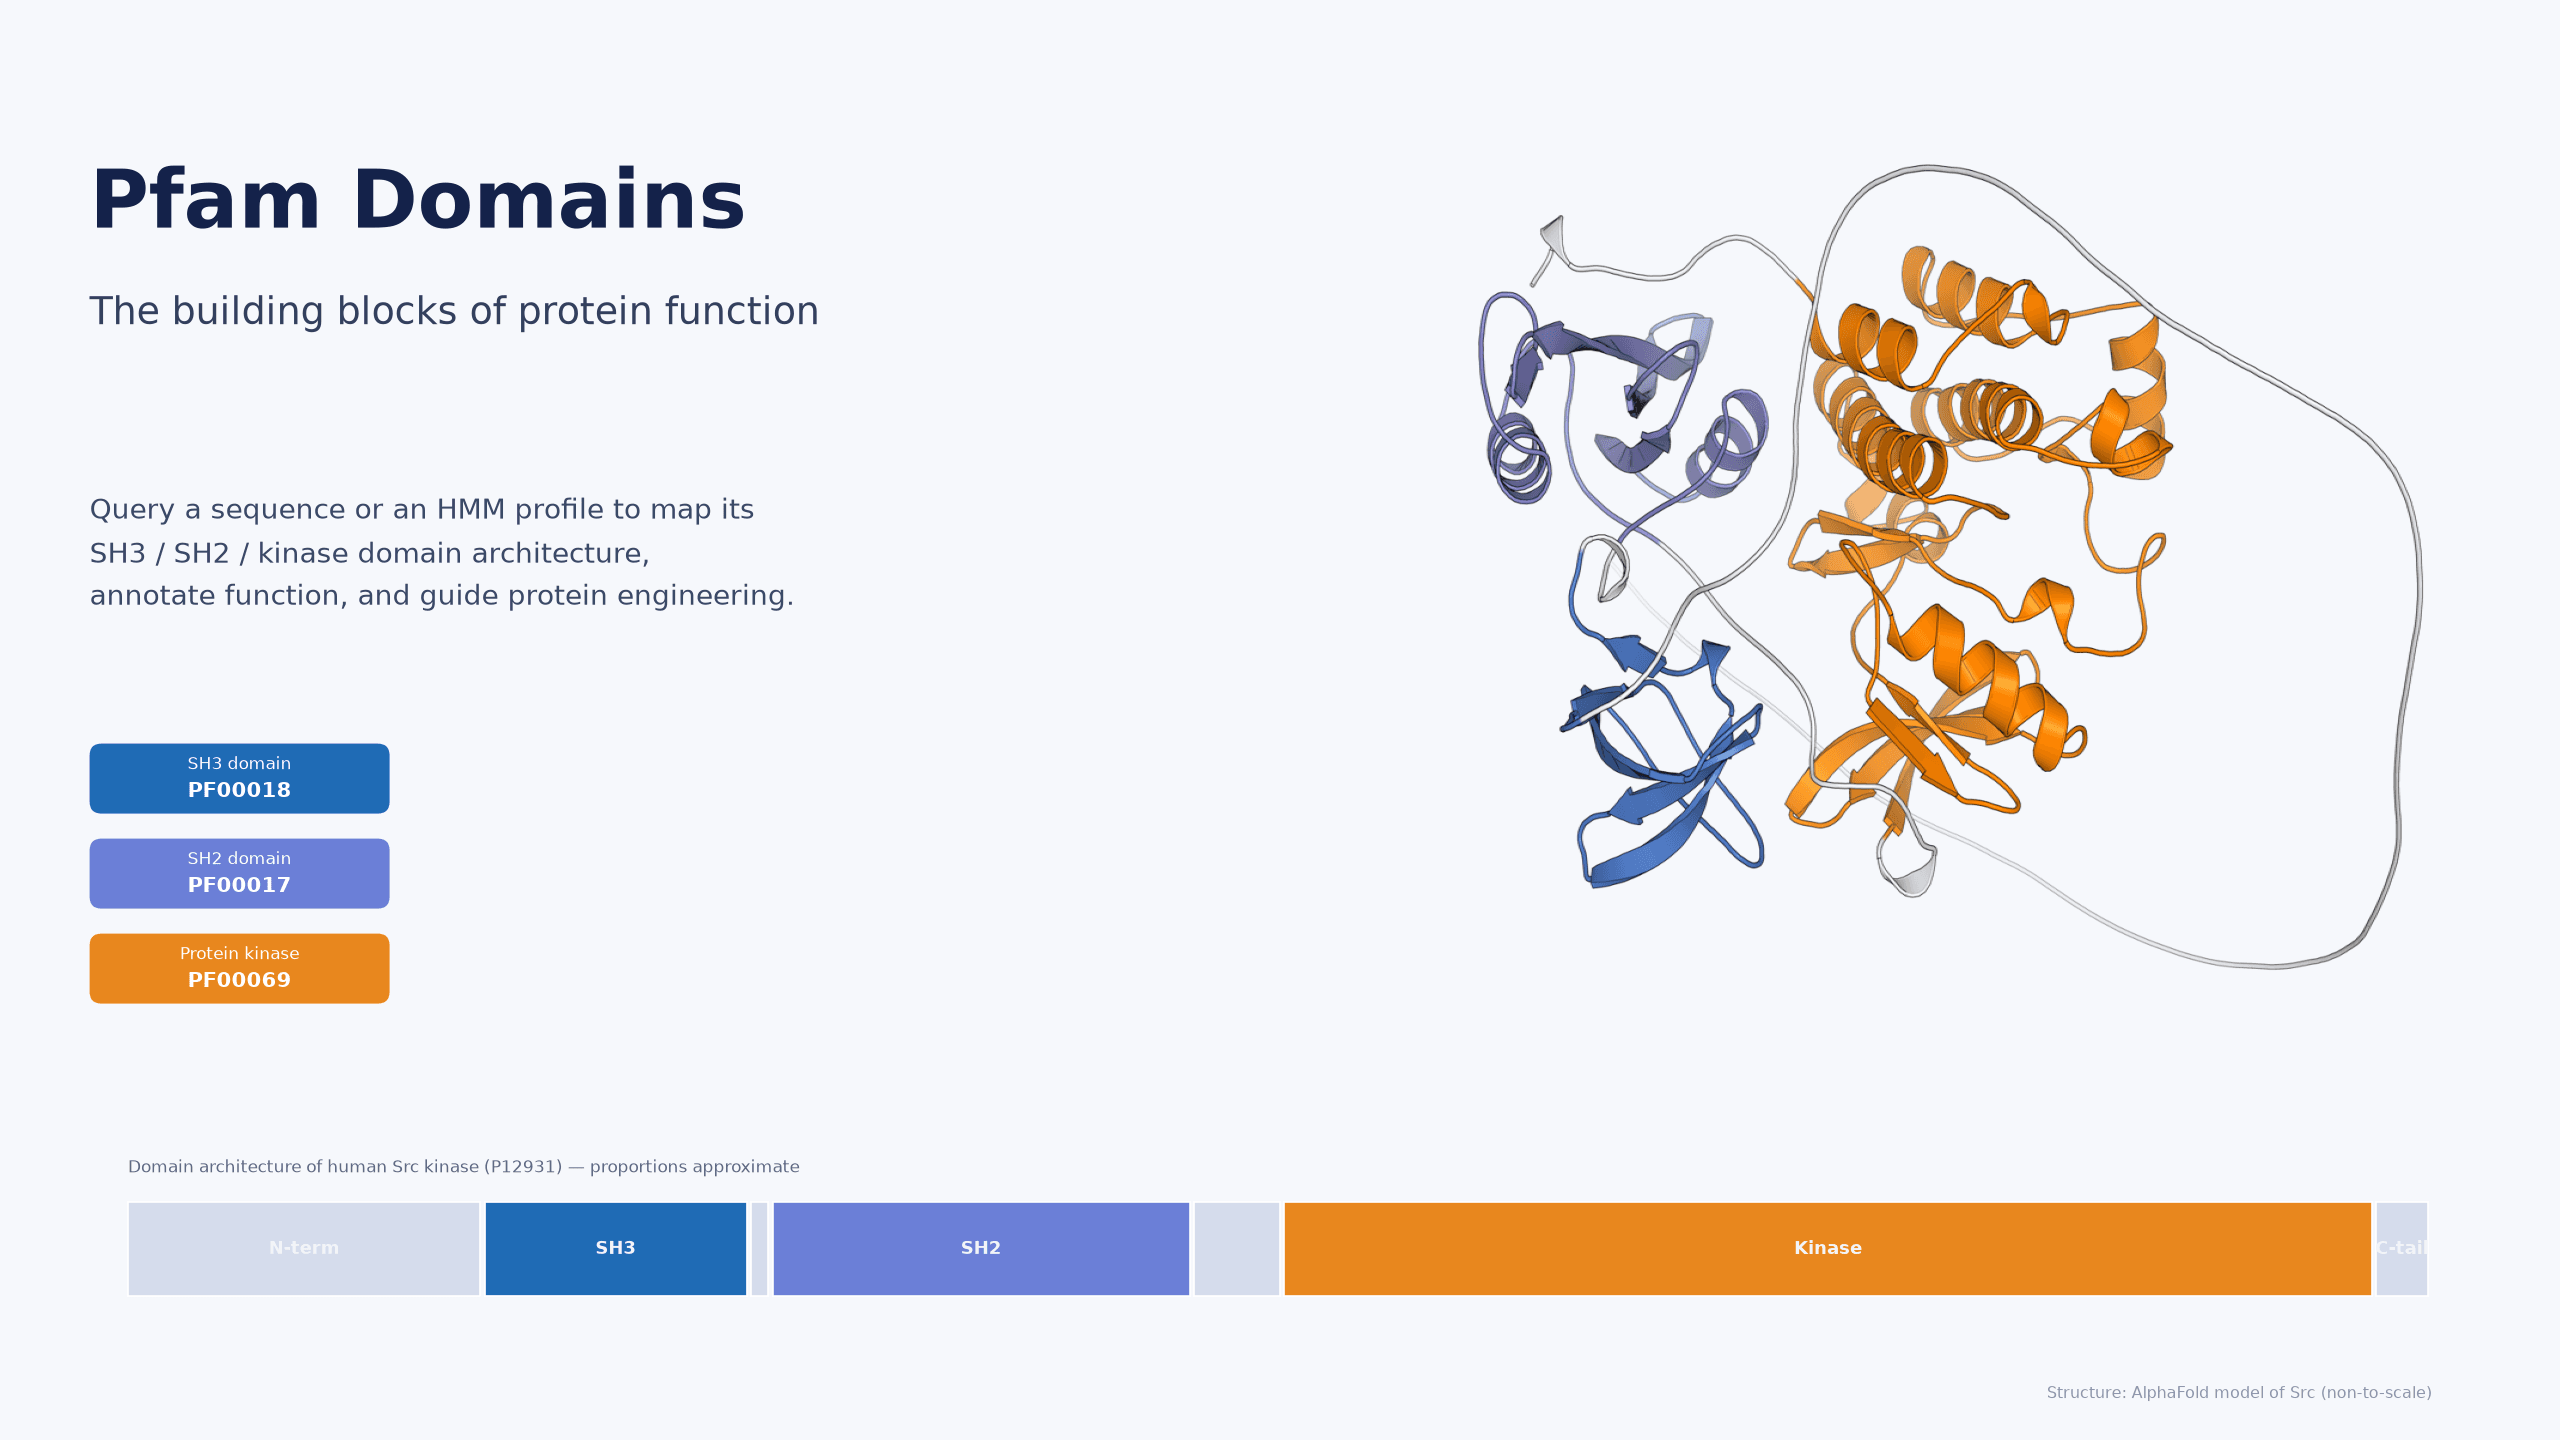
Pfam结构域查询教程:如何从序列定位蛋白功能模块?
本文是一篇面向科研与产业用户的 Pfam 结构域查询教程:从「蛋白质由结构域组成」这一背景讲起,介绍 Pfam/InterPro 家族、HMM 模型与 Clan 体系,再手把手演示如何用一条序列通过 InterProScan/HMMER 得到 SH3–SH2–Kinase 等结构域的注释,并解读 E-value、覆盖度与家族类型,最后落到蛋白工程应用与 MatwingsVenus®(晓鹜®)干湿闭环。
2026年11月9日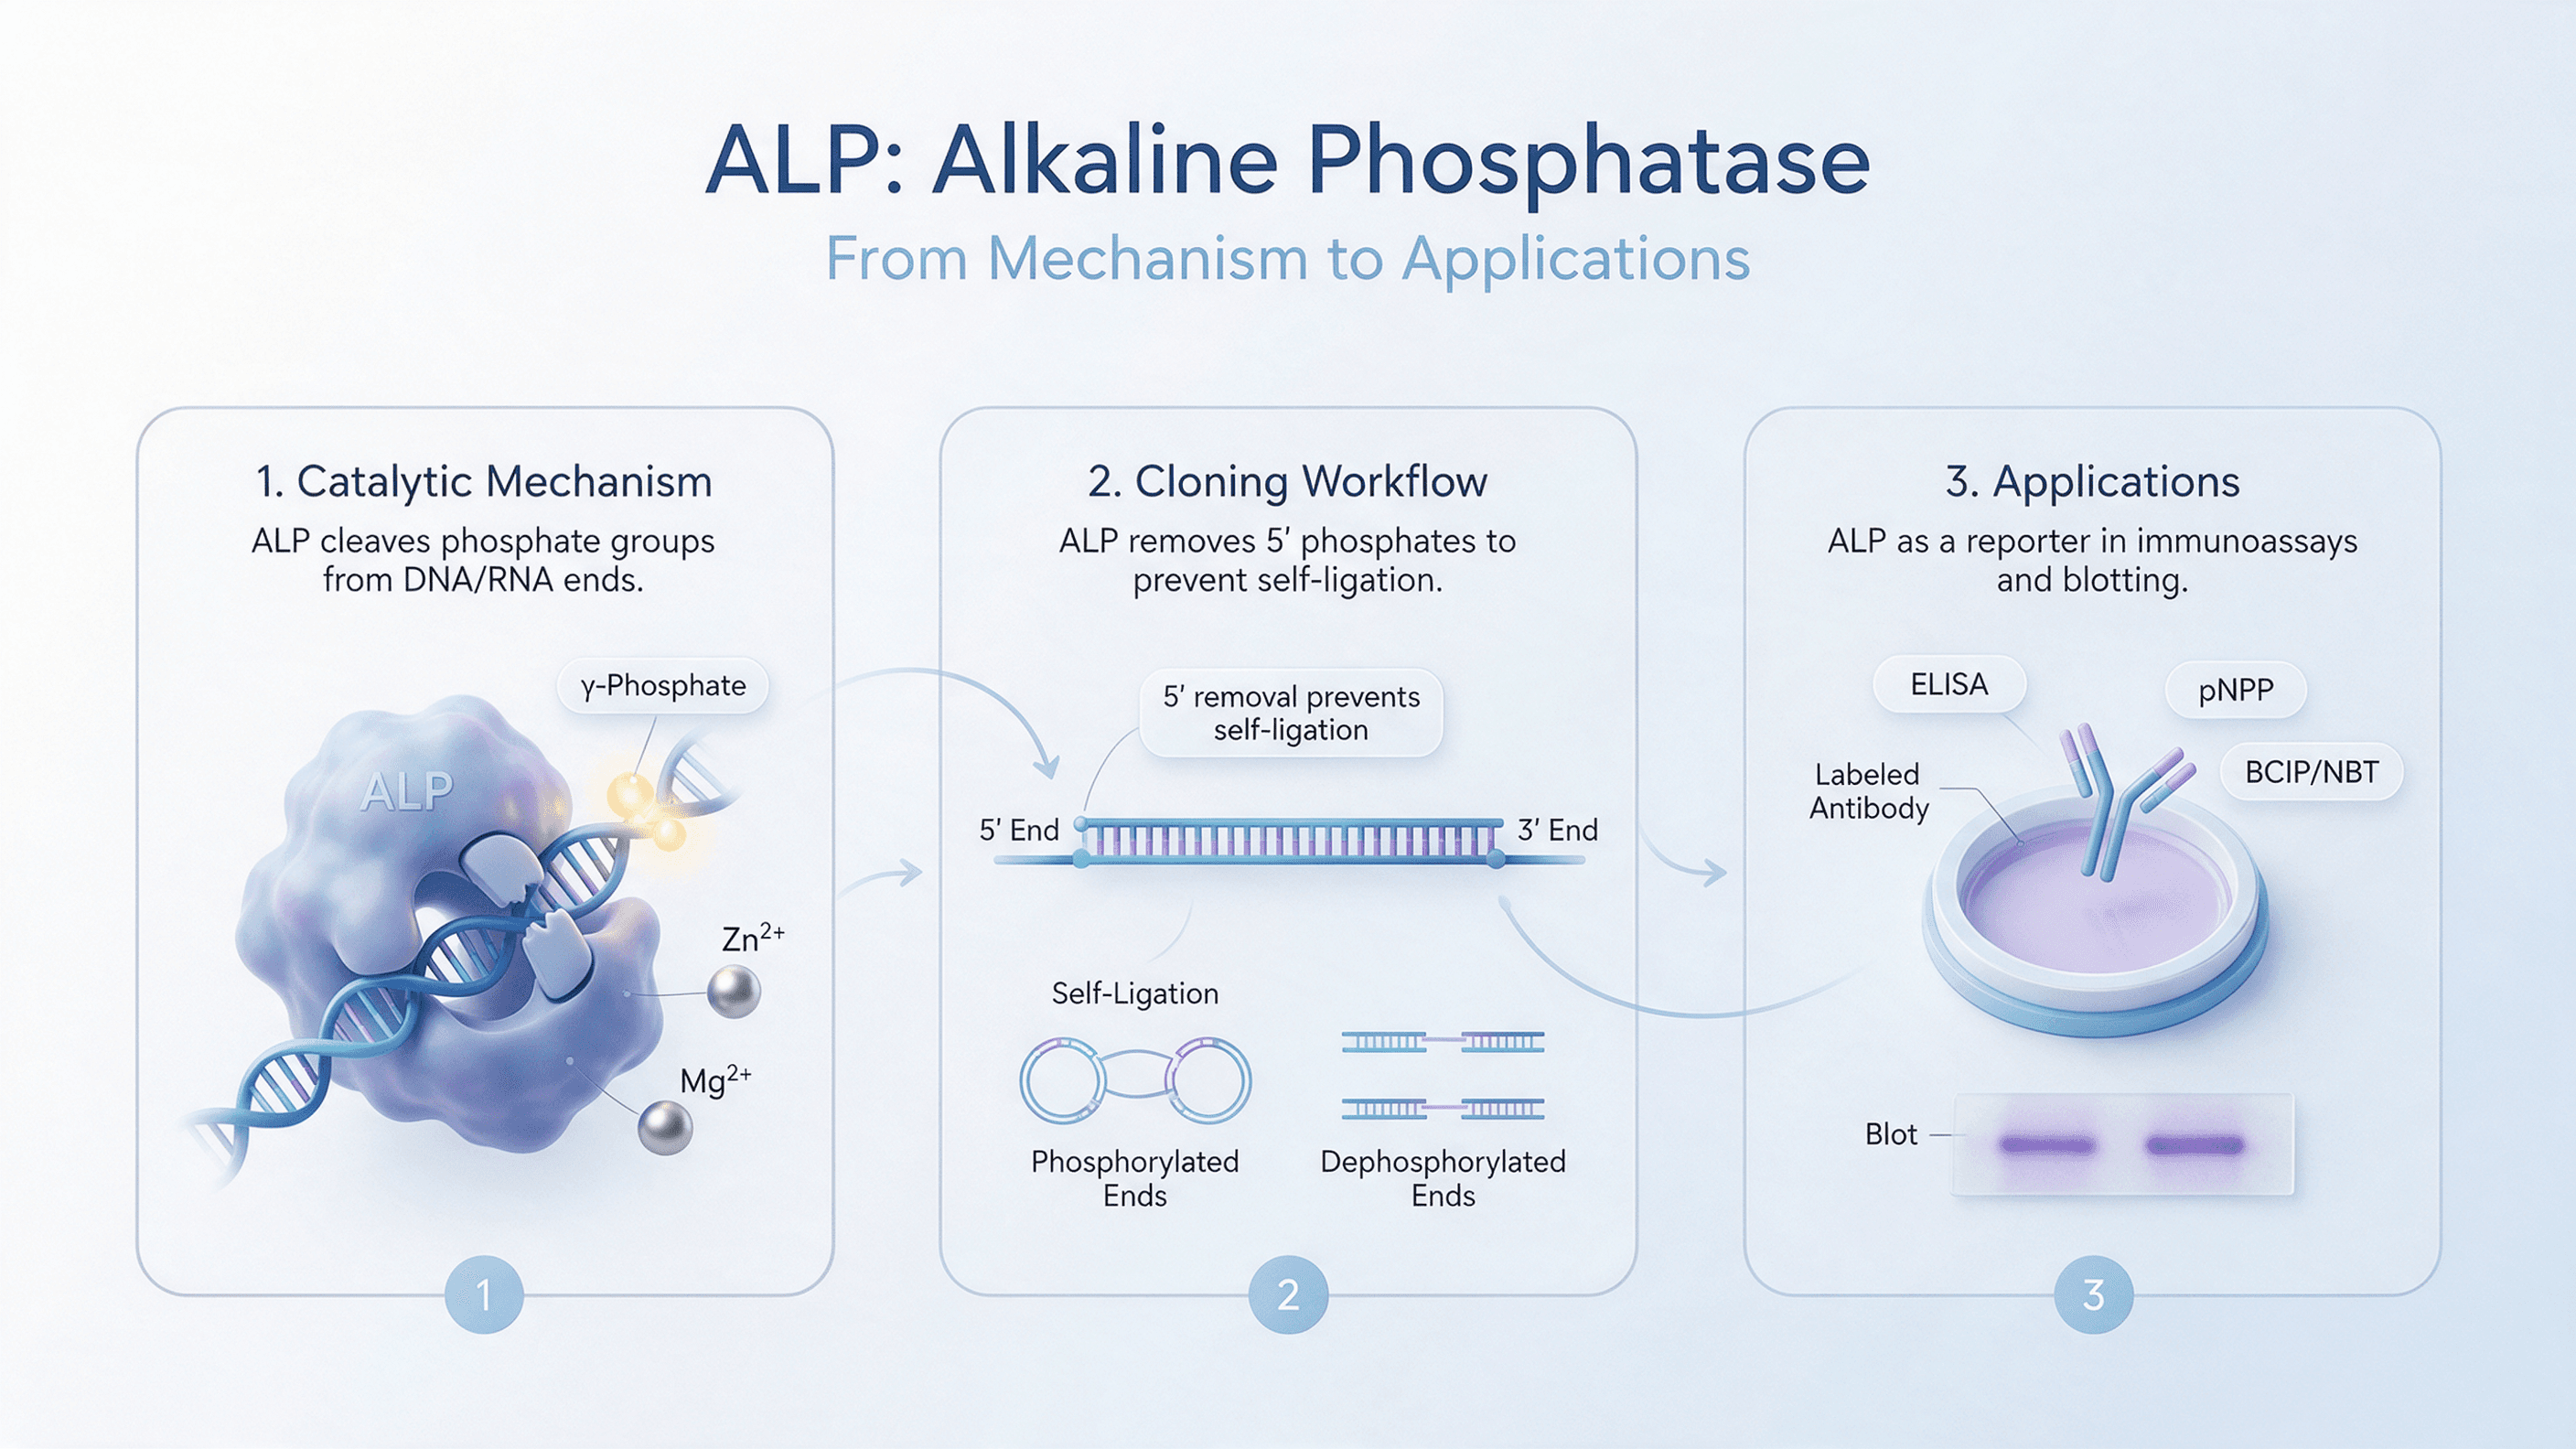
碱性磷酸酶到底怎么选?CIP、rAP、SAP、BAP四条路一次讲清
碱性磷酸酶(Alkaline Phosphatase, ALP;EC 3.1.3.1)是一类在偏碱条件下催化磷酸单酯水解、把磷酸基团从底物上“剪除”的酶。它在分子克隆中负责去除载体5'端磷酸、抑制自连以提升阳性克隆率,在免疫检测与印迹显色中作为高灵敏度酶标,也常在临床检验中用于肝胆与骨代谢相关指标。
2026年11月9日
如何用InterPro做蛋白质功能分析?从序列到功能注释
InterPro蛋白质功能分析通过整合多个成员数据库的签名(signature)识别蛋白家族、结构域与功能位点,是序列功能注释与后续湿实验验证之间的可信桥梁。
2026年11月8日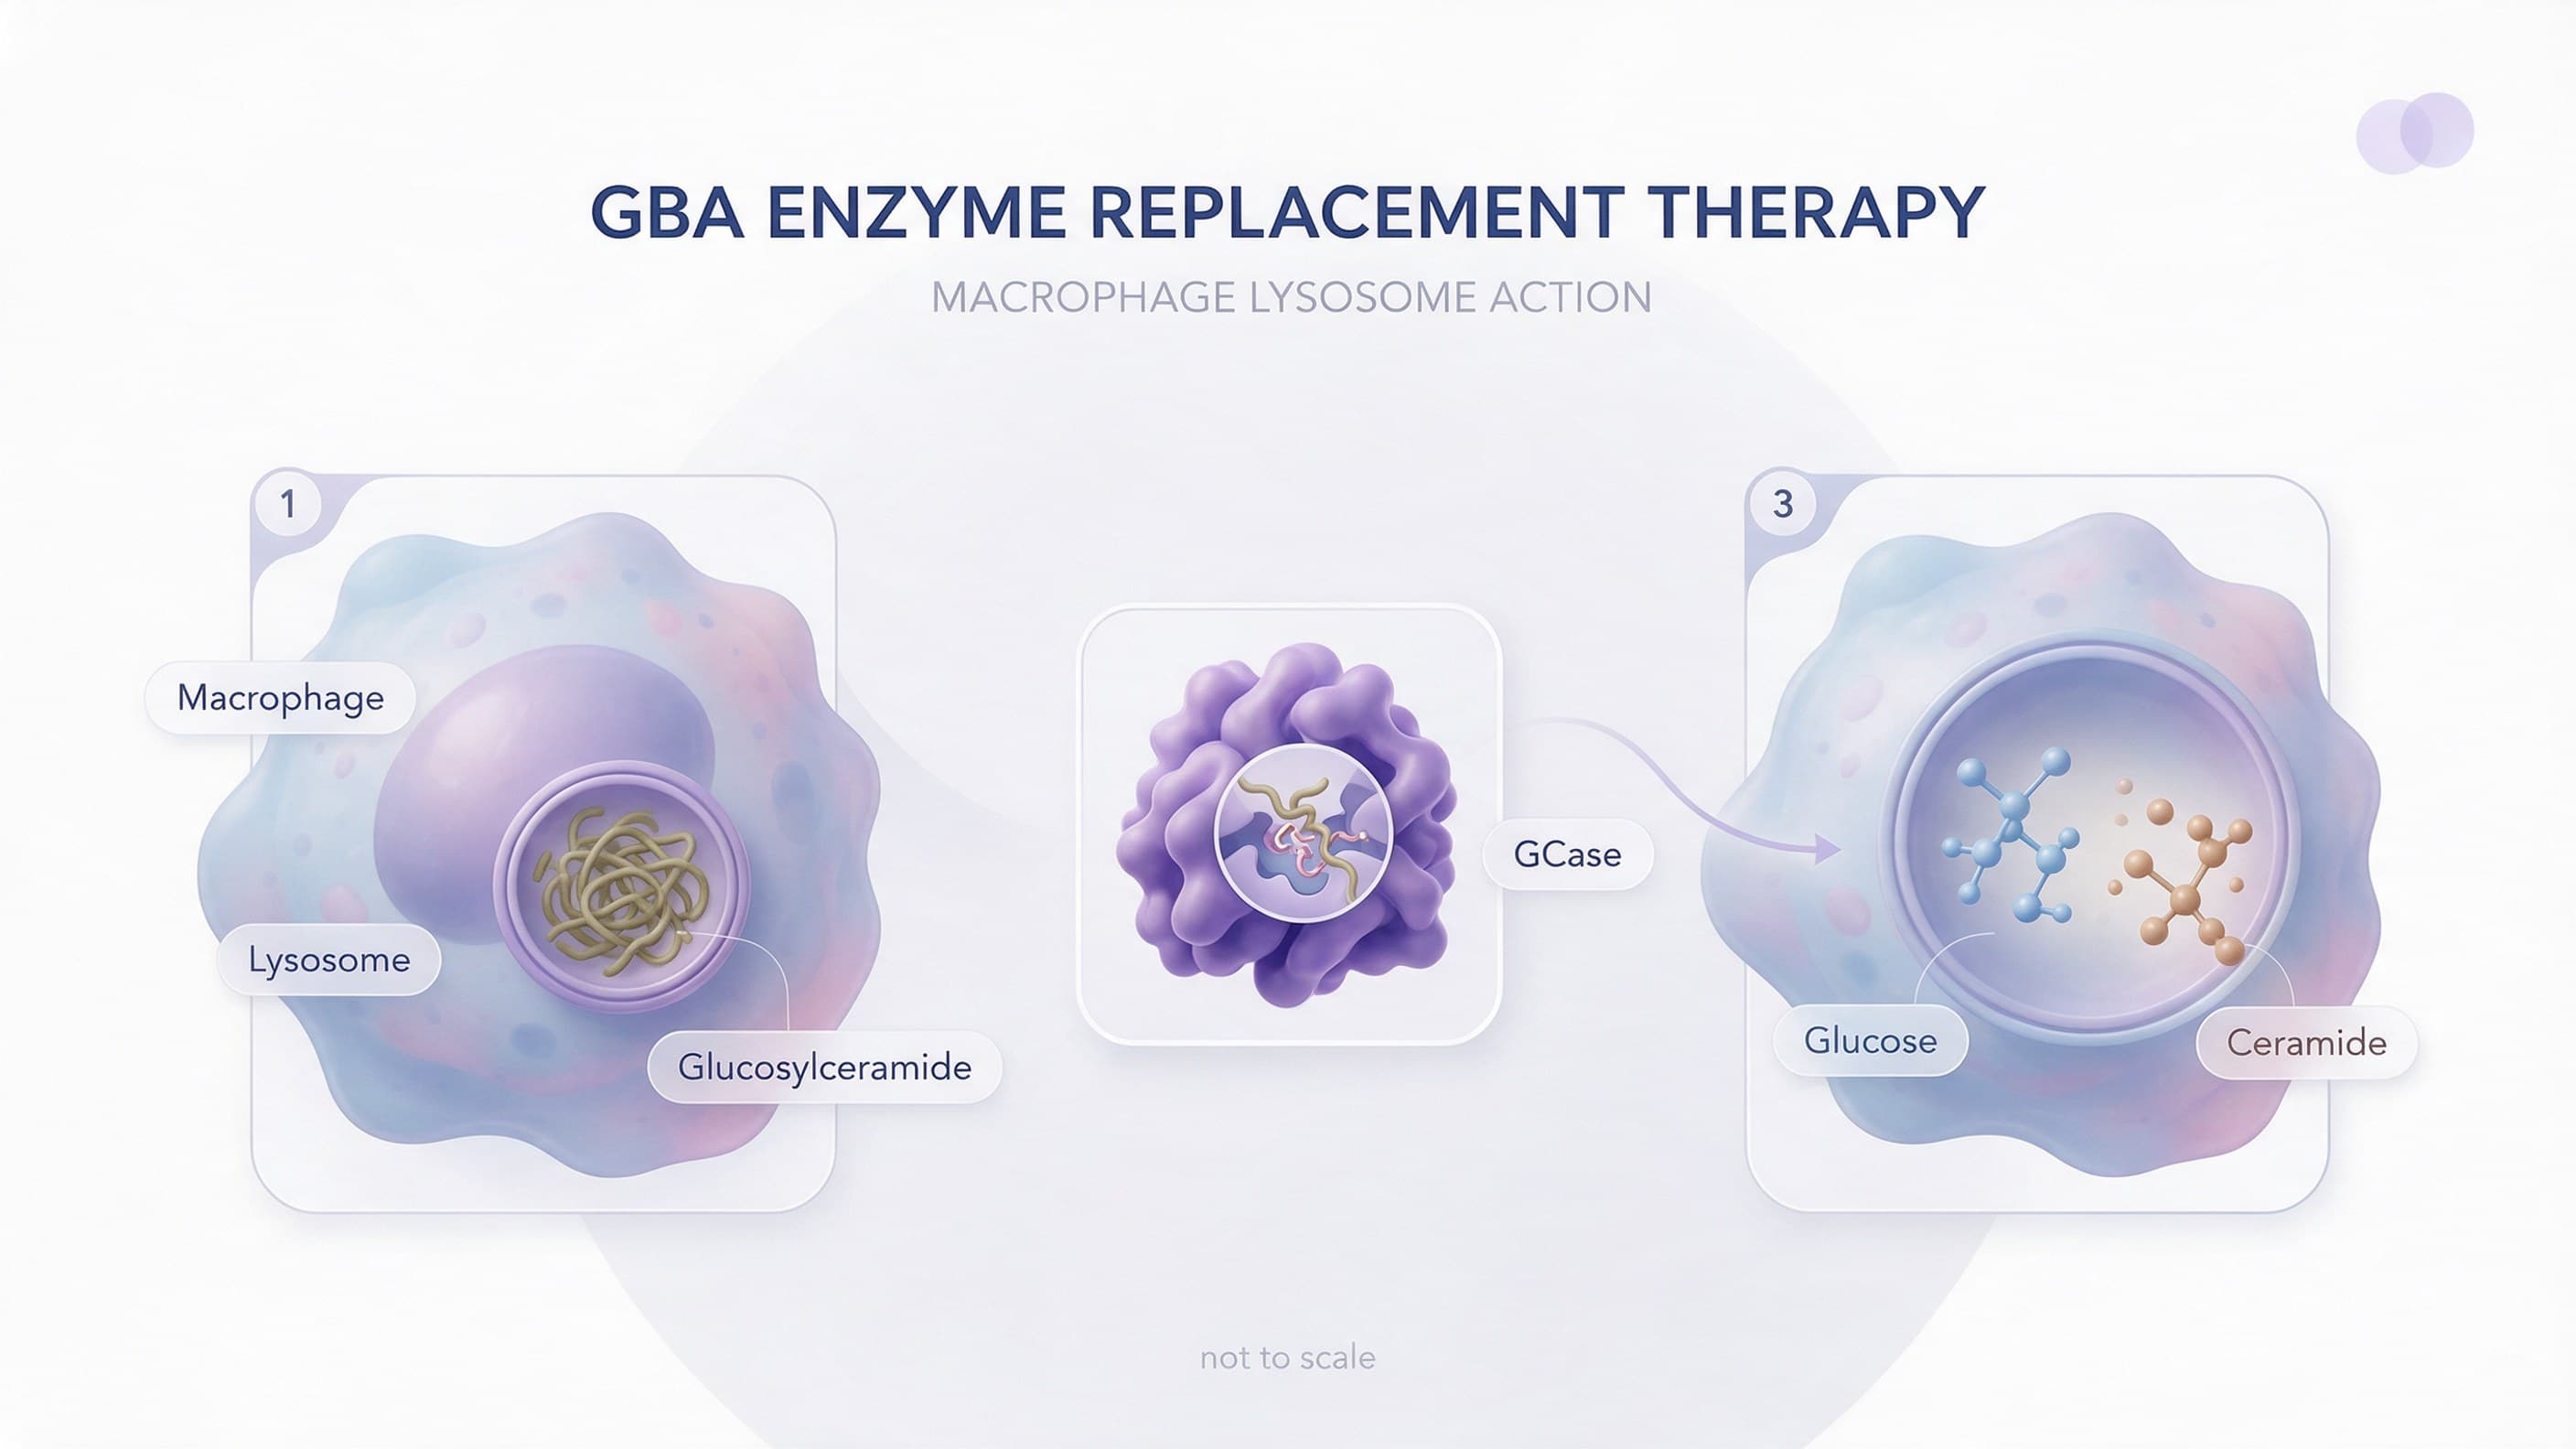
葡糖脑苷脂酶:把葡糖脑苷脂"拆解"的溶酶体酶
葡糖脑苷脂酶(glucocerebrosidase,EC 3.2.1.45,又称酸性β-葡萄糖苷酶、GBA/GCase)是一种定位在溶酶体膜上的exo-β-葡萄糖苷酶,负责把葡糖脑苷脂(glucosylceramide)水解为葡萄糖与神经酰胺。其活性依赖激活蛋白Saposin C与负电荷脂质,最适pH约5.5,采用保持型水解机制。GBA1基因缺陷会导致葡糖脑苷脂在巨噬细胞中堆积,引发戈谢病。酶替代治疗(ERT)通过外源补充重组酶来降低脂质堆积,代表产品包括imiglucerase、velaglucerase alfa与taliglucerase alfa。对研发与采购而言,核心是把表达体系、糖基化改造、免疫原性、酶活与批间一致性纳入同一评价框架。
2026年11月8日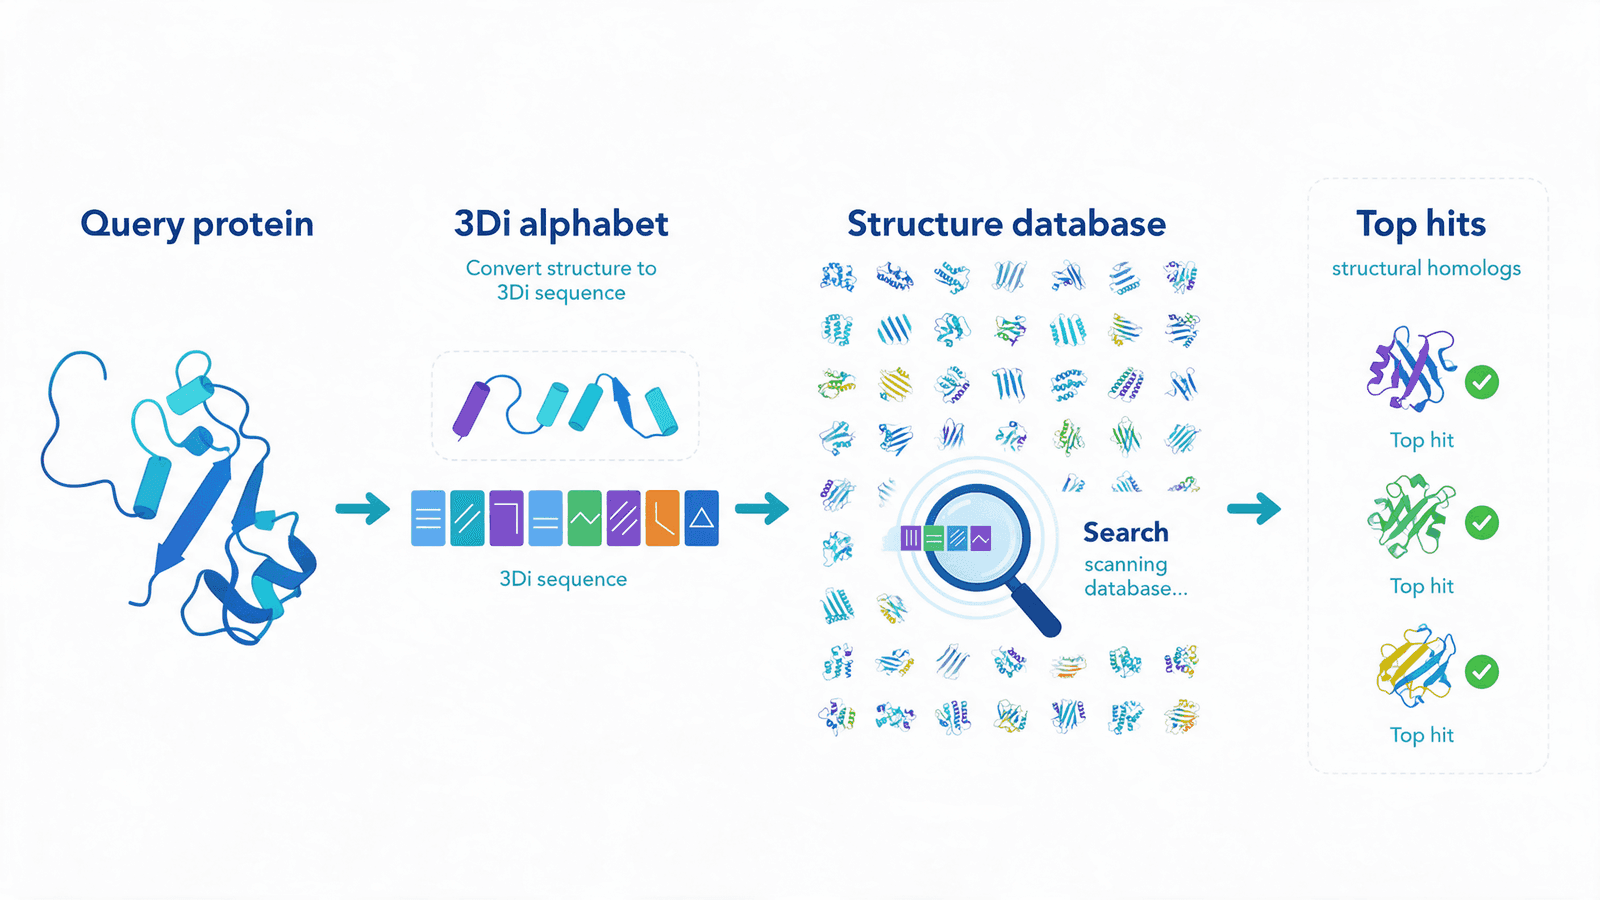
什么是Foldseek 结构搜索?为什么它能把蛋白质结构比对做到毫秒级?
Foldseek 是一种用 3Di 结构字母表实现快速蛋白质结构搜索的工具,它把蛋白质的三维结构"翻译"成可由计算机快速比对的字符串,从而在秒级内扫描数百万条结构。相比传统结构比对(TM-align、Dali、CE),Foldseek 将计算速度提升 4–5 个数量级,同时保持 Dali 的 86%、TM-align 的 88% 和 CE 的 133% 的灵敏度。本文讲清 Foldseek 结构搜索的原理、速度与灵敏度基准、安装与命令行用法、技术选型与实践技巧,并说明它如何与蛋白工程平台结合,用于远缘同源检测、功能注释与设计闭环。
2026年11月8日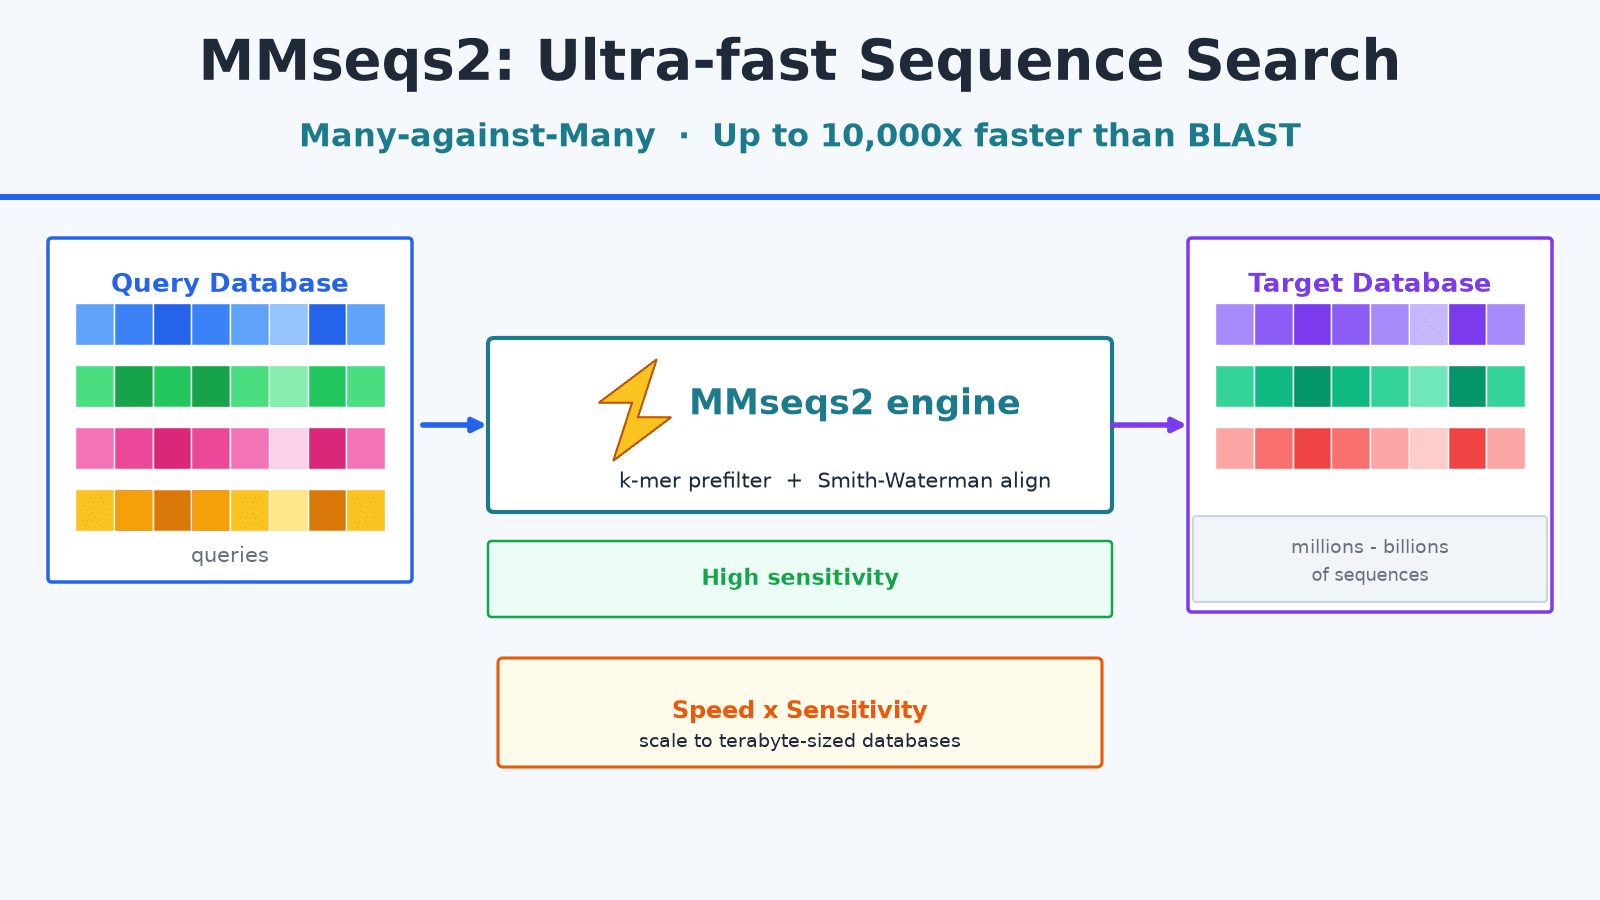
MMseqs2序列搜索:如何在数亿条蛋白质序列中快速锁定同源序列?
MMseqs2序列搜索是生物信息学中用于超大规模蛋白质序列比对与聚类的开源算法,可在海量数据库中快速识别同源序列。本文解析其两阶段工作原理——基于k-mer预过滤与矢量Smith-Waterman比对的“先快筛、后精比”,以及速度与灵敏度的权衡方式;并说明如何按序列规模与任务选择合适的搜索模式,以及它如何融入以AI为核心的蛋白质发现与工程流程,用于同源挖掘、去重与模板选择。
2026年11月8日
PDB蛋白质结构下载:如何正确获取并高效应用
本文系统讲解PDB蛋白质结构下载的完整流程:从认识RCSB PDB与PDB/mmCIF结构文件,到网站检索、REST/GraphQL API与批量下载三种获取方式,再到分辨率、B-因子、缺失残基等质量校验与结构清洗。内容面向分子对接、分子动力学、AI蛋白设计与酶/抗体工程的实际应用,帮助研究者把可靠的结构数据转换成稳定的工程起点。
2026年11月8日
胶原酶:让胶原三股螺旋"解链"的蛋白水解酶
胶原酶(collagenase,EC 3.4.24.3)是一类能在生理条件下水解天然胶原三股螺旋的蛋白水解酶,主要来源为产气荚膜梭菌(Clostridium histolyticum)。它切断胶原三股螺旋上的X–Gly肽键,把致密的胶原网络水解成小片段。在临床上,梭菌胶原酶用于慢性溃疡与烧伤的酶学清创(如Santyl软膏),以及掌腱膜挛缩症与佩罗尼病的病灶内注射(Xiaflex);在生物工艺中,它用于胰岛分离与组织解离。选型需围绕作用位点、金属依赖、pH窗口、活性测定与批间一致性展开。
2026年11月8日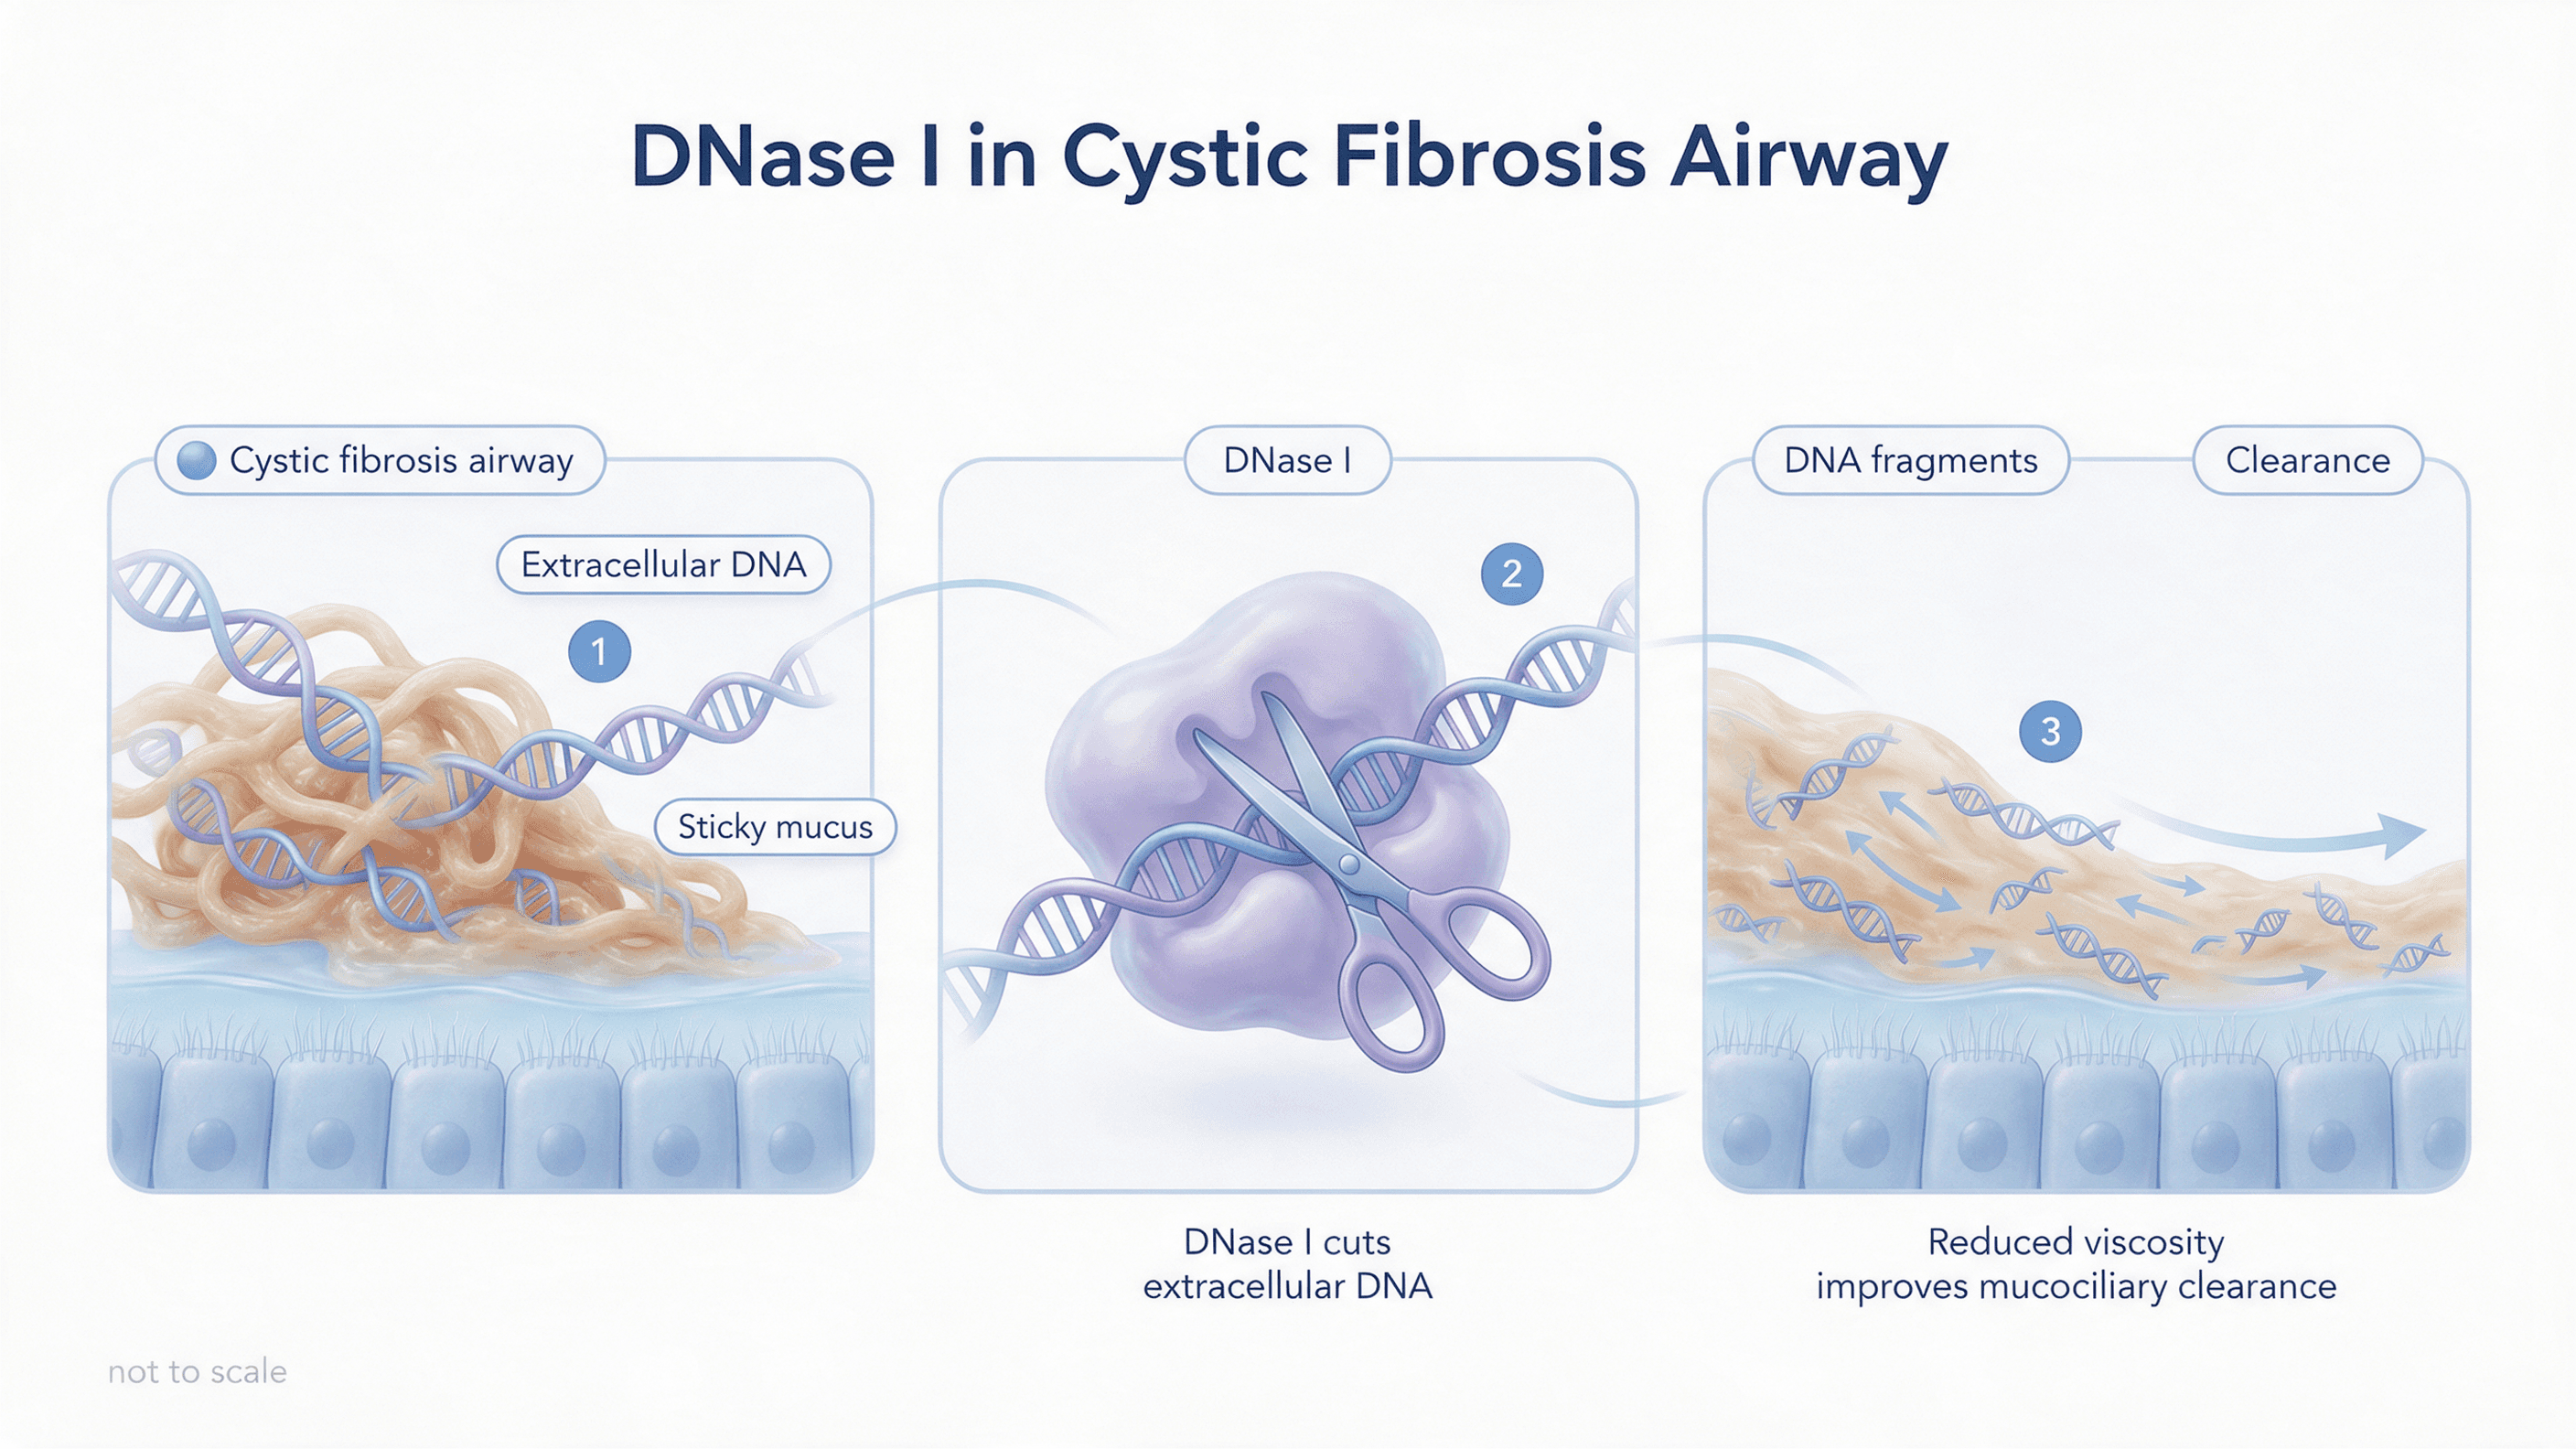
脱氧核糖核酸酶I:剪切胞外DNA的分子剪刀
脱氧核糖核酸酶I(DNase I)是一类专一水解DNA磷酸二酯键的核酸内切酶,通过识别并切断双链DNA骨架,把长链DNA切成小片段。重组人DNase I(dornase alfa,Pulmozyme)以雾化吸入方式降解囊性纤维化患者气道中的胞外DNA,降低痰液黏度,于1994年上市。在实验室与工业化生物工艺中,它用于清除细胞裂解液中的基因组DNA、降低黏度,为下游纯化创造条件。选型应把比活力、核酸酶污染、批次一致性与金属离子兼容性纳入同一评价框架。
2026年11月8日
蛋白质语言模型科研课题:让AI读懂蛋白质语言
本文围绕「蛋白质语言模型科研课题」,系统讲解蛋白语言模型(PLM)的核心原理——把氨基酸序列当作「语言」进行自监督预训练,以及它在结构预测、功能注释与适应度景观上的能力边界、工程化落地条件,并介绍天鹜科技(MatwingsVenus®)如何以「干湿闭环」赋能这类科研课题。适合从事蛋白工程、酶工程、抗体发现与AI生物计算的研究者与决策者阅读。
2026年11月8日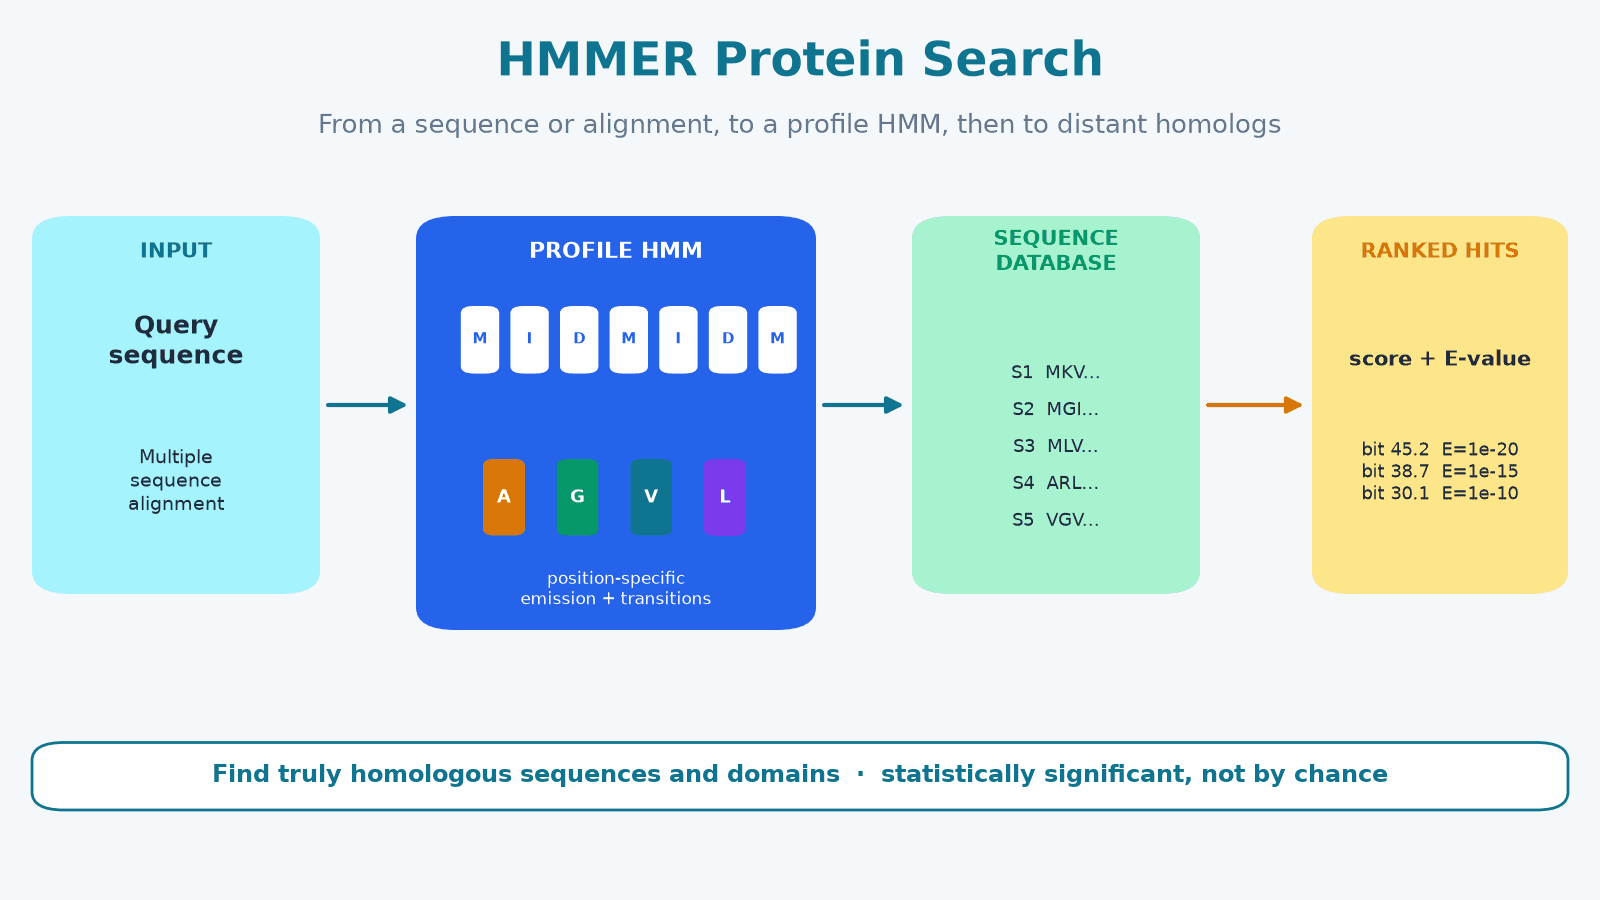
HMMER蛋白质搜索:用profile HMM从海量序列中精准锁定同源蛋白
HMMER蛋白质搜索让研究者把一条序列或一个多序列比对,转成“位置特异”的profile HMM,再到海量蛋白质数据库里精准挖掘同源序列与蛋白家族成员。相比逐一对齐的经典搜索,profile HMM能捕捉不同位点的保守与可变信息,对远缘同源更敏感,并通过E-value给出统计学显著性。读懂hmmsearch、hmmscan、phmmer与jackhmmer的差异、选对数据库与阈值,是把这项标准生物信息学工具用好的关键。本文以简洁语言拆解原理、流程与选型,并展示它在AI蛋白工程中的角色。
2026年11月8日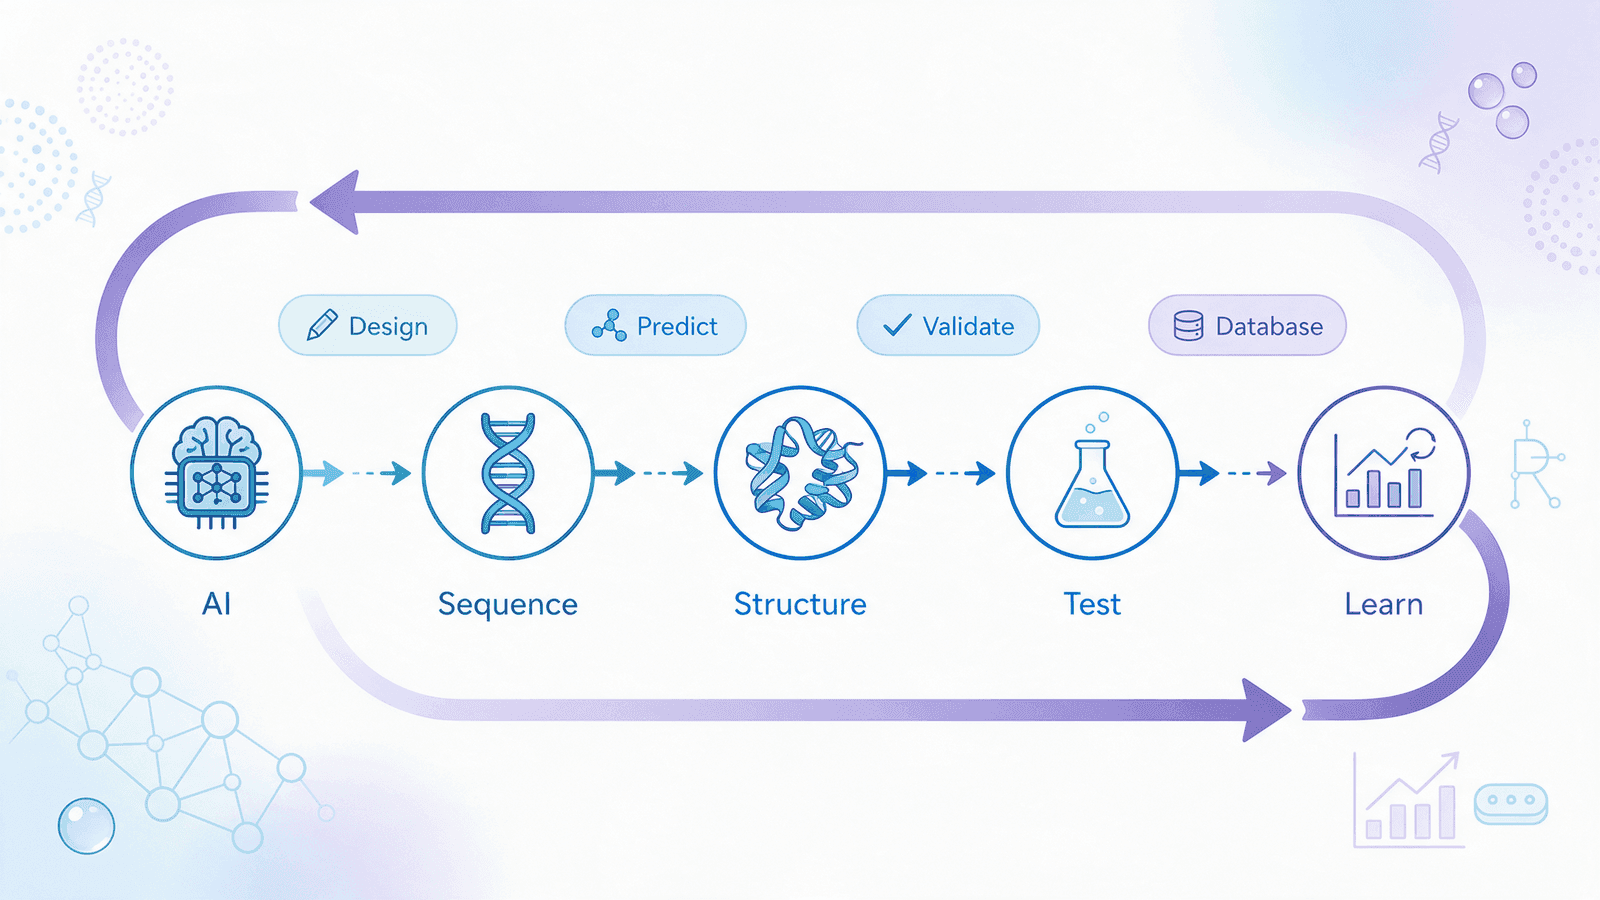
AI蛋白实验室如何让蛋白质设计从"碰运气"走向"可预测"?
AI蛋白实验室(AI protein laboratory)指以AI为核心、把蛋白设计、结构预测、性能评估与湿实验验证串成"干湿闭环"的研发范式。它基于Design–Build–Test–Learn(DBTL)循环,用生成模型(如RFdiffusion、ProteinMPNN)产出候选序列,用结构预测模型(如AlphaFold)验证折叠,再通过主动学习让每一次湿实验数据回馈模型、持续迭代。相比传统定向进化,AI蛋白实验室能把探索范围从天文数字的突变组合收敛到高价值区域,显著提升效率与成功率。本文从原理、闭环到应用,系统讲清AI蛋白实验室怎么用、边界在哪,并介绍MatwingsVenus®(晓鹜®)的工程化实践。
2026年11月5日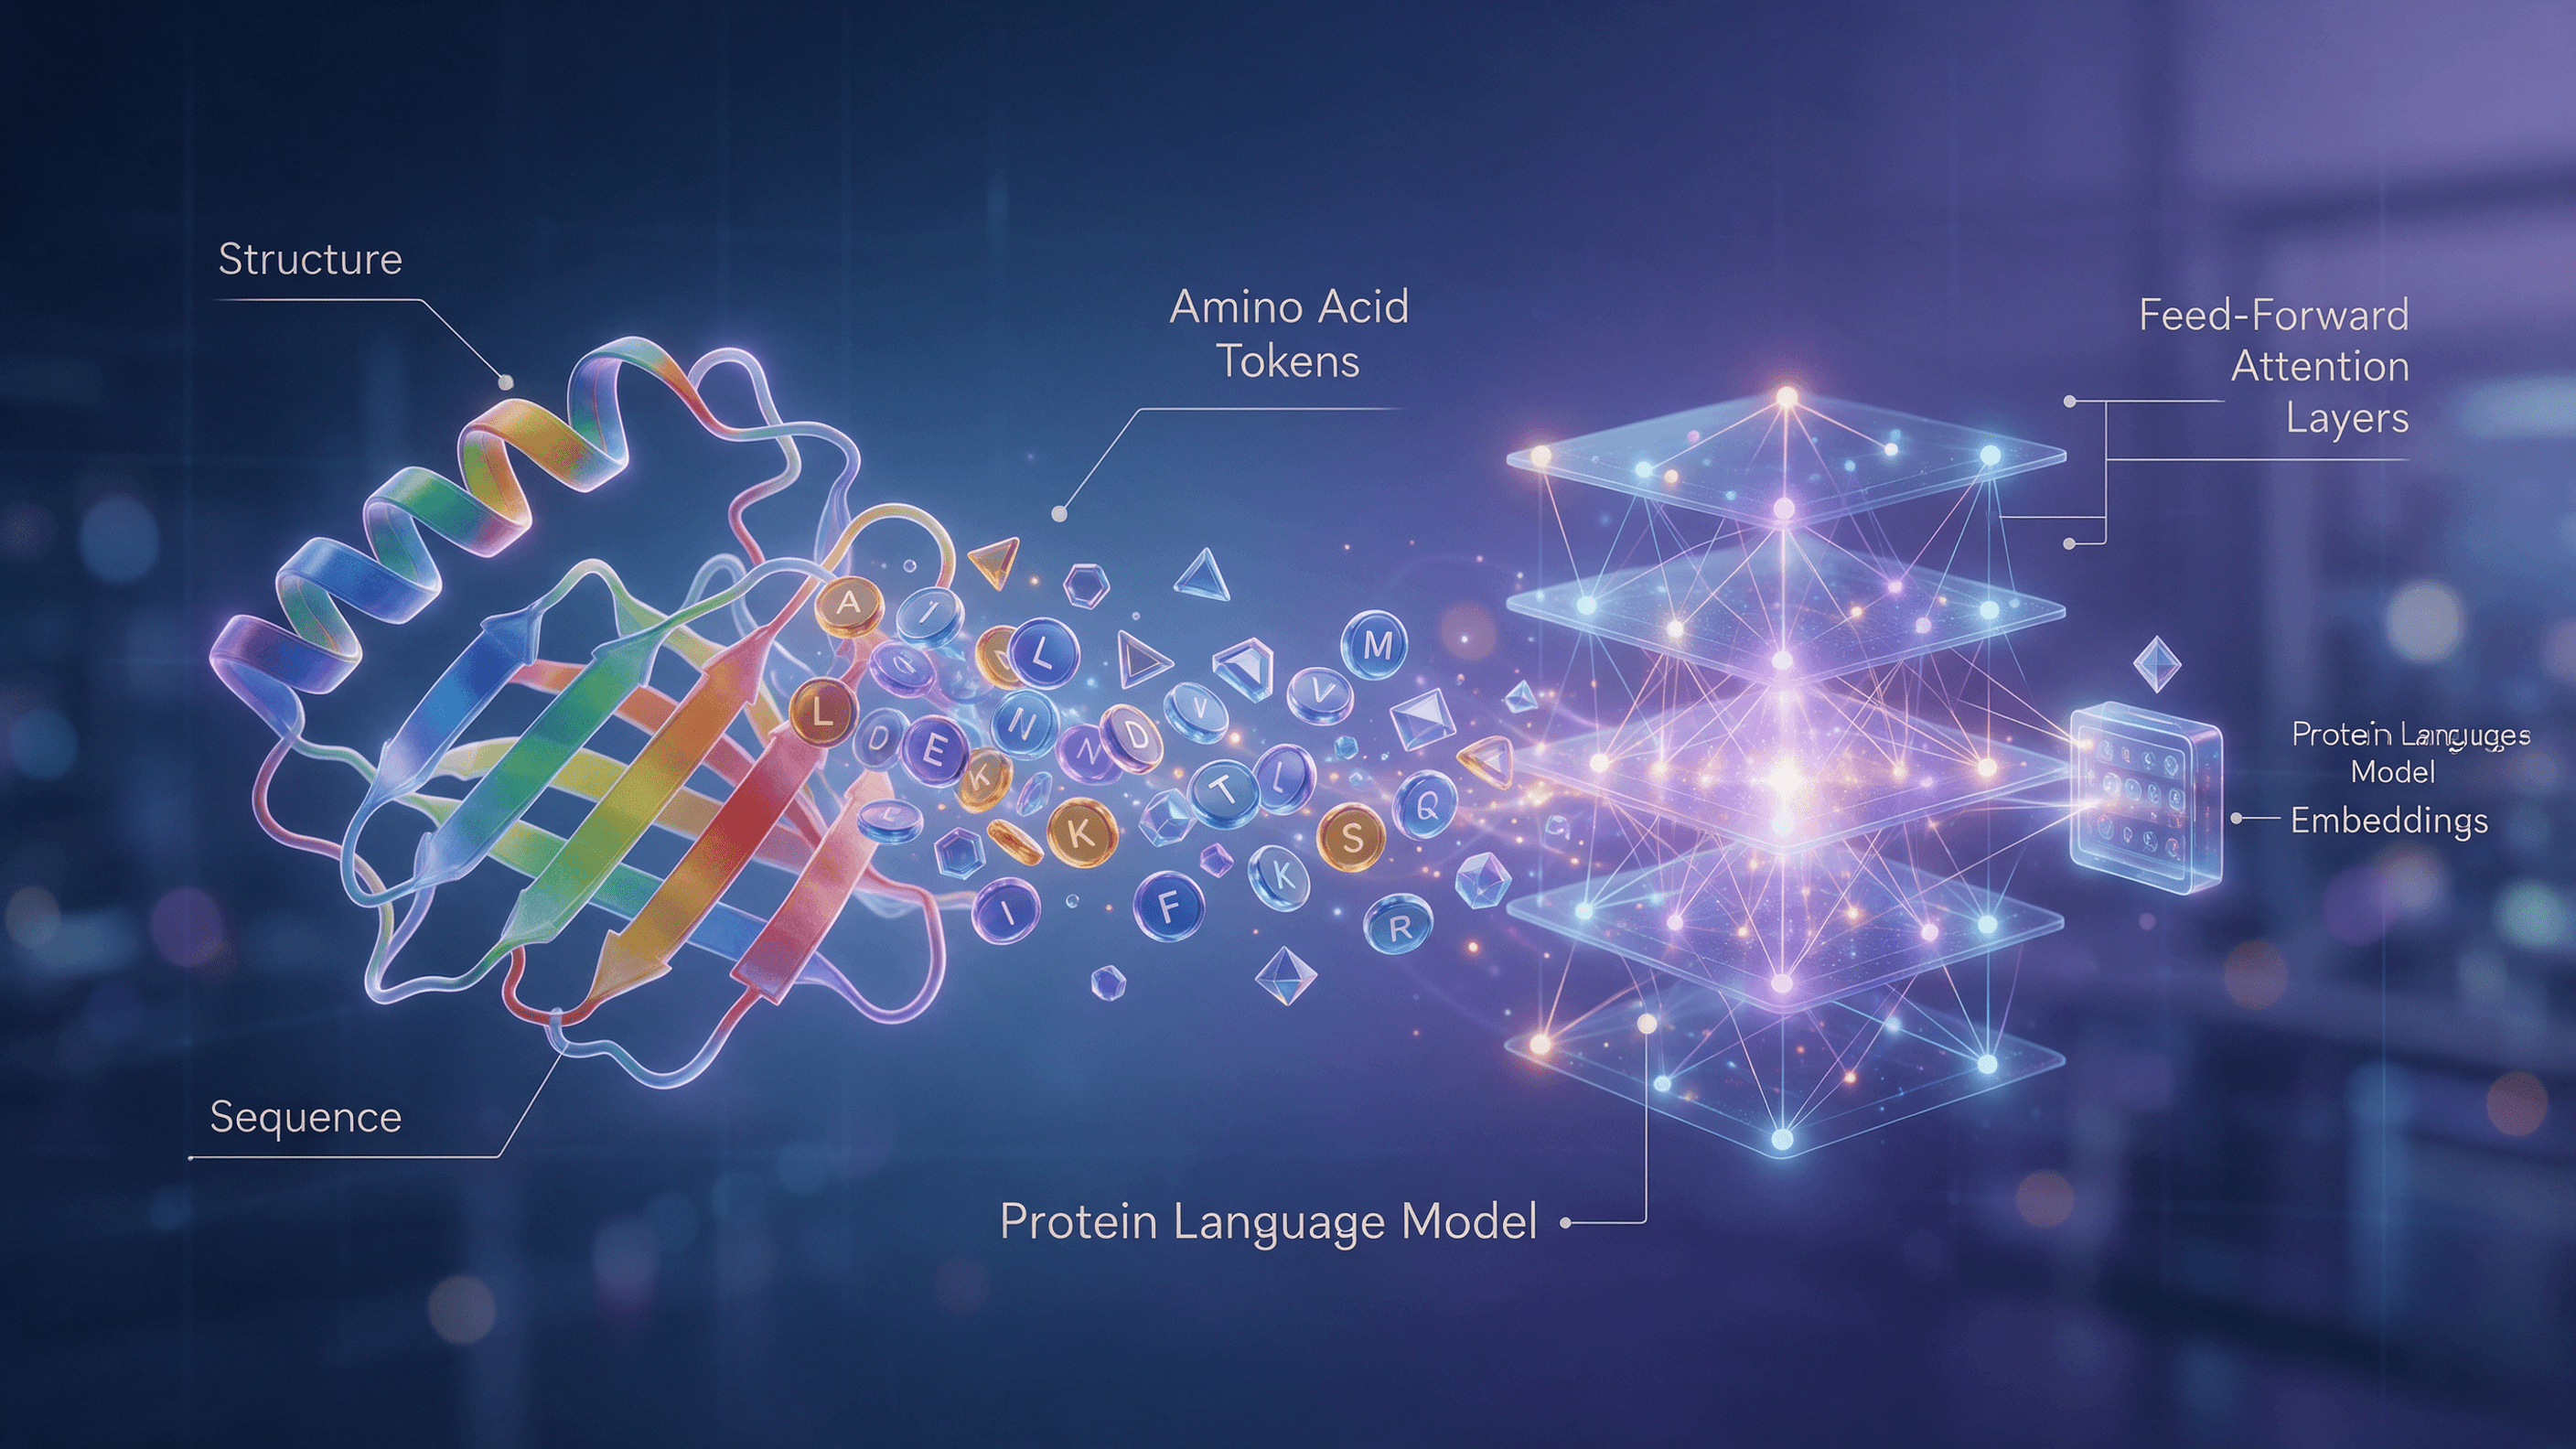
SaProt蛋白质语言模型:结构感知如何突破「只读序列」的局限
SaProt 结构感知蛋白质语言模型把 3D 结构「折叠进」词表,让语言模型在序列之外读懂局部结构,从而在变体效应、稳定性等任务上整体领先传统序列模型——这是从「只读序列」到「序列+结构」的关键一步。
2026年11月5日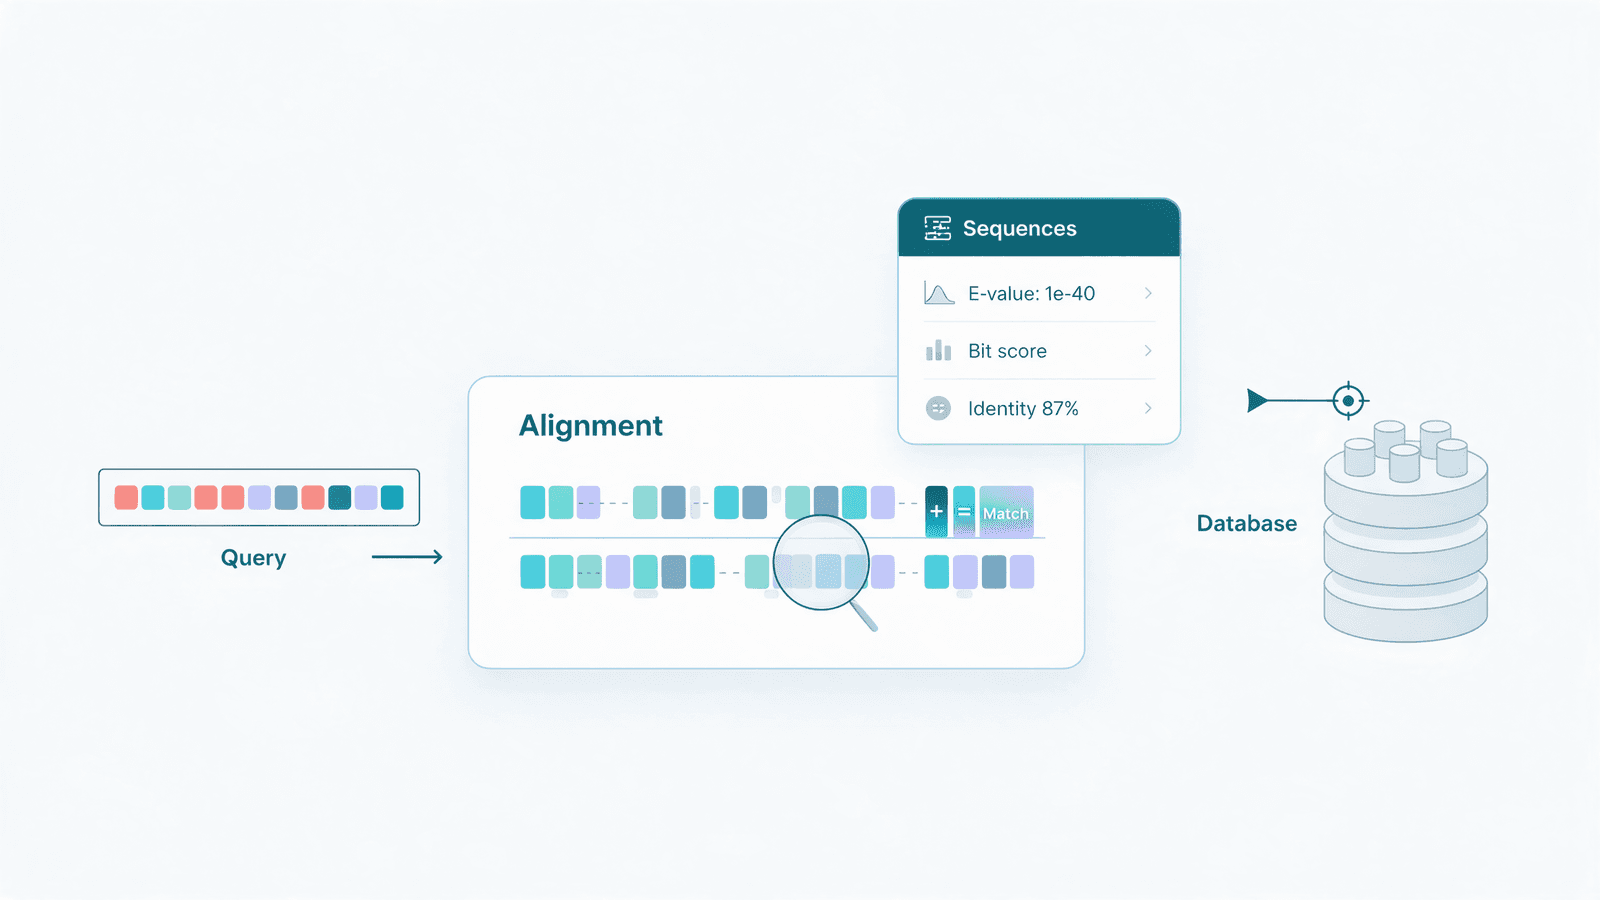
BLASTp蛋白质比对如何帮你从一条序列找到它的同源蛋白?
BLASTp(Basic Local Alignment Search Tool,蛋白质版)是NCBI提供的、把一条蛋白查询序列与蛋白数据库比对的经典工具,由Altschul等人在1990年提出。它用氨基酸替换矩阵(默认BLOSUM62)与种子词命中策略,在局部区域找出相似片段,并给出E-value(期望值)、bit score、一致度(identity)等统计指标,帮助判断比对是否显著。借助BLASTp,你可以识别未知蛋白、推断同源与功能、寻找基因家族成员,为功能注释与基因家族分析打下基础。
2026年11月5日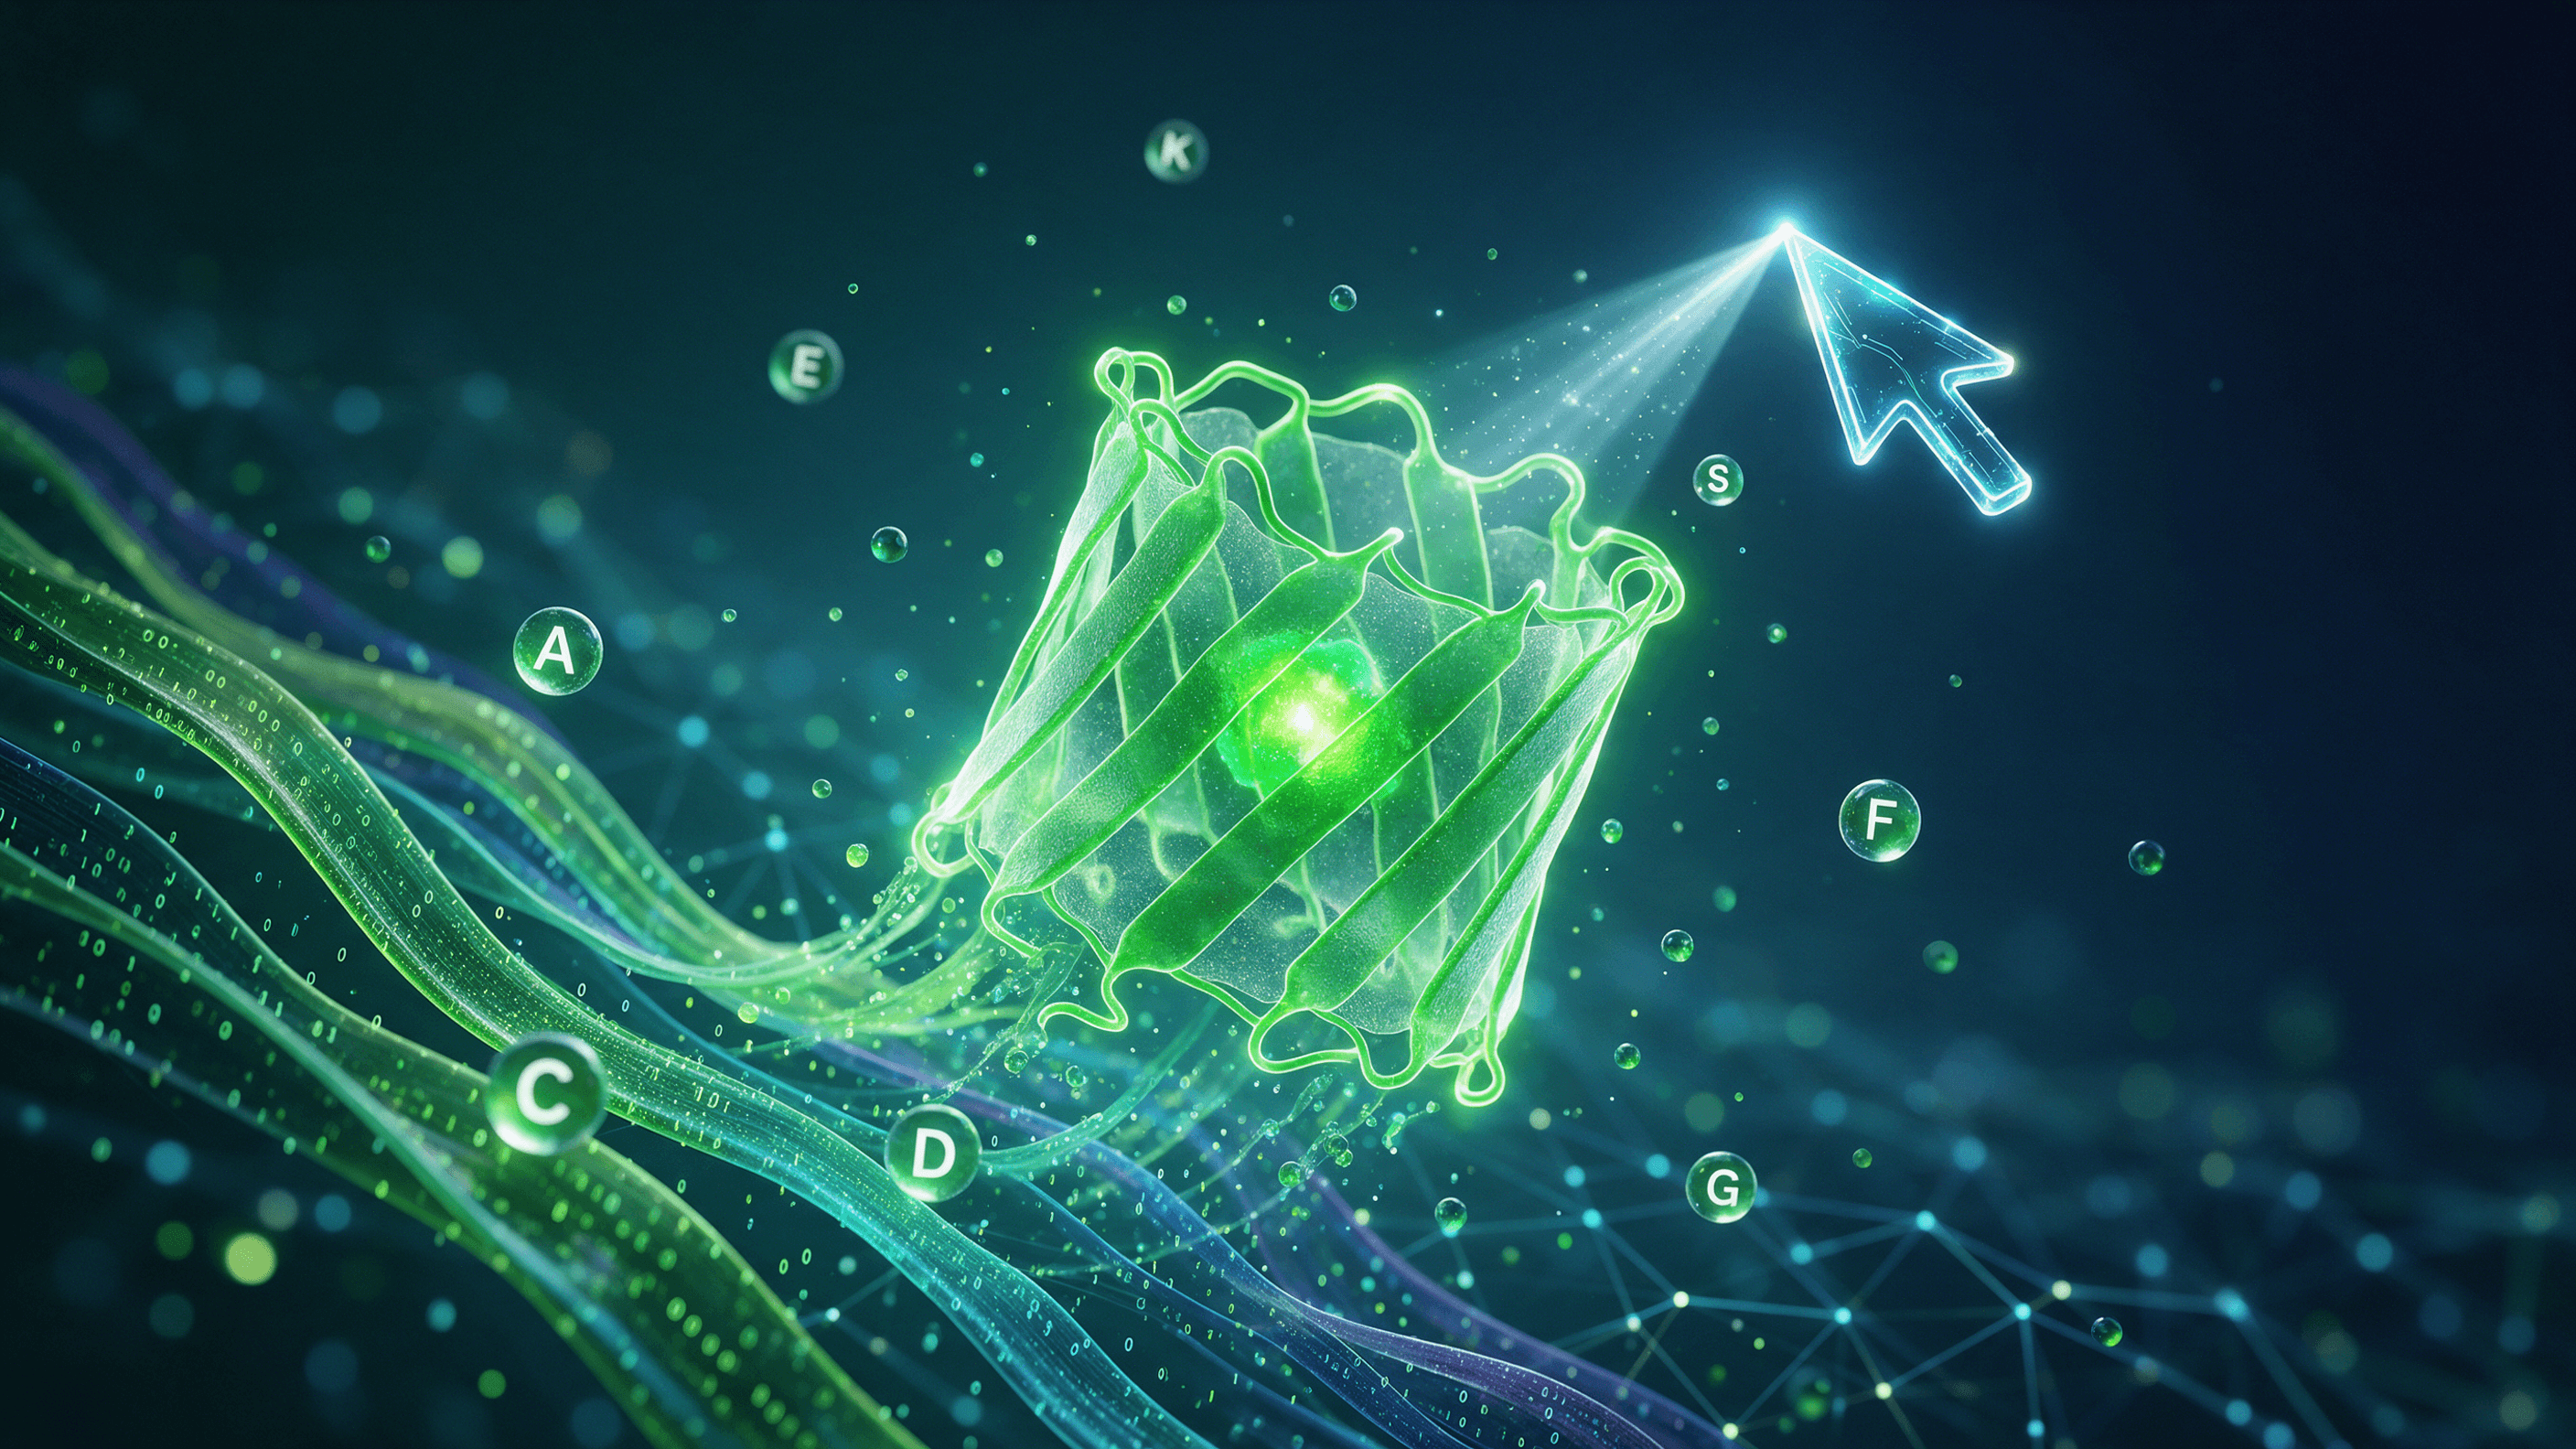
ESM3蛋白质生成模型:AI如何「编程」蛋白质?
ESM3是由EvolutionaryScale于2024年6月发布的生物生成式基础模型,也是首个能同时推理蛋白质序列、结构与功能的生成模型。与AlphaFold等「预测型」模型不同,ESM3像语言模型一样通过提示「编程」蛋白质:把序列、结构、功能三类信息编码为共享表征,再生成全新蛋白。其代表成果esmGFP,是用「思维链」提示保留发色团残基、生成与天然最近邻约58%同源的全新荧光蛋白,相当于模拟5亿年进化,并已通过湿实验验证发光。本文科普ESM3的机制、能力边界、评测方式与「生成—合成—测试—学习」干湿闭环,并说明MatwingsVenus®(晓鹜®)如何把这类生成模型接入可落地的实验闭环。
2026年11月5日
NCBI蛋白质数据库到底是什么?一文看懂它的检索、注释与分析能力
NCBI蛋白质数据库(NCBI Protein Database)是检索蛋白质序列与注释的首选公共资源,汇集GenBank编码区翻译、RefSeq参考序列与TPA第三方注释,并交叉链接UniProt、PDB、PubMed以及Gene/Taxonomy。本文用通俗语言讲清它如何组织蛋白质信息:从序列来源、单条记录结构,到Protein BLAST与CD-Search分析工具,再到与蛋白工程Pipeline的衔接。无论你想快速找到某条蛋白序列,还是为AI蛋白设计准备输入数据,都能从这里获得清晰路径与能力边界。
2026年11月5日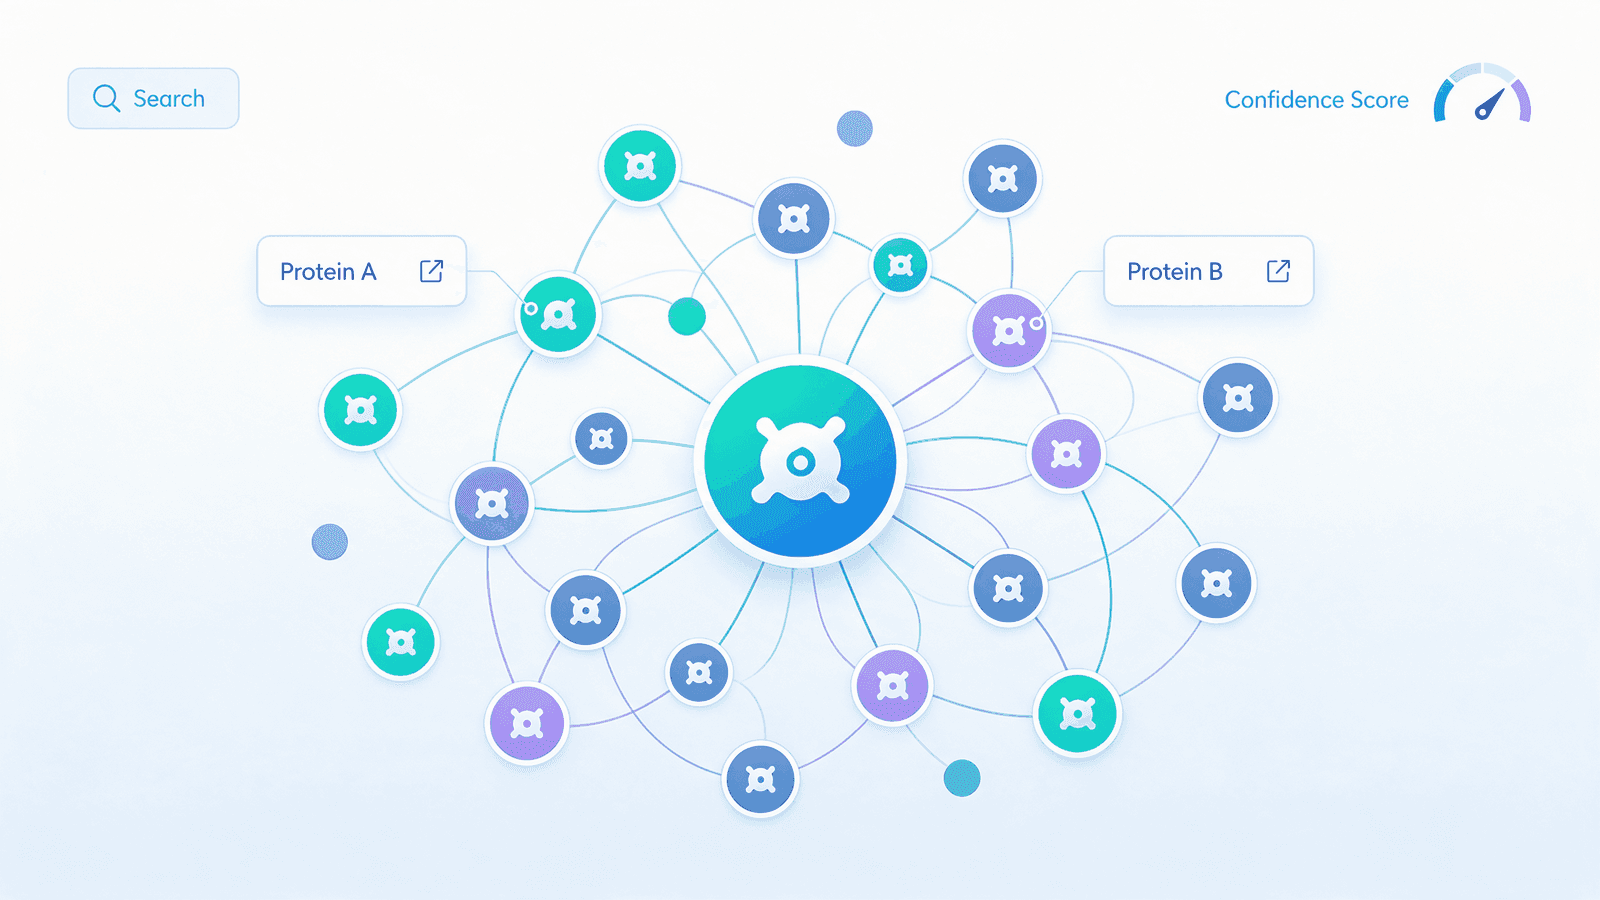
STRING蛋白互作数据库如何帮你读懂细胞内的蛋白质网络?
STRING蛋白互作数据库(Search Tool for the Retrieval of Interacting Genes/Proteins)是全球应用最广的蛋白质相互作用(PPI)公共资源之一,截至STRING 12.5已收录约5930万个蛋白质、覆盖12535个物种。它汇总实验互作、人工审编通路数据库、文献文本挖掘,以及基因邻接、基因融合、系统发育共现、共表达等计算预测通道,并通过概率式合并给出0–1的置信度分数,帮助判断每条互作的可信程度。借助STRING,你可构建PPI网络、开展通路富集与聚类分析,为靶点发现、功能注释和机制研究提供可解释的网络证据。本文从原理、评分到应用工作流,系统带你读懂STRING。
2026年11月5日
蛋白质语言模型突变预测:从序列到功能的智能解码
本文面向研发与工艺团队,系统解读蛋白质语言模型(Protein Language Model, PLM)突变预测:它如何从海量无标注蛋白序列中自监督学习,把氨基酸序列转化为富含结构与功能信息的残基级嵌入,从而预测单点或组合突变对稳定性、功能和结合亲和力的影响;并讨论其能力边界(需湿实验验证)、与经典计算方法的区别,以及在抗体/酶工程中的干湿闭环落地路径。
2026年11月5日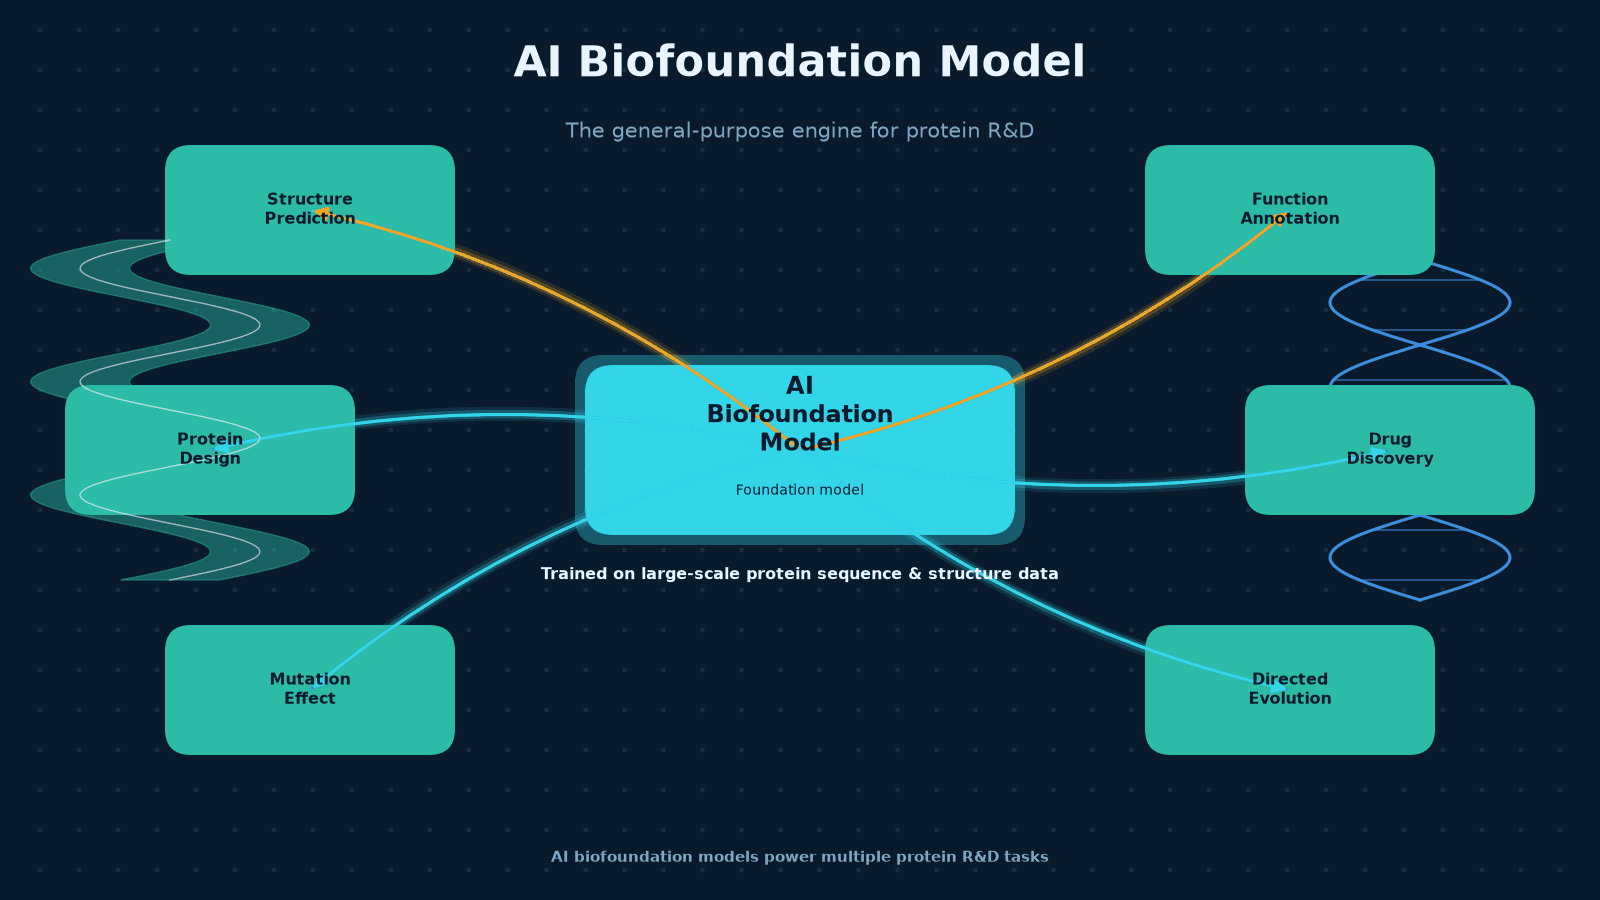
AI生物基座模型是什么?它如何成为蛋白质与药物研发的底层引擎?
AI生物基座模型是一类在大规模蛋白质序列、结构与功能数据上预训练的通用人工智能模型,能在下游任务中通过微调实现结构预测、功能注释、蛋白设计与性质优化。它以「通用底座+任务适配」替代过去「一任务一模型」的研发方式,正在重塑蛋白质工程与药物研发流程。本文解读其背景、原理、能力边界与选型要点,并展示MatwingsVenus®(晓鹜®)平台如何将基座模型与湿实验验证闭环结合,推动从序列到高性能蛋白的工程化落地。
2026年11月4日
蛋白质逆折叠模型推荐:从骨架到序列的AI选型指南
逆折叠模型决定序列设计的第一道质量关卡——选型应综合序列恢复率、可设计性与下游湿实验验证成本,而非只看单一指标。
2026年11月4日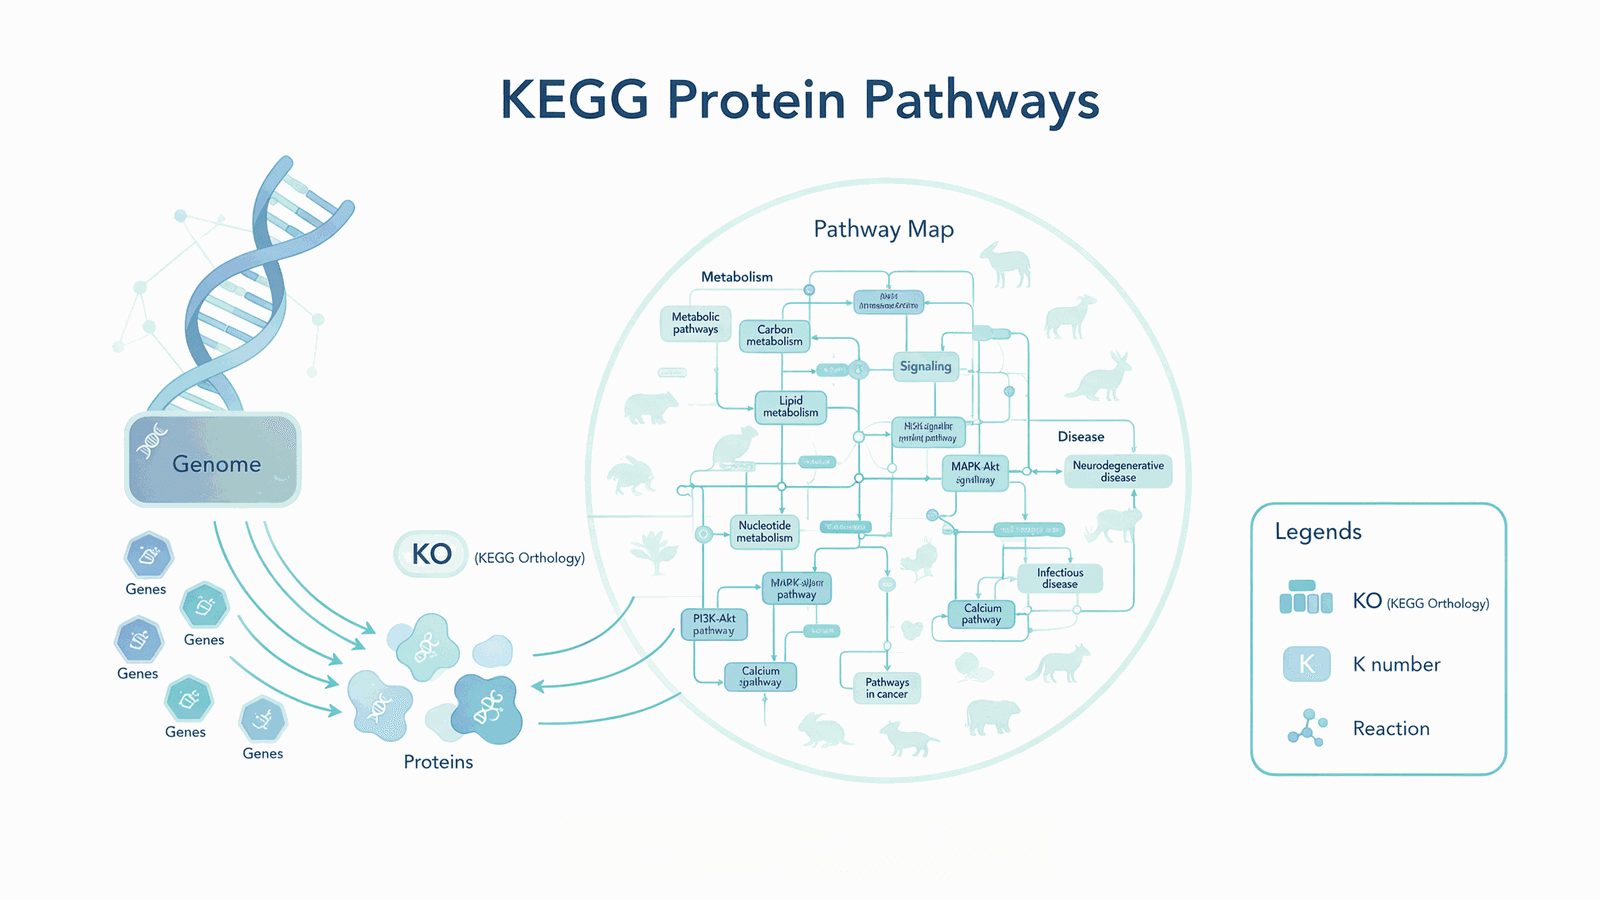
KEGG蛋白质通路是什么?基因如何被映射到生物学通路网络
KEGG(Kyoto Encyclopedia of Genes and Genomes,京都基因与基因组百科全书)是连接基因与生物功能的经典数据库。KEGG蛋白质通路通过「基因→KO编号(KEGG Orthology)→通路图」三层结构,把基因组、转录组或蛋白质组数据映射到可解释的代谢、信号与疾病通路网络。
2026年11月4日
阿替普酶等纤溶相关酶制剂全解:从纤溶机理到溶栓酶选型
阿替普酶(重组组织型纤溶酶原激活剂,rt-PA)是临床常用溶栓药物,本质是人体内皮自产组织型纤溶酶原激活剂(tPA)的基因工程版本。本文先用生活化类比解释 tPA 如何把血栓中的纤溶酶原激活为纤溶酶、定点拆解纤维蛋白凝块,再面向研发与采购梳理纤溶酶制剂的代际演进、纤维蛋白特异性与出血风险的权衡、半衰期与给药方式、替奈普酶的工程改造,以及 CHO 表达、纯化、活性检测等工业化要点,给出溶栓相关酶制剂的选型逻辑。
2026年11月4日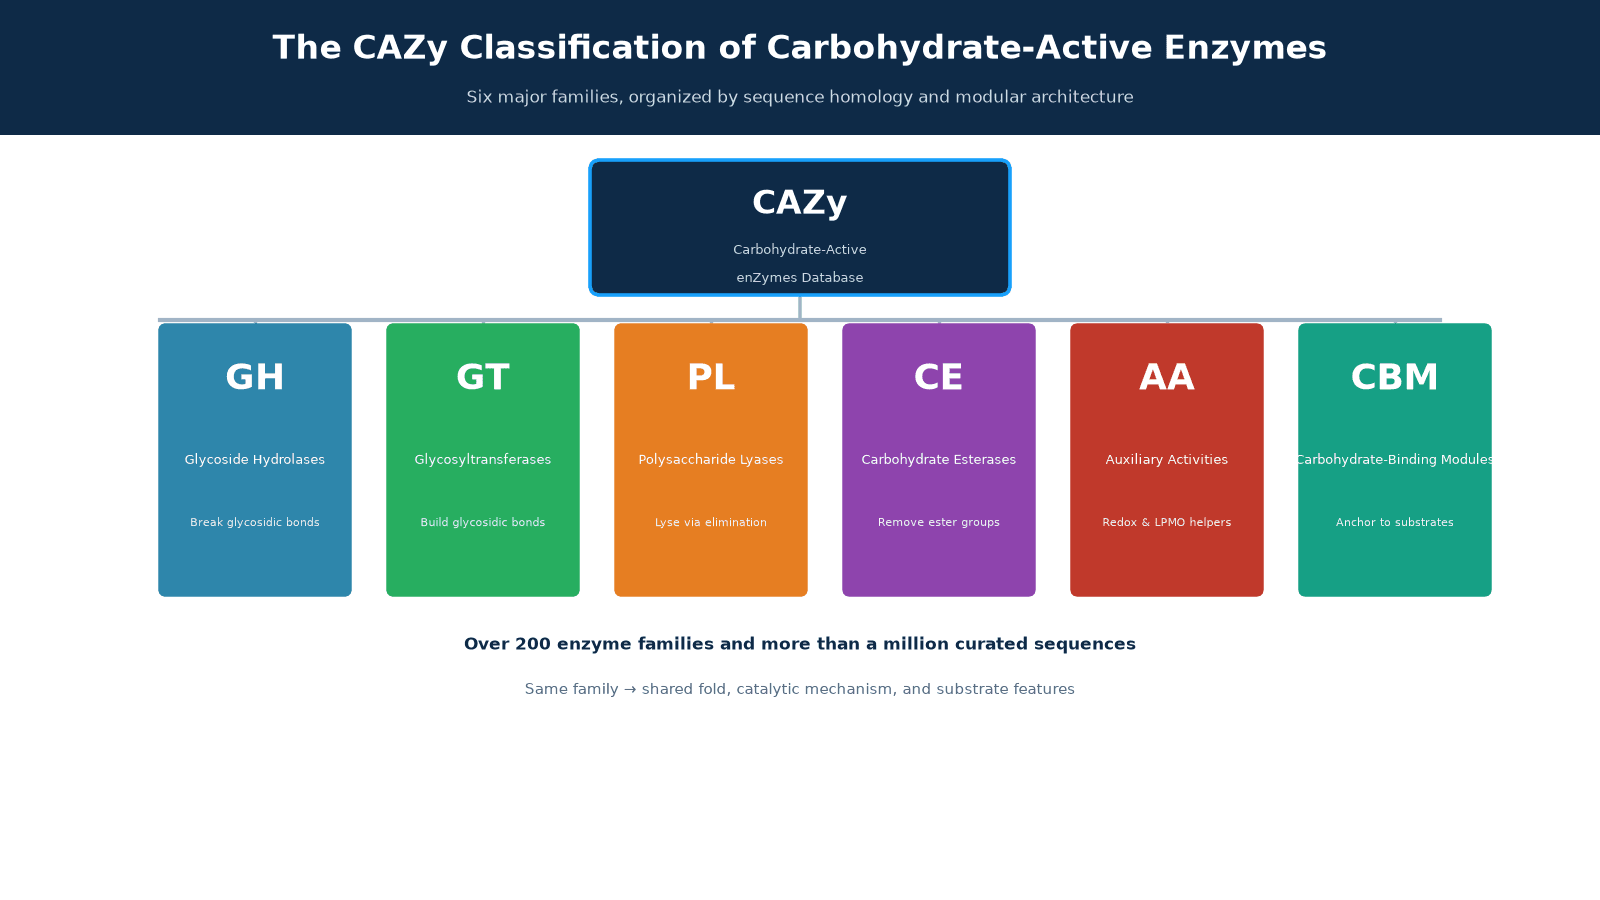
CAZy酶数据库是什么?它如何为碳水活性酶分类?
CAZy酶数据库(Carbohydrate-Active enZymes Database)是全球公认的碳水活性酶分类与注释平台。它按照氨基酸序列同源性,将糖苷水解酶(GH)、糖基转移酶(GT)、多糖裂合酶(PL)、碳水酯酶(CE)、辅助活性(AA)与碳水结合模块(CBM)归入数百个家族,同一家族共享折叠与催化机理。本文系统解析CAZy的分类原理、查询注释方法与工业应用,并说明它如何在食品、饲料、生物燃料与生物制造中,配合AI驱动的酶工程平台加速酶发现与改造。
2026年11月4日
基于结构的蛋白质序列设计:让序列「学会」折叠
基于结构的蛋白质序列设计把结构作为约束,用AI逆向求解氨基酸序列,再靠「干-湿闭环」反复验证,让「设计出来」的蛋白质真正折叠、稳定、有功能。
2026年11月4日
链激酶与尿激酶:溶栓酶双雄的机理、工艺与选型对比
链激酶(Streptokinase,SK)与尿激酶(Urokinase,uPA)都是纤溶酶原激活剂,都能把纤溶酶原转化为纤溶酶、从而溶解血栓,是临床与科研中最常被拿来对比的两种溶栓酶。但两者的来源、机制、免疫原性与成本差异显著:链激酶来自链球菌、价格低却易致敏;尿激酶更人源、可重复给药但更贵。本文用对比视角,从应用场景、作用原理、技术路线、工艺质控到选型方案,兼顾大众科普与研发、采购,讲清二者为何相似、又为何不同,以及如何根据场景做出选择。
2026年11月4日
BRENDA酶数据库怎么用?从EC酶分类到工业选酶的全景解读
BRENDA酶数据库(BRaunschweig ENzyme DAtabase)是全球最全面的酶功能数据资源库,按国际生物化学与分子生物学联合会(IUBMB)酶学委员会(EC)分类体系,收录酶的EC分类、催化反应、底物/产物、动力学参数(Km、Vmax、kcat、kcat/Km)、辅因子、抑制剂、最适pH与温度、生物来源、结构与稳定性等信息,文献数据经人工持续整编,现由德国Leibniz DSMZ维护,隶属ELIXIR核心数据资源,并以CC BY 4.0免费开放。本文讲解BRENDA的核心内容、数据结构、查询与API用法,并说明如何将其与AI驱动的酶工程平台(如MatwingsVenus®(晓鹜®))结合,形成从选酶、条件优化到定向改造的闭环。
2026年11月4日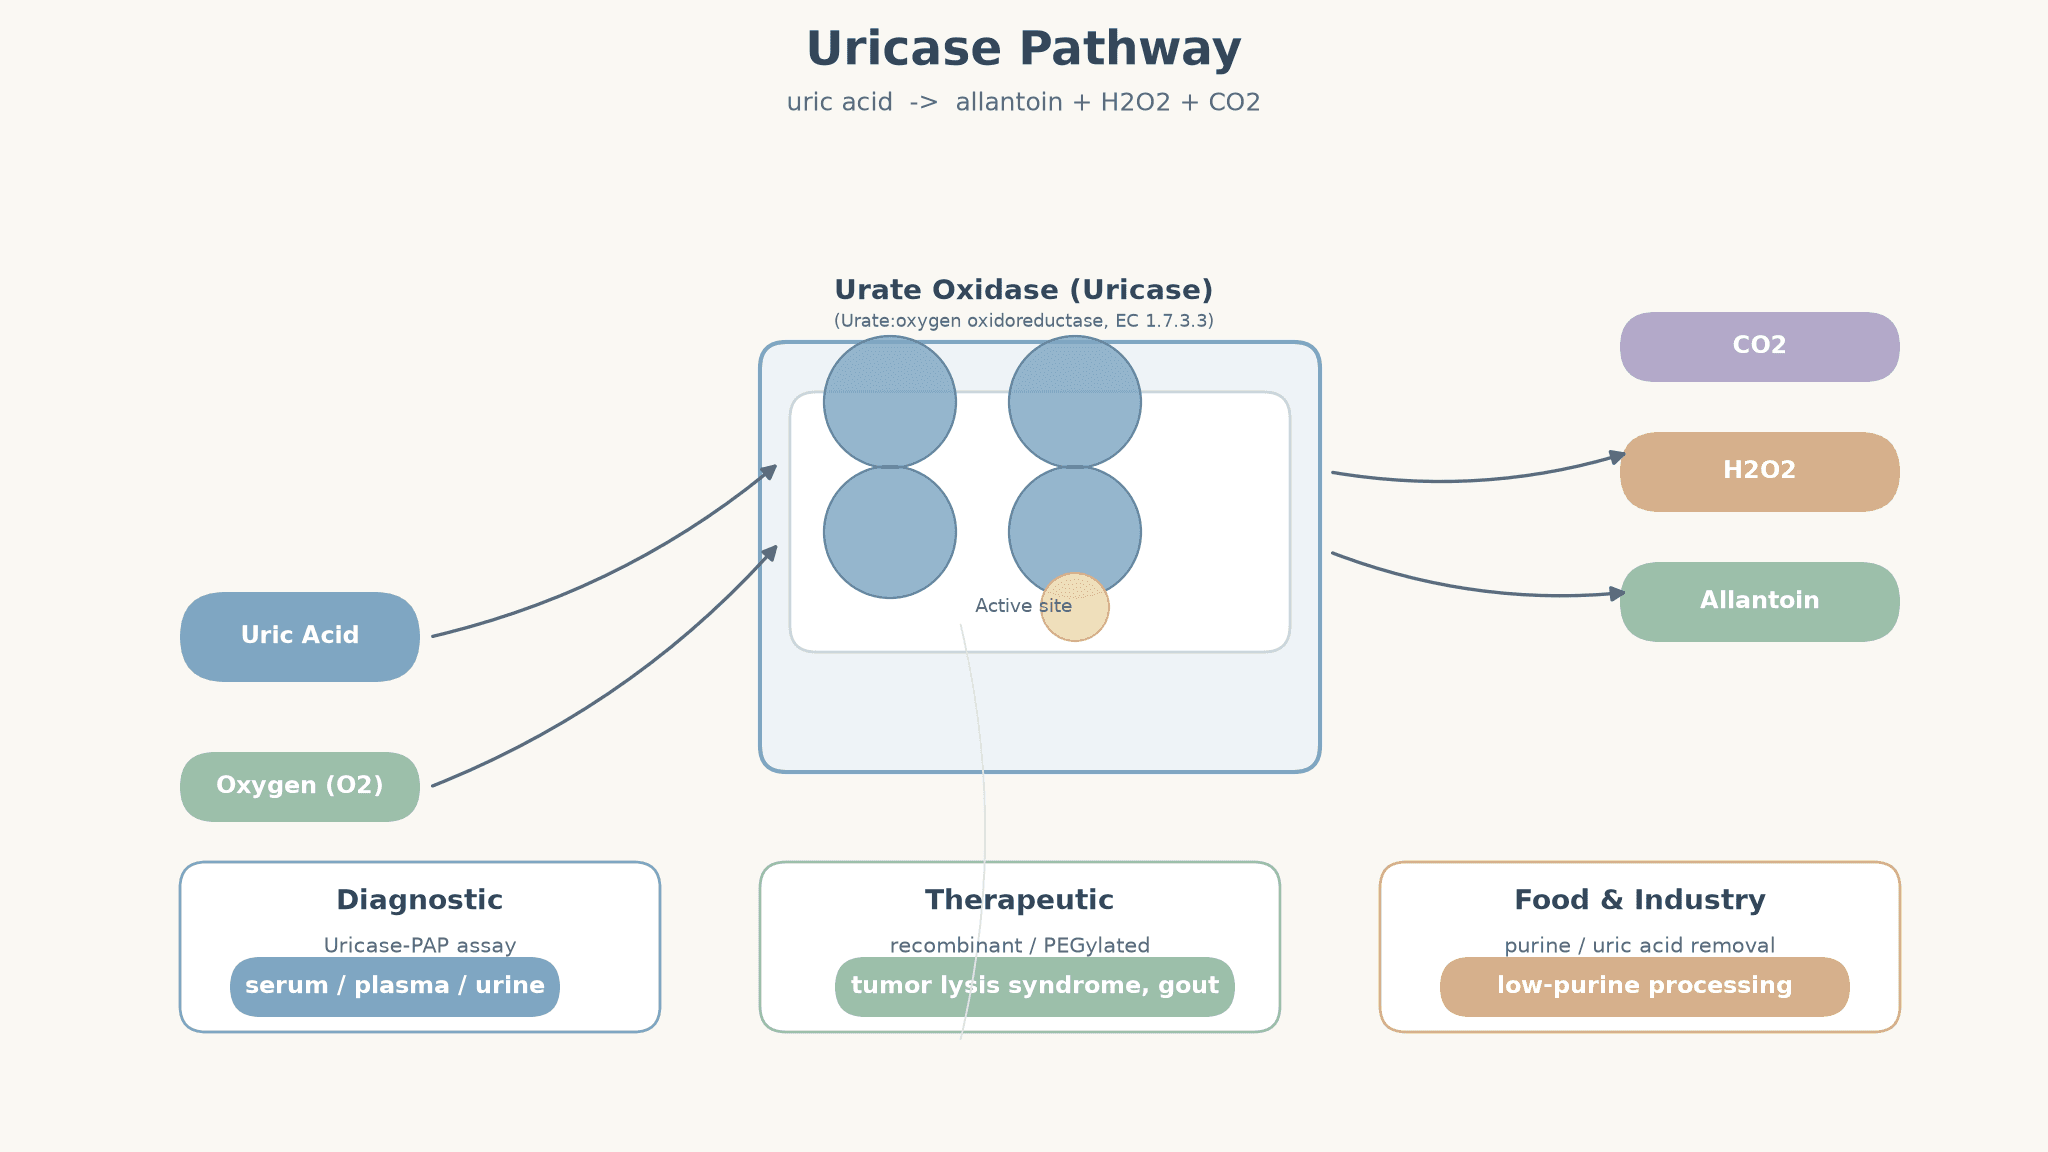
尿酸氧化酶:人类为什么缺少它,而尿酸检测又为何依赖它?
尿酸氧化酶(尿酸盐氧化酶,EC 1.7.3.3)专一催化尿酸氧化为尿囊素,同时释放过氧化氢与二氧化碳。人类在进化中丢失了有功能的尿酸酶基因,却在它的催化反应之上,构建起临床尿酸检测的主流酶法。理解其催化机理、来源差异与工艺窗口,是选到稳定可靠氧化工具酶的关键。
2026年11月4日
LigandMPNN蛋白质设计:AI如何读懂配体,为蛋白定序
LigandMPNN是2025年发表于《Nature Methods》的蛋白质序列设计深度学习模型(Dauparas等),它显式建模小分子、核苷酸与金属等所有非蛋白组分,在配体交互残基的native序列恢复上显著超过Rosetta与ProteinMPNN,并已用于设计超过100个经实验验证的小分子/DNA结合蛋白。
2026年11月4日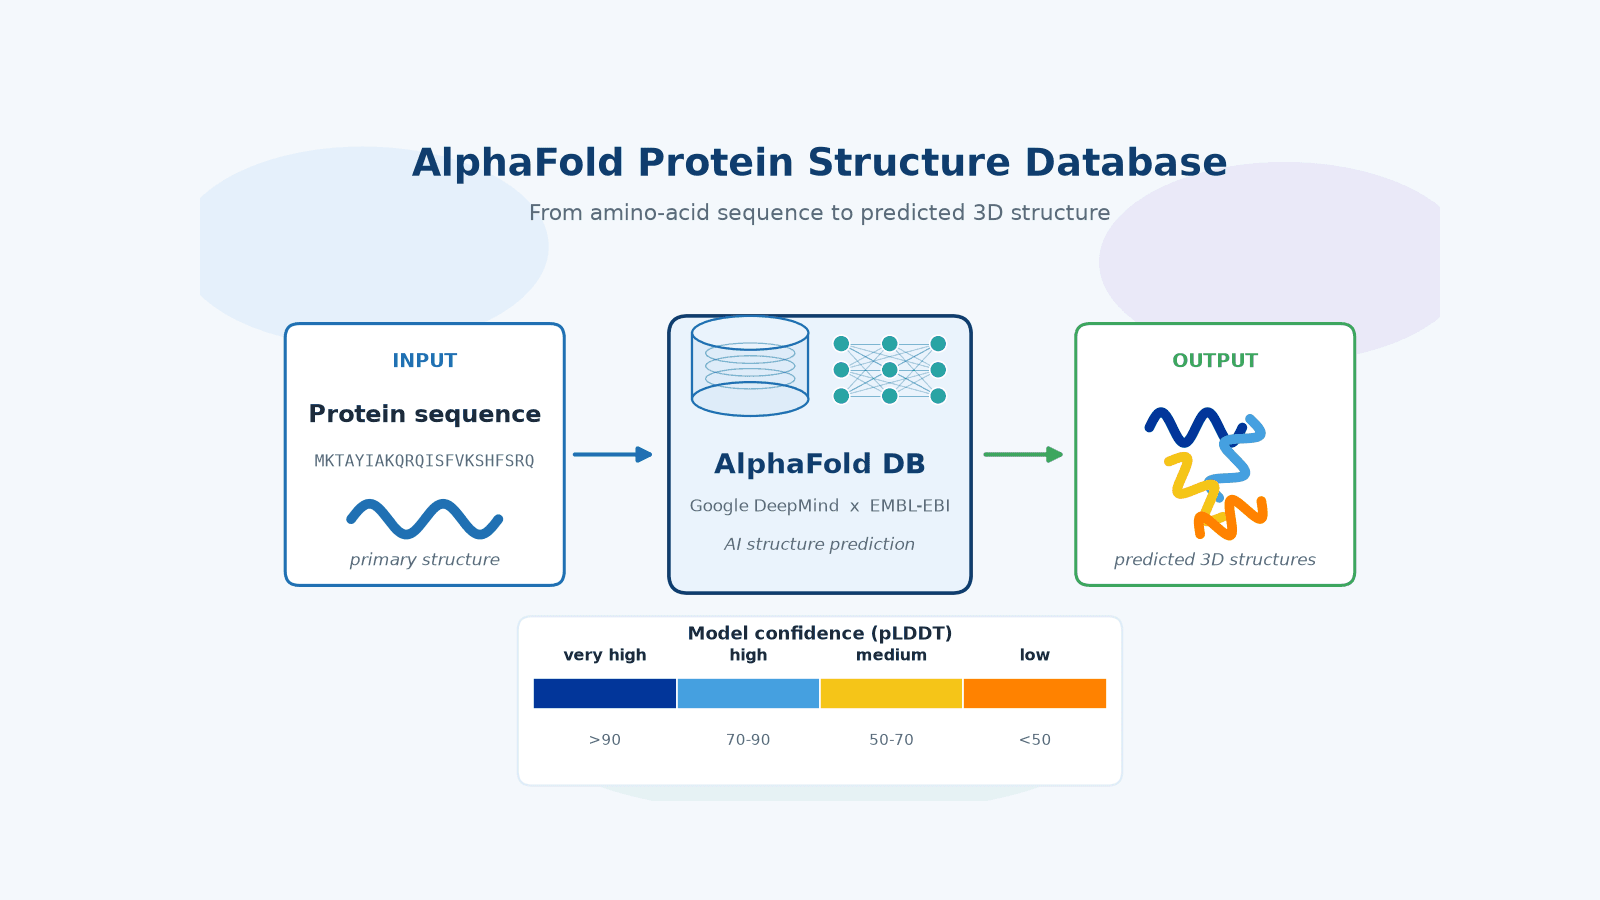
什么是AlphaFold数据库(AlphaFold DB)?从氨基酸序列到三维结构的AI蛋白质库
AlphaFold数据库(AlphaFold DB)是由Google DeepMind与EMBL-EBI联合开发的免费蛋白质结构预测数据库,依托获得2024年诺贝尔化学奖的AlphaFold人工智能,把氨基酸序列映射为三维结构,现已收录超过2亿个AI预测的蛋白质结构。它提供pLDDT置信度与PAE两个质量指标,帮助科研人员在药物发现、酶工程、抗体设计等场景里快速筛选高可信结构。本文用通俗方式讲清AlphaFold数据库的原理、使用方法与能力边界,并介绍天鹜科技MatwingsVenus®(晓鹜®)如何把该数据库与蛋白工程闭环结合。
2026年11月4日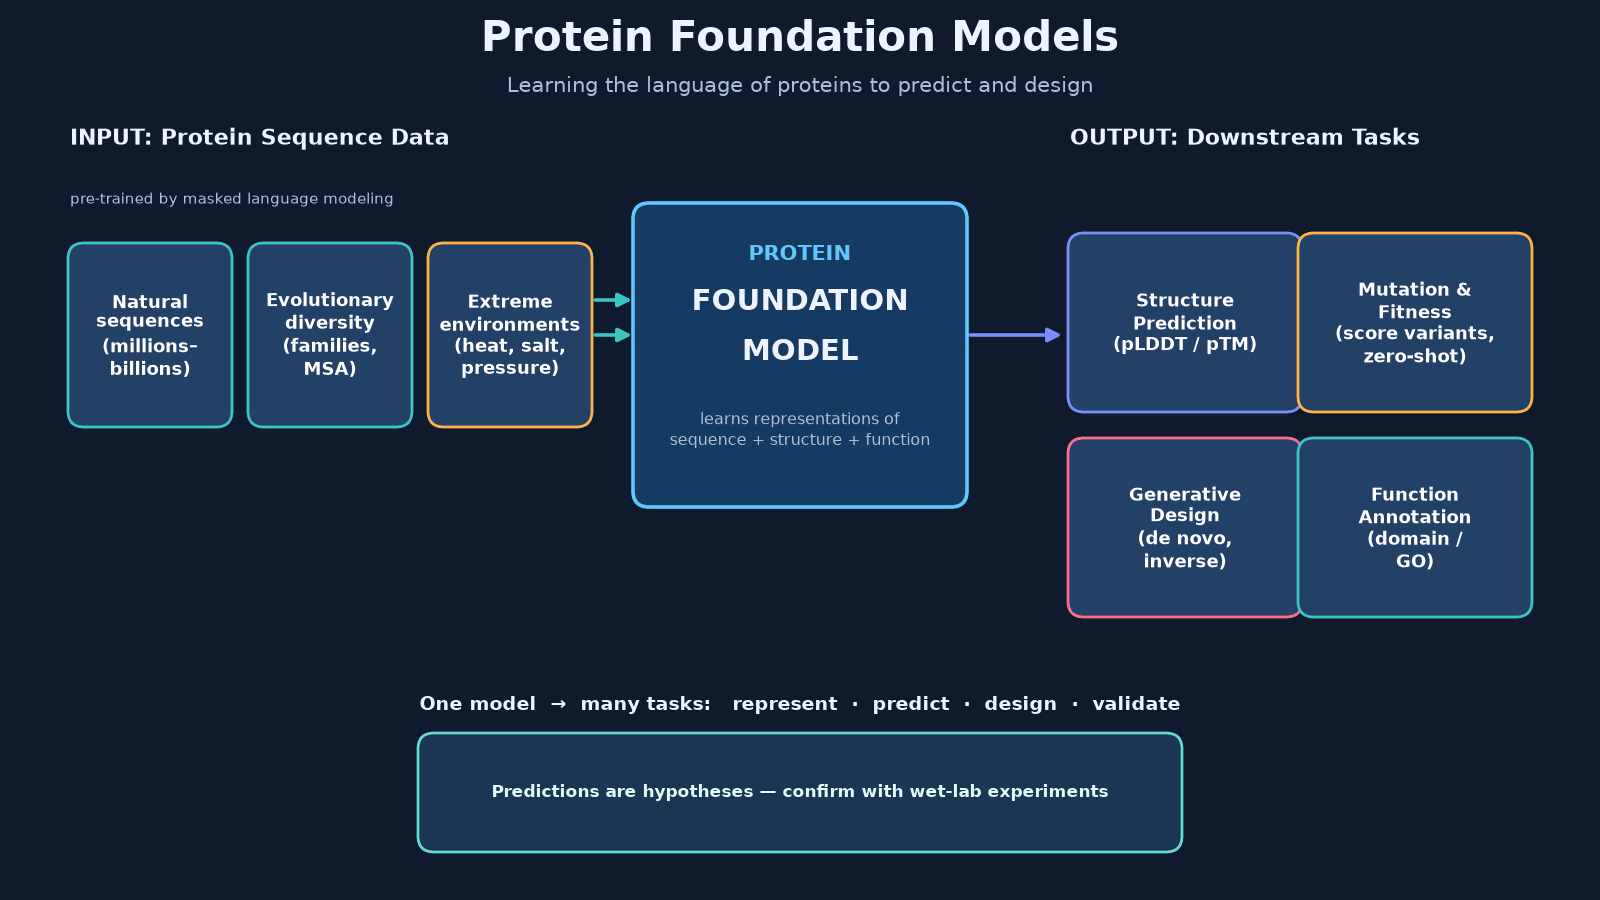
蛋白质基座大模型是什么?它如何助力蛋白质研发?
蛋白质基座大模型(Protein Foundation Model)是借助自监督学习在海量蛋白质序列上预训练的大规模人工智能模型,能够学习蛋白质的"语言",用于结构预测、突变效应评估与蛋白质从头设计。本文梳理蛋白质基座大模型的工作原理、主要能力与边界(如 ESM/ESMFold、AlphaFold、ProteinMPNN、RFdiffusion 等),并介绍天鹜科技(Matwings Technology)自主研发的 MatwingsVenus®(晓鹜®)蛋白质设计通用大模型,如何把"AI 设计—自动实验—数据回流"的干湿闭环落地,帮助科研与产业用户缩短研发周期、提升研发成功率。
2026年11月3日
ProteinMPNN蛋白质序列设计:让AI读懂蛋白骨架
ProteinMPNN蛋白质序列设计让AI从蛋白三维骨架生成可折叠的氨基酸序列,是蛋白工程从「手动试错」走向「计算设计—验证—学习」闭环的关键一环。
2026年11月3日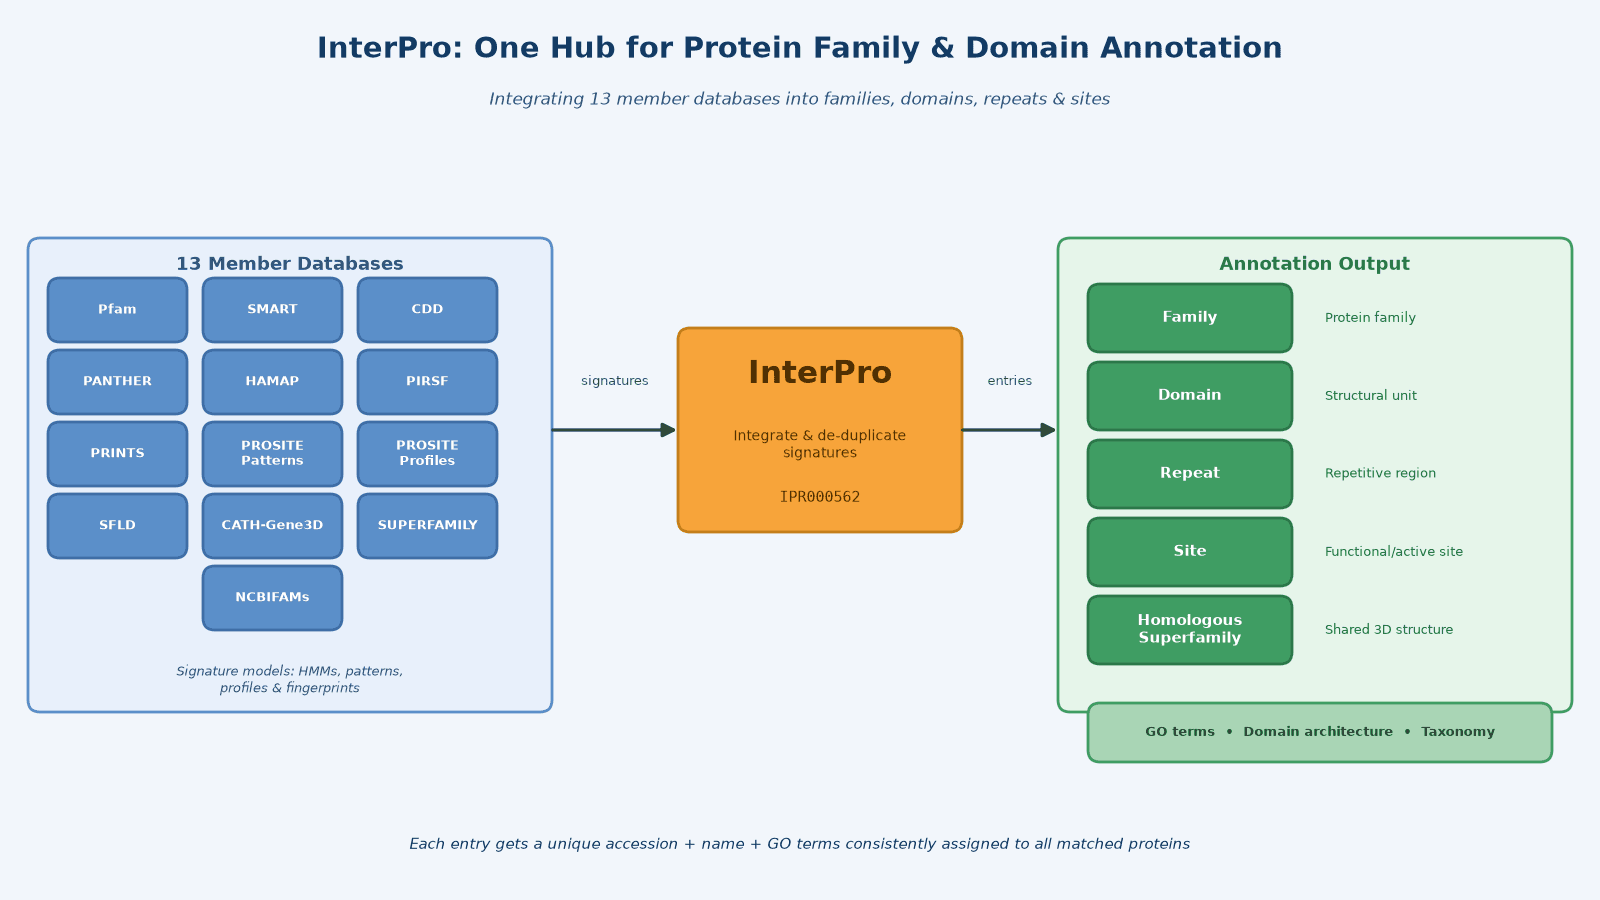
InterPro蛋白质数据库如何把蛋白序列变成结构与功能注释?
InterPro蛋白质数据库是EMBL-EBI维护的权威蛋白质资源,整合Pfam、SMART、CDD、PANTHER等13个成员数据库的蛋白质签名,将蛋白序列分类为家族、结构域、重复区和功能位点。它以唯一的IPR条目编号、名称、摘要与GO注释,为每条蛋白提供一致可复用的功能注释,配合InterProScan扫描工具与InterPro-N人工智能模型,覆盖了绝大多数UniProtKB序列,广泛用于基因组注释、结构域预测与蛋白质家族分析。本文解析InterPro的工作机制、条目结构、使用流程与能力边界,帮助研究者更准确地完成蛋白质功能注释。
2026年11月3日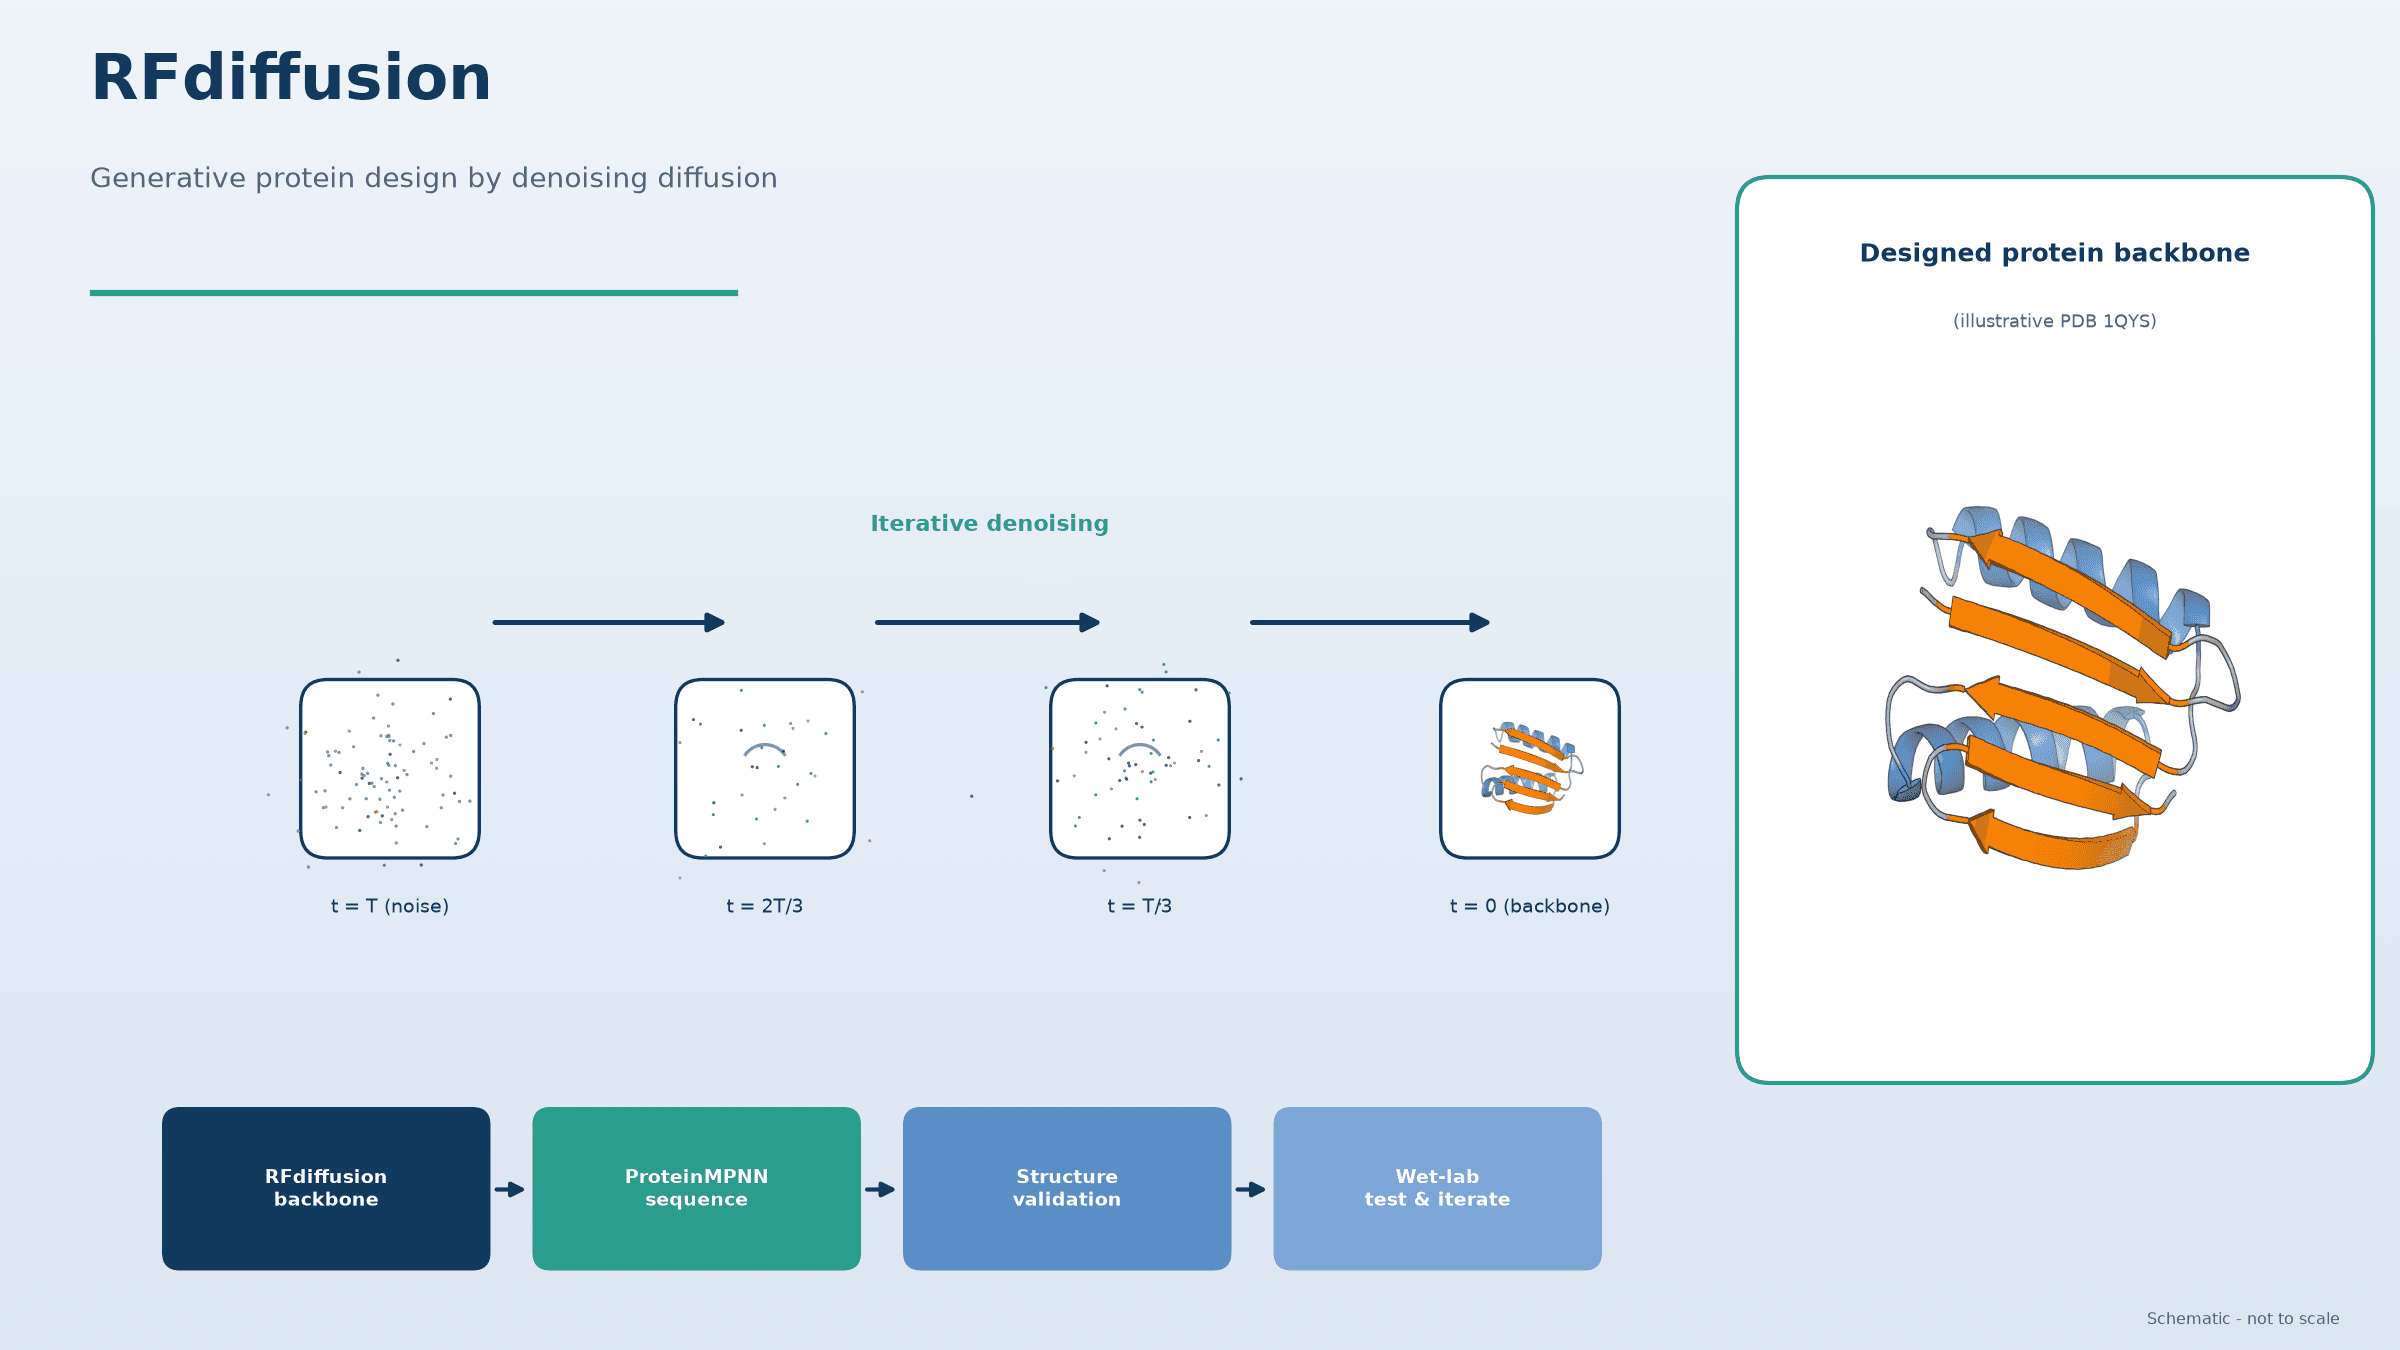
RFdiffusion蛋白质设计教程:从随机噪声到可验证蛋白
本文系统讲解RFdiffusion蛋白质设计教程:从去噪扩散模型的原理(基于RoseTTAFold架构,在蛋白骨架坐标与残基框架上做加噪/去噪)讲起,到如何生成全新蛋白骨架、用ProteinMPNN设计氨基酸序列、经AlphaFold2/Boltz重折叠过滤,再到湿实验表达与结合力验证。文章同时明确能力边界:RFdiffusion是高效的起点而非终点,设计成功率取决于靶点、条件与控制参数。最后介绍MatwingsVenus®(晓鹜®)如何把RFdiffusion等生成模型与高通量湿实验闭环融合,把“AI蛋白设计”落到可交付的分子。
2026年11月3日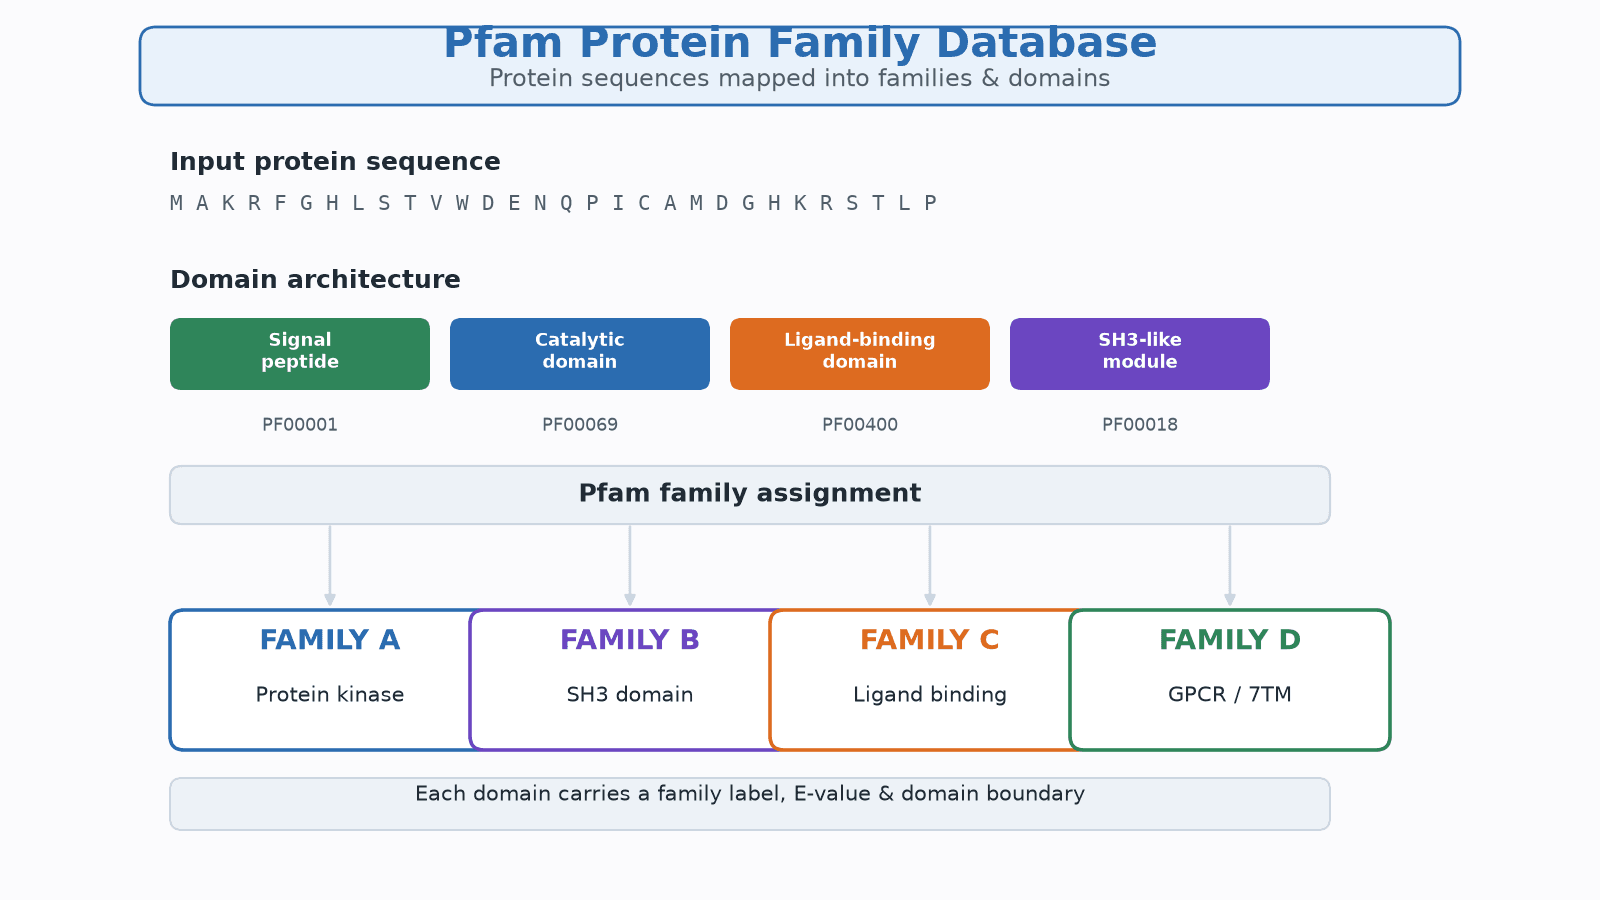
什么是Pfam蛋白质家族数据库?它如何帮你读懂蛋白质的“身份标签”?
Pfam蛋白质家族数据库是全球使用最广泛的蛋白质家族与结构域注释资源,以隐马尔可夫模型(HMM)为核心,把蛋白质序列归入成千上万个家族。其中Pfam-A由专家人工维护、质量高,Pfam-B为自动化聚类生成,并通过InterPro与UniProt等数据库整合。研究人员用Pfam识别结构域架构、预测蛋白质功能、追溯进化起源。
2026年11月3日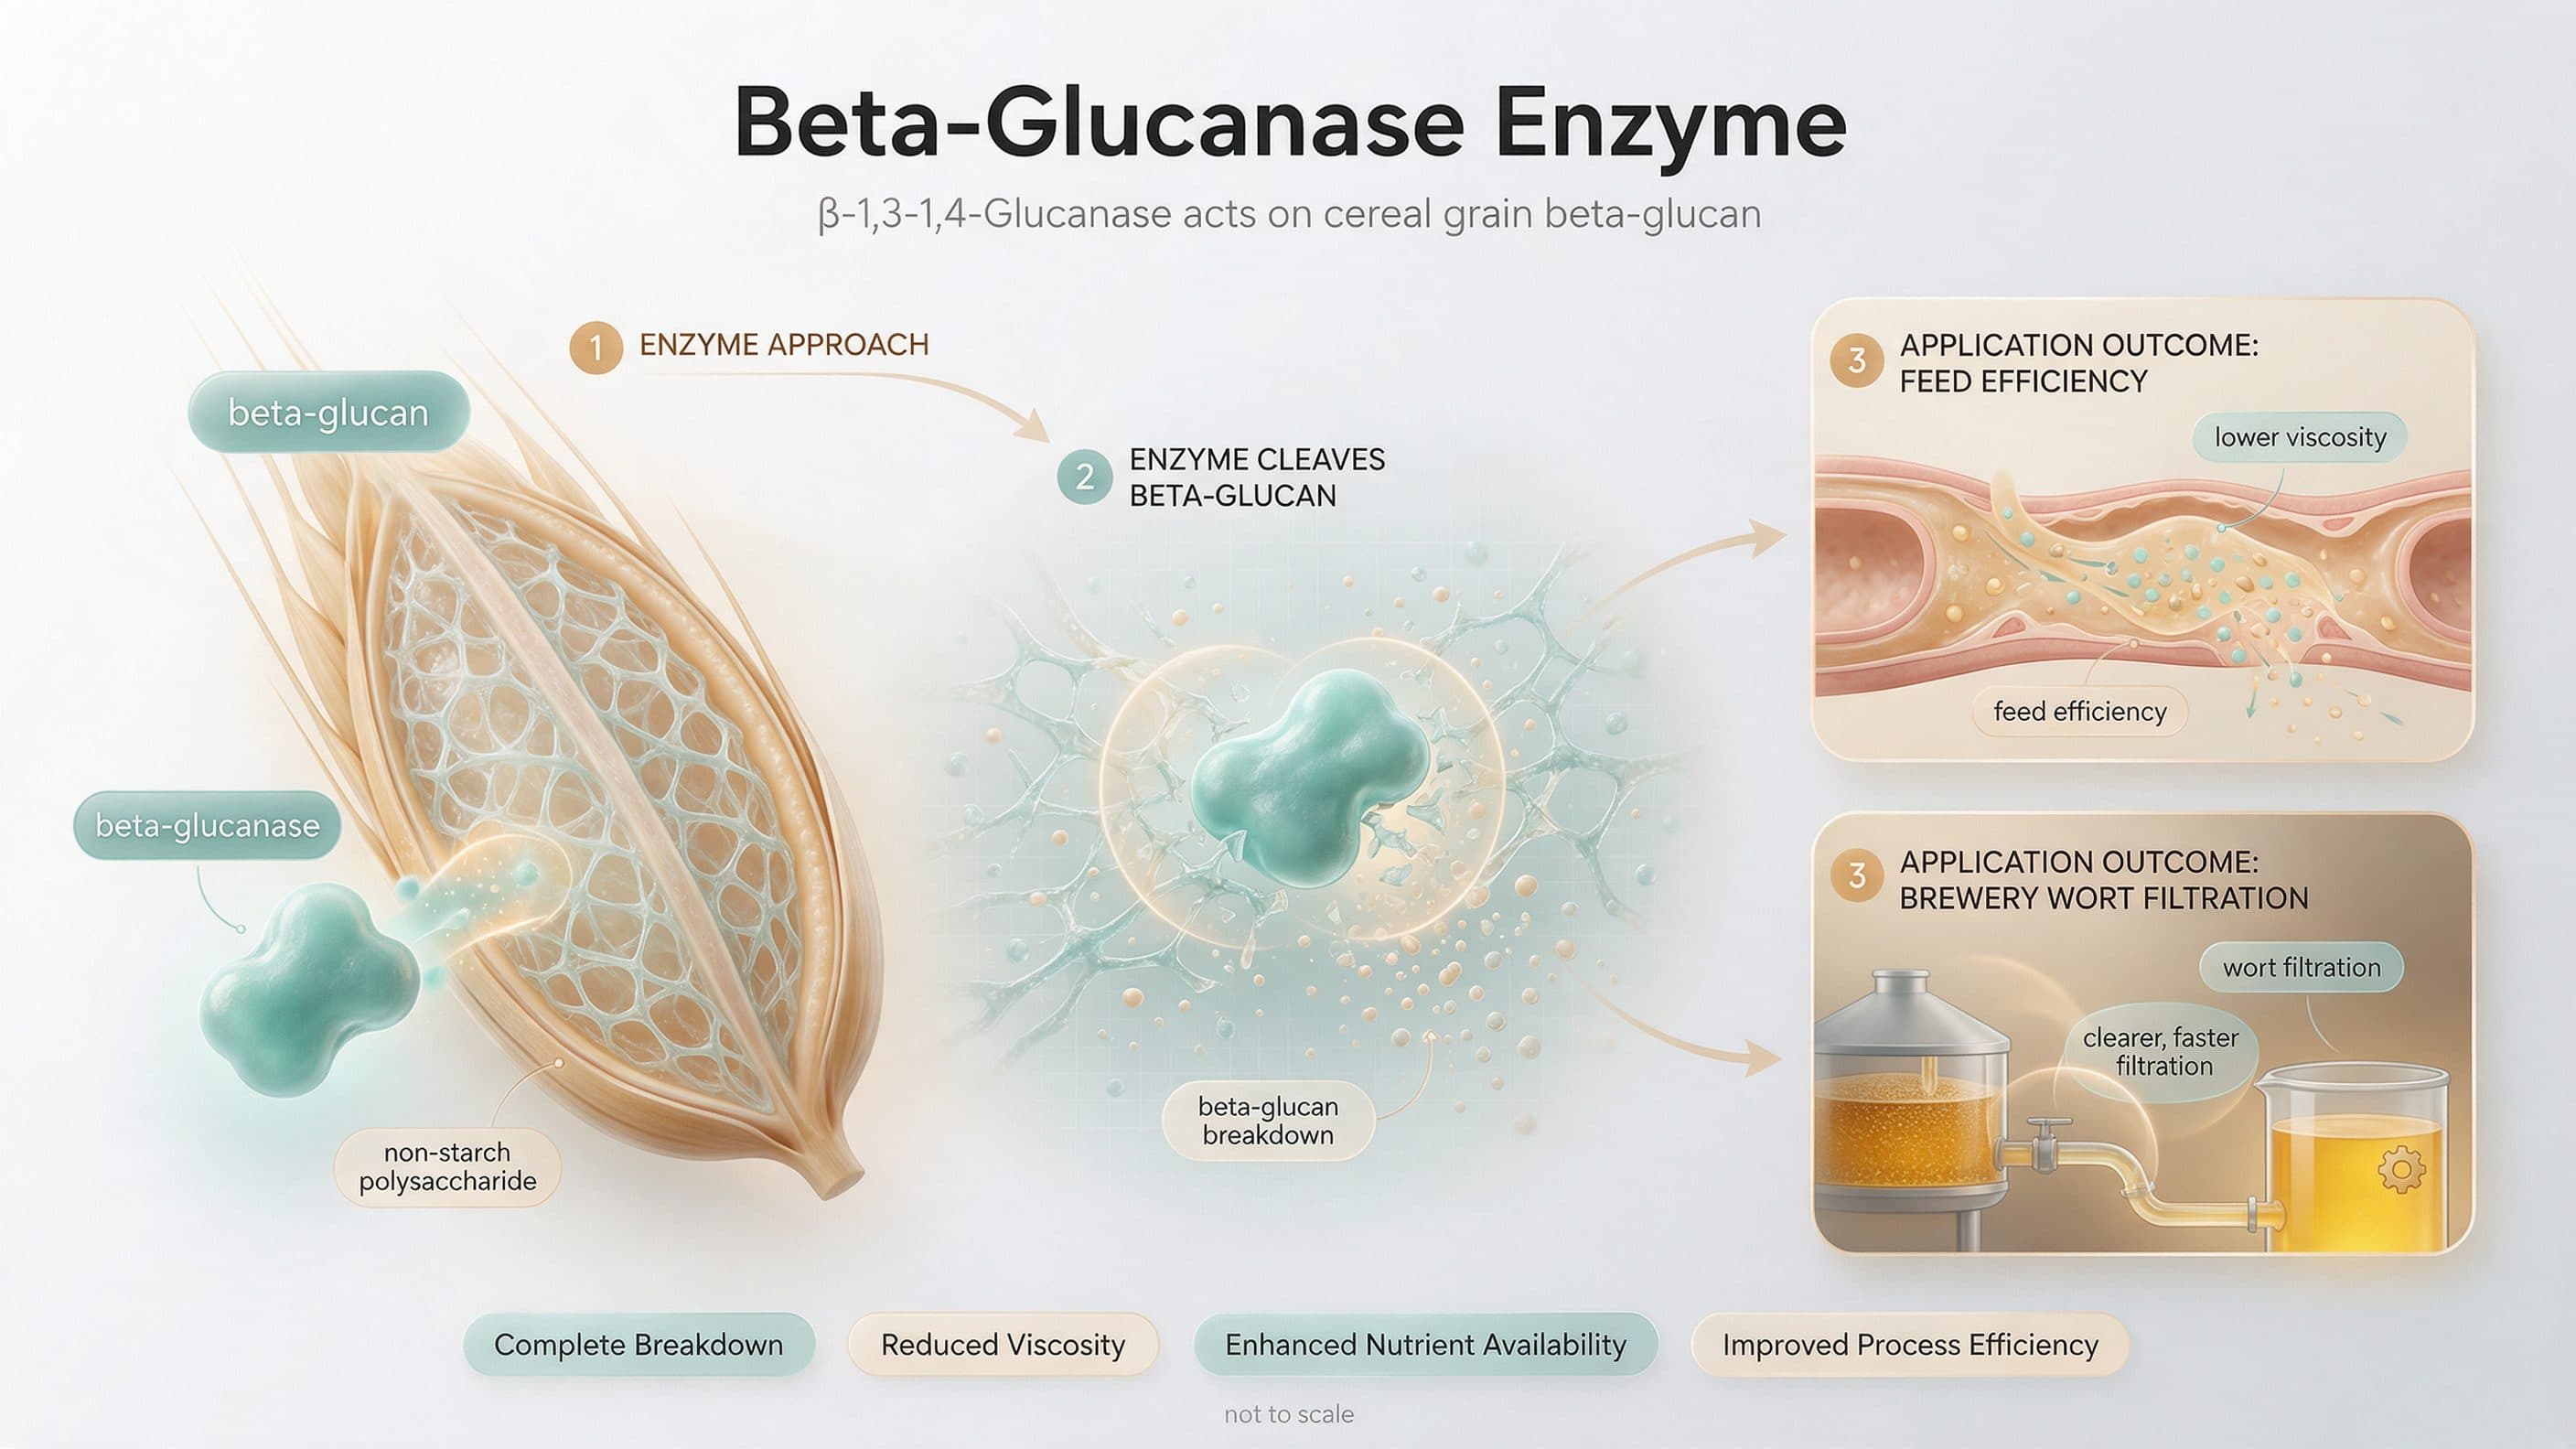
葡聚糖酶:破解谷物β-葡聚糖黏度瓶颈的工业酶,从酿造到饲料的增效利器
β-葡聚糖是谷物细胞壁中的抗营养因子,会显著抬高麦汁与肠道食糜黏度,拖累酿造收得率与饲料利用率。β-1,3-1,4-葡聚糖酶(EC 3.2.1.73,地衣多糖酶)作为内切型糖苷水解酶,专一水解与β-1,3键相邻的β-1,4键,把高分子β-葡聚糖切成低黏度寡糖,从而改善过滤、提升胶体稳定性并释放营养。本文从黏度痛点切入,解析其分子机理、菌种来源、性能窗口、技术路线对比与工业化落地难点,并给出面向研发与采购的选型逻辑。
2026年11月3日
α-乙酰乳酸脱羧酶:从双乙酰拦截至酿造成熟提速的酶法选型指南
α-乙酰乳酸脱羧酶(α-acetolactate decarboxylase,简称α-ALDC,EC 4.1.1.5)是一种金属依赖型羧基裂解酶,能在酿造过程中把α-乙酰乳酸直接脱羧生成乙偶姻,从而绕开双乙酰(2,3-丁二酮)的形成路径,显著缩短啤酒成熟时间。本文从双乙酰的黄油味痛点切入,解析其分子机理、催化特性与工业参数,对比菌株改造与物理控制等不同路线,并给出面向研发与采购的选型与工艺配置建议。
2026年11月3日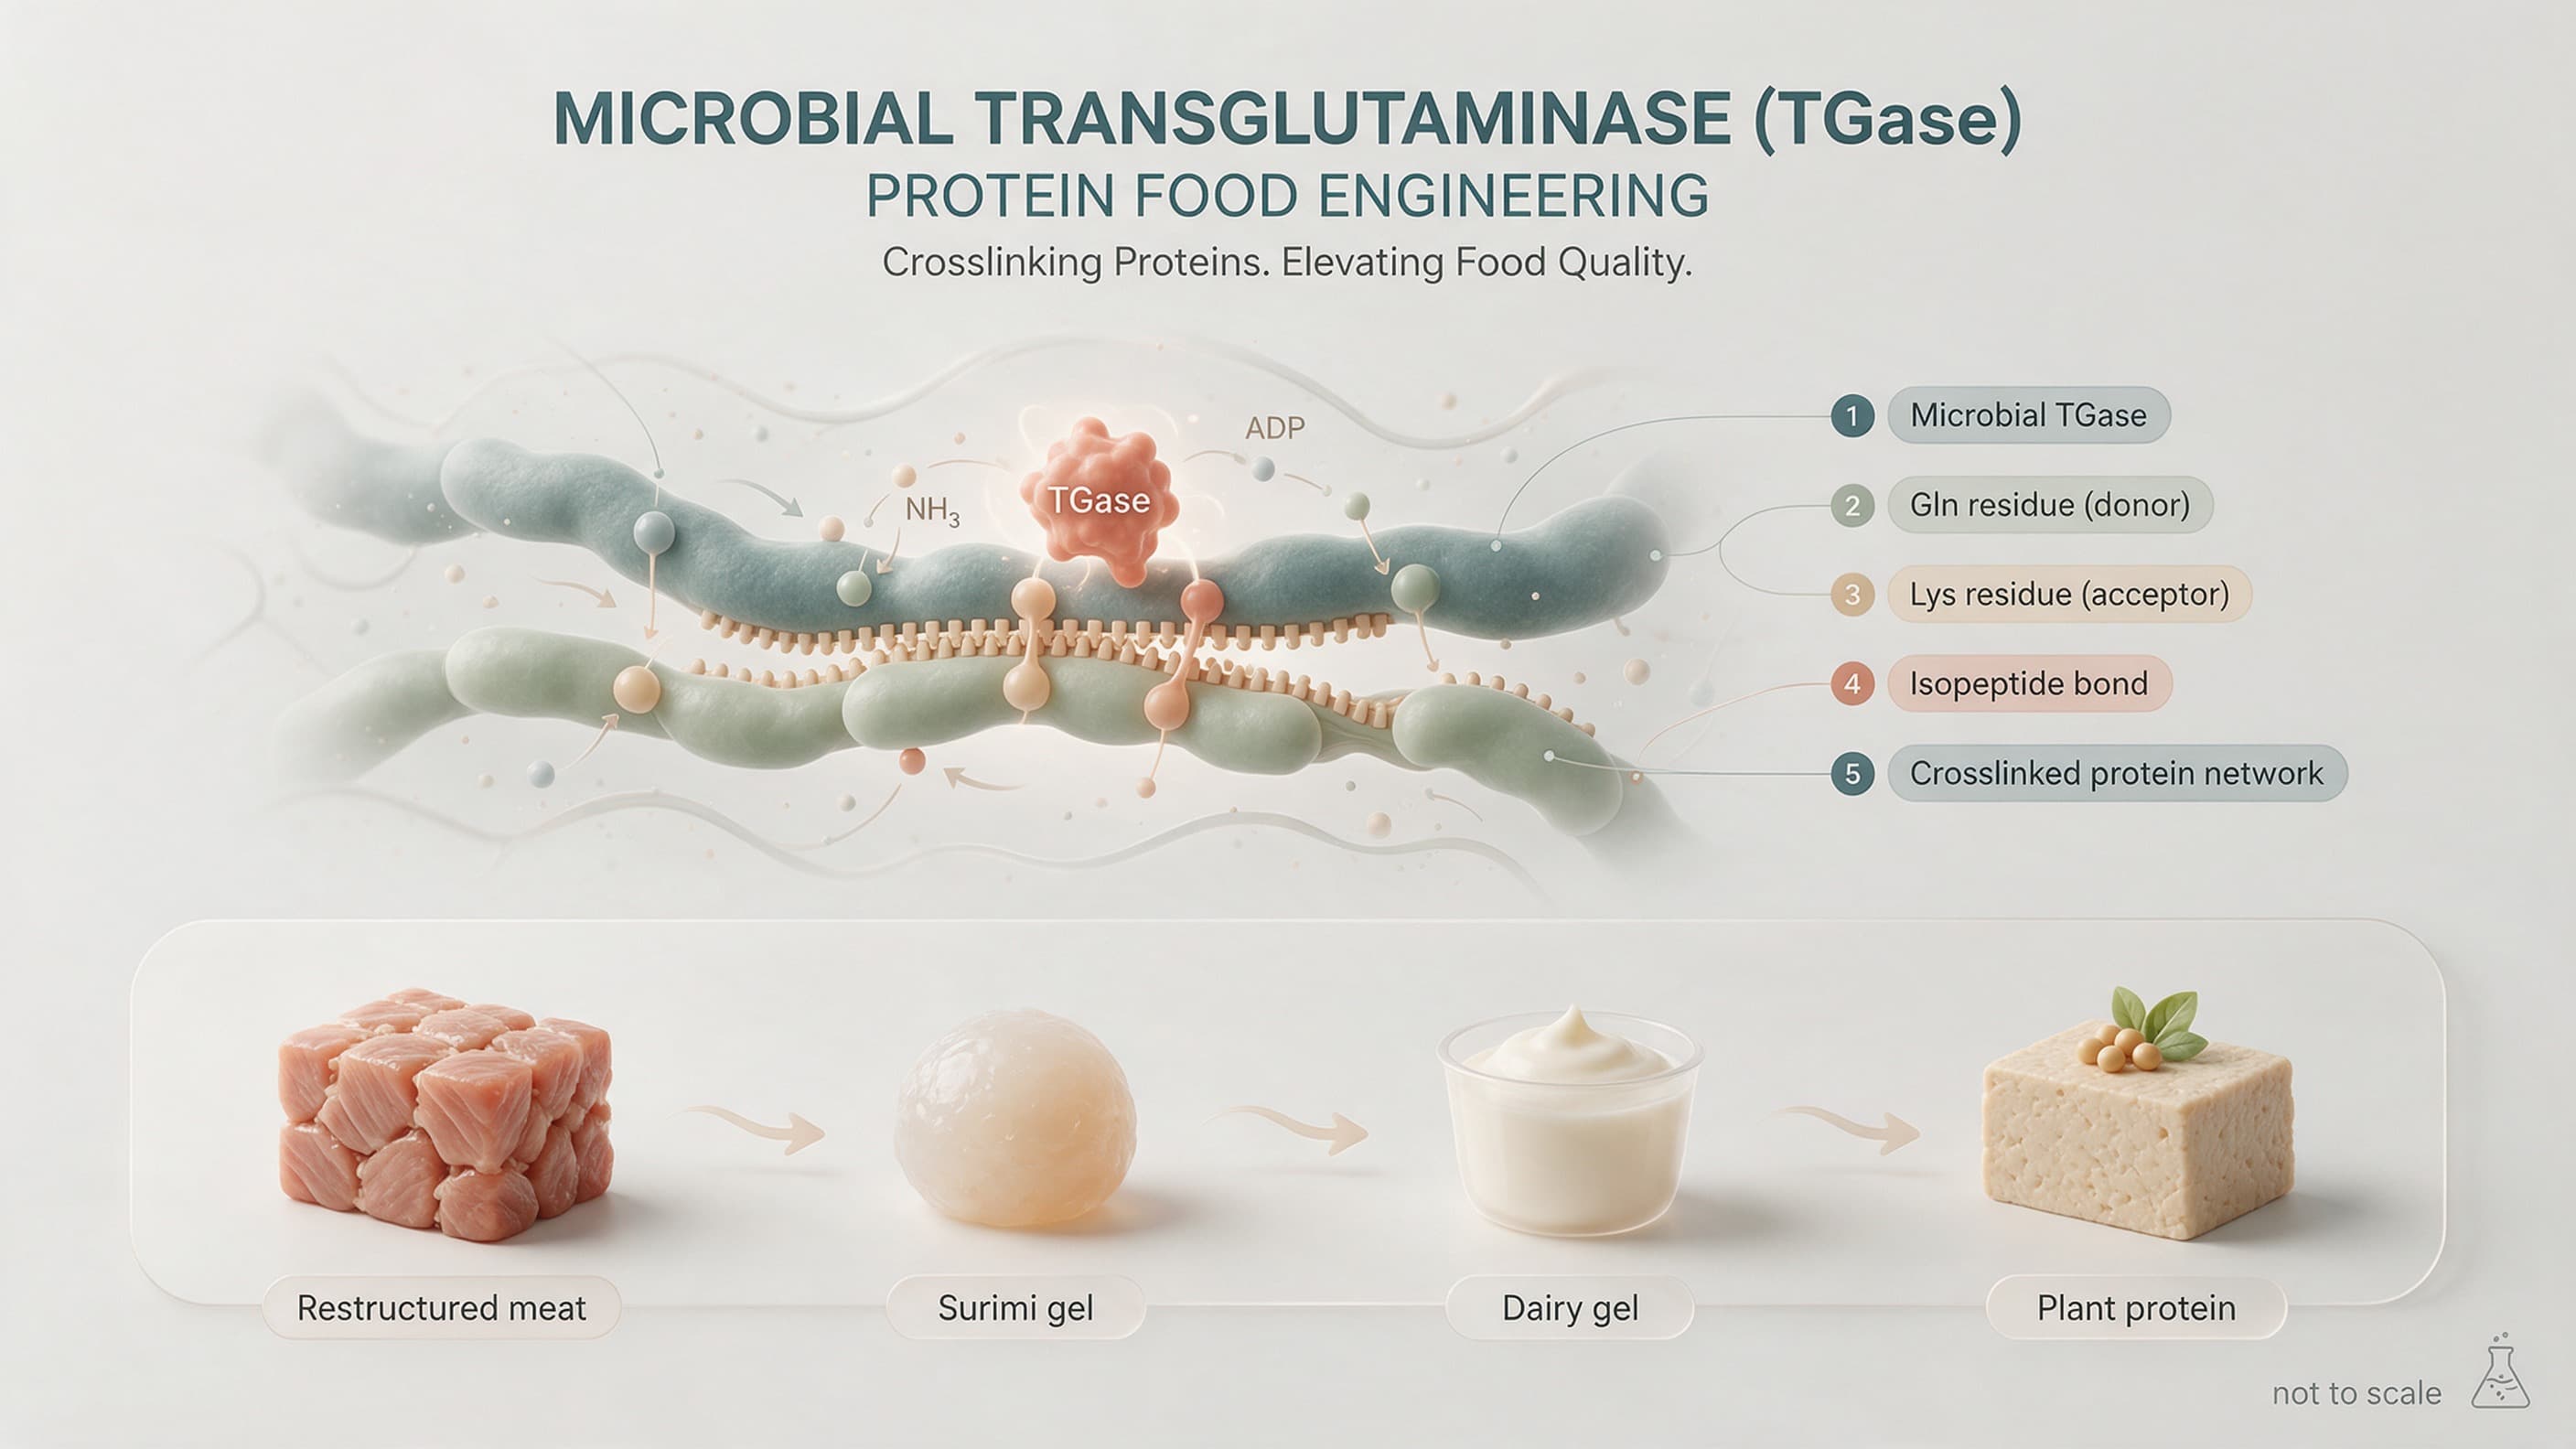
转谷氨酰胺酶:从蛋白质“分子胶水”到食品工业酶工程核心
转谷氨酰胺酶(TGase,EC 2.3.2.13)是一种催化蛋白质分子间共价交联的转移酶,通过构建ε-(γ-谷氨酰)赖氨酸异肽键,把分散蛋白质“缝合”成致密网络。微生物来源的mTG因钙离子依赖弱、耐热耐酸碱、来源广且成本低,成为肉制品重组、鱼糜凝胶、乳品与植物蛋白加工的核心酶制剂。本文以费曼双线思路先讲通通俗原理,再深入分子机理与工艺参数,为研发与采购提供选型逻辑。
2026年11月3日
生成式蛋白质设计平台:从序列到功能蛋白的新范式
生成式蛋白质设计平台把生成式AI(扩散模型、Transformer结构生成、语言模型)与高通量湿实验验证结合,在sequence/结构空间内按适应度景观搜索,通过“生成—打分—筛选—再训练”的干湿闭环持续逼近目标功能。本文从背景、原理、测定选型、条件工艺四层拆解其能力边界,说明天鹜科技MatwingsVenus®(晓鹜®)如何把生成式设计落地为可交付的蛋白开发工具。
2026年11月3日