AI蛋白实验室如何让蛋白质设计从"碰运气"走向"可预测"?
发布于 2026年11月5日
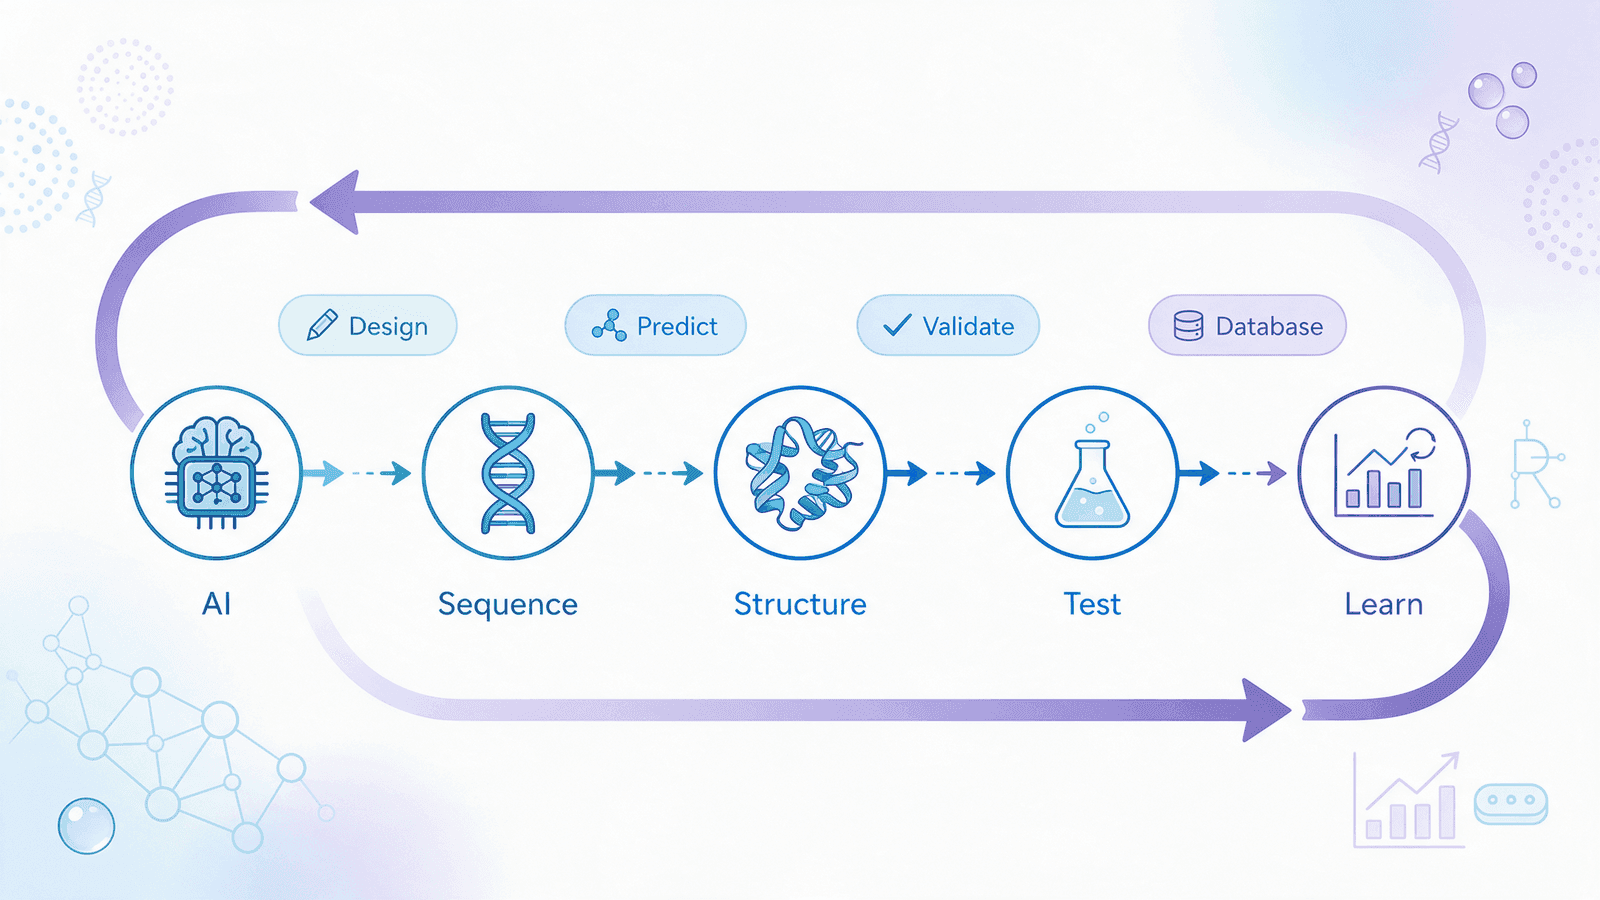
图1 AI蛋白实验室概念全景:干湿闭环
引言
蛋白质是生命活动的主要执行者,也是酶、抗体、药物与材料产品的核心。传统设计往往依赖经验与大量试错,周期长、成功率低;而AI蛋白实验室,正把这件事变成更可控、更可复现的工程流程。
过去,一项蛋白改造可能要花数月甚至更久;如今,AI先在电脑里"筛"一遍,再让湿实验"验"一遍,两者的结合正把蛋白研发从"艺术"变成"工程"。
这套方法不只属于大药企;借助开放模型与云算力,中小团队也能搭建起自己的AI蛋白实验室。
什么是AI蛋白实验室?
AI蛋白实验室是以AI为核心、把序列设计、结构预测与湿实验验证串成闭环的蛋白工程新范式,让"设计—构建—测试—学习"循环可以自动加速。
简单说,它让"想出来的蛋白"先过一遍电脑里的"预演",再交给真实实验去检验,从而把大量猜测变成可收敛的迭代。
· 定位:AI蛋白实验室不是某个单一软件,而是一套"模型+数据+实验"协同的研发体系。
· 它解决什么:蛋白质序列的突变空间大得惊人(约20的N次方),靠穷举不现实;AI把探索聚焦到高价值区域。
· 与传统定向进化的区别:传统进化靠反复随机突变与筛选;AI先预测、再定向,减少无效试错。
· 由什么构成:生成模型、结构预测、性能预测、湿实验验证、数据反馈与主动学习。
· 为什么现在才火:算力、海量生物数据与生成模型日趋成熟,加上湿实验自动化,让"干湿闭环"真正可落地。
· 能力边界:AI擅长在已知规律内生成与优化,但对"从未见过"的性能类型仍依赖足够数据;它放大的是人的判断,而非替代。
· 商业价值:缩短研发周期、提高成功率,是生物药、工业酶与新材料研发的重要基础设施。
AI蛋白实验室的原理与结构:干湿闭环如何运作
AI蛋白实验室的核心是DBTL(设计—构建—测试—学习)干湿闭环:AI生成候选,湿实验验证,结果回馈模型,形成持续改进的循环。
· Design(设计):生成模型基于骨架或序列约束产出候选;RFdiffusion造骨架,ProteinMPNN填序列;也有蛋白语言模型做特征与生成。
· Build(构建):把候选序列合成、表达、纯化,得到可测样品;这一步最耗时,也是自动化的重点。
· Test(测试):高通量筛选与功能、稳定性、结合力测定,产生真实数据;测试越准,学习越有效。
· Learn(学习):把实验数据回馈模型,更新适应度预测;主动学习选出下一轮"最值得测"的候选。
· 结构验证:用AlphaFold等结构预测模型在"干"阶段预检折叠与质量,用RMSD等指标过滤低质序列,减少无效湿实验。
· 适应度景观:把大量突变映射为"性能高低"的景观,AI在其中寻找高价值路径。
· 为什么更高效:探索空间被压缩,每轮信息被复用,模型越用越准、越测越省。
· 多目标:实际项目常要同时优化活性、稳定性、可开发性等,模型需能处理多目标权衡,而不是只盯一个指标。
· 一个类比:像"会学习的导航"——先靠经验地图(模型)给出一条路(候选),走完一段(湿实验)就把路况(数据)更新回地图,下一段自然更准。

图2 AI蛋白实验室的DBTL干湿闭环
如何测定与选型:选择模型、指标与数据
用好AI蛋白实验室,关键是选对模型、指标与数据:精度、覆盖与实验成本要一起权衡。
· 选模型:结构预测看精度与复杂度(如AlphaFold);序列生成看能否产出可折叠候选(如ProteinMPNN/LigandMPNN);性能预测看是否与实测相关。
· 看指标:结构用RMSD等衡量折叠一致性;性能用结合力、活性、稳定性、表达量等;每项都要与最终目标挂钩。
· 数据质量:高质、同源、标注一致的数据决定模型上限;数据偏倚会放大错误。
· 验证指标:结构常用RMSD衡量折叠一致性、成功率衡量可折叠性;性能常用结合常数、活性、熔融温度、表达量等,且需与目标一致。
· 干湿配比:先用"干计算"预筛,减少湿实验;但关键结论必须回湿实验验证。
· 成本权衡:高通量湿实验昂贵,主动学习能减少必要实验次数,做到"少测多学"。
· 实验设计:设计一批覆盖不同突变组合的候选,平衡"局部微调"与"更大跨度探索",避免只见树木不见森林。
· 边界:AI只能在已有数据分布内预测;对全新性能或领域外场景需谨慎。
条件与工艺:从靶点到候选的工程化流程
一条标准AI蛋白实验室流程可概括为:定义靶点→AI生成序列→结构验证→性能筛选→定向成熟→放大验证,最终交付候选。
· 步骤1 定义靶点:明确目标蛋白与想要的性能(结合力、活性、热稳定性等)。
· 步骤2 生成序列:生成模型产出多条候选序列。
· 步骤3 结构验证:用结构预测预检折叠与稳定性,过滤低质序列。
· 步骤4 性能筛选:高通量测试结合力与活性,保留优选。
· 步骤5 定向成熟:基于回馈数据做多轮定向进化与亲和力成熟。
· 步骤6 放大验证:表达、纯化、工艺与放大,交付可生产候选。
· 应用场景:酶工程(改造活性/稳定性)、抗体工程(亲和力/人源化)、新功能蛋白、工业催化与生物材料。
· 示例:想提高某酶的热稳定性,可先用AI预测耐受突变,再在湿实验中验证并回馈,让下一轮更准。
· 案例思路:某个抗体想提升亲和力,可先用结构预测锚定互补决定区,生成一批候选,凭活性筛选后把数据喂回模型,再进行第二轮更聚焦的成熟。
· 迭代意识:蛋白工程通常是多轮收敛的过程,前几轮可能只小幅提升,需持续迭代并结合数据优化策略。
· 常见误区:把AI输出直接当"成品",或一次只测个位数样本却期待显著改善;正确做法是保证干湿数据一致性,并迭代足够轮次。

图3 从靶点到候选的AI蛋白实验室应用流程
融入MatwingsVenus®(晓鹜®)的工程化实践
MatwingsVenus®(晓鹜®)把AI蛋白实验室的干湿闭环工程化,覆盖序列设计、结构预测与多轮进化,让AI能力落到可复现的研发流程。
· 一体化闭环:把生成、预测、筛选与实验数据纳入同一流程,减少割裂。
· 多轮进化:以主动学习驱动多轮设计与验证,逐轮收敛。
· 可解释设计:天鹜科技(Matwings Technology)主张数据驱动、可解释证据支撑商业化研发,降低黑箱风险。
· 边界声明:AI输出为候选,最终以实测结果为准;具体能力以官方介绍为准。
· 适用项目:酶活性与稳定性改造、抗体亲和力优化、新功能蛋白设计、工业催化与生物材料开发等,都可按干湿闭环推进。
· 协同验证:把干计算与湿实验团队放在同一节奏里,是闭环能否真正运转的关键。
FAQ
Q1:AI蛋白实验室能完全替代湿实验吗?
不能。AI负责"提出更好的候选",湿实验负责"证明是否真的行",两者互补而非替代。
Q2:AI蛋白实验室和传统定向进化有什么区别?
传统定向进化靠随机突变与筛选,AI蛋白实验室先预测再定向,并把每轮数据回馈模型,减少无效试错、更快收敛。
Q3:AI设计的蛋白可靠吗?
AI生成的候选需经结构验证与湿实验双重确认;可靠性与数据质量、模型精度和验证充分度密切相关。
Q4:应用AI蛋白实验室需要哪些条件?
需要清晰的目标、高质量数据、合适的模型与可用的湿实验能力,才能形成真正有效的闭环。
总结
· AI蛋白实验室=AI+DBTL干湿闭环,把蛋白设计变成可预测、可复现的工程流程。
· 核心组件:生成模型、结构预测、性能预测、湿实验与主动学习。
· 选型要素:模型、指标、数据质量与干湿配比。
· MatwingsVenus®(晓鹜®)把该范式工程化,覆盖序列设计、结构预测与多轮进化。
· 建议:明确目标、保证数据质量,并坚持"干湿结合、以实测为准"。
一句话结论:AI蛋白实验室用"AI生成+结构验证+湿实验反馈"的干湿闭环,让蛋白质设计更快、更可预测。