STRING蛋白互作数据库如何帮你读懂细胞内的蛋白质网络?
发布于 2026年11月5日
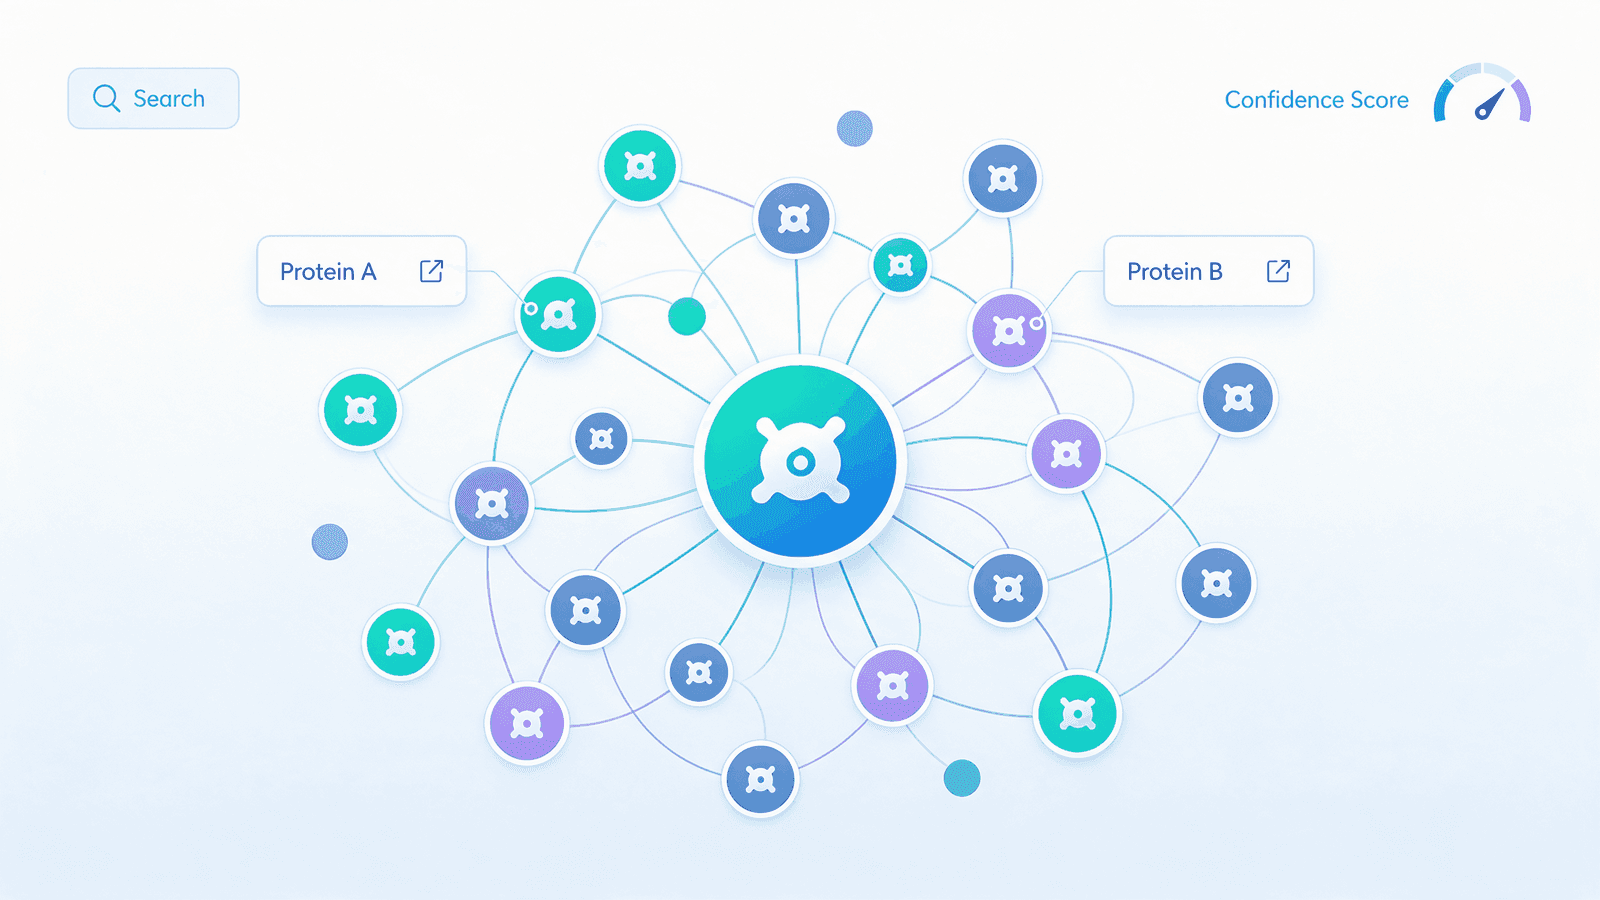
图1 STRING蛋白互作数据库的概念网络全景
引言
细胞内的蛋白质几乎从不单独行动。它们通过物理结合或功能协作,形成复合物、信号通路与调控网络;只看单个蛋白,往往无法理解它究竟在做什么。研究者真正需要的,是一张"谁和谁发生关联"的全局图谱。STRING蛋白互作数据库(Search Tool for the Retrieval of Interacting Genes/Proteins)正是这样一张可搜索、可打分、可下载的全局网络。
换句话说,STRING把散落在实验与文献中的碎片化证据,变成了一张可以"直接提问"的知识图谱。无论你是刚开始接触组学的新手,还是需要为靶点筛选搭建证据链的资深研究者,都能从这里找到起点;它也因此常被当作"我的基因和谁有联系?"这类问题的默认答案。
什么是STRING蛋白互作数据库?
STRING蛋白互作数据库是一个免费开放的公共资源,把散布在实验、文献和计算预测里的蛋白互作信息,整合成一张覆盖众多物种、可搜索可打分可下载的全局网络。
· 它的定位:STRING由瑞士生物信息学研究所(SIB)、诺和诺德基金会蛋白质研究中心(CPR)与欧洲分子生物学实验室(EMBL)等联合维护,被全球生物数据联盟与ELIXIR指定为核心数据资源(Core Data Resource)。
· 它的规模:截至STRING 12.5,收录约5930万个蛋白质、覆盖12535个物种;2023年的12.0版即已上报约5900万蛋白质、超过1.2万个物种。从人类、小鼠、大肠杆菌到植物与病原体,绝大多数常见模式生物都在其中。
· 它整合什么:既收录物理互作(如两个蛋白直接结合),也收录功能关联(如同属一条通路、共调控、共表达),并在两者间保持区分。
· 它输出什么:可交互的网络视图、逐条互作的置信度分数、通路与功能富集分析、网络聚类,以及可复现的批量下载与程序化API。
STRING的原理与结构:从证据到置信度分数
STRING的核心不是去"测"互作,而是把多条近似独立的证据通道概率式地合并成一个0–1的置信度分数,回答"这条互作到底有多可信"。
· 七条证据通道:STRING将所有证据归入七类通道——①实验互作(整合BioGRID、HPRD、MINT等);②人工审编数据库/通路(KEGG、Reactome、BioCyc、Gene Ontology等,该通道统一给予0.900高分);③文献文本挖掘(统计显著的基因共现,也含OMIM);④共表达数据;⑤基因组邻接;⑥基因融合;⑦系统发育共现。其中⑤⑥⑦属于基因组上下文预测。
· 分数是置信度,不是强度:STRING官方明确,分数不表示互作强度或特异性,而是"这条互作是否真实存在"的置信度指标,并经基准校准;0.5大致意味着约每两条互作里可能有一条是假阳性。
· 阈值怎么设:界面分数范围0.150–0.999(下载文件为150–999)。常用三档:中等≥0.4(更全但更噪)、高≥0.7(精度与覆盖平衡)、最高≥0.9(只留高置信)。
· 合并方式:各通道作为近似独立的信息来源被概率式合并(Naive Bayes式),而通道内部来源往往并不独立,因此合并打分时通道间权重更被看重。
· 网络怎么看:在网络视图里,每条连接线通常按置信度着色,鼠标悬停即可查看它来自哪些通道;你也可以关闭某一通道,观察网络是否被明显削弱。这种"可解释的透明度",正是STRING被广泛用作默认起点的原因之一。
· 2025年新能力:STRING 12.5引入调控网络(regulatory network),用审编通路数据库加微调语言模型解析文献,标出互作的类型与方向性;可分别查看功能、物理、调控三类网络。同时富集分析更新了FDR校正与冗余过滤。

图2 七类证据通道经合并器输出0–1置信度分数
如何测定与选型:为你的问题选择合适的证据与阈值
STRING不替你测互作,而是把别人测过、算过的结果整理打分;因此选型的关键是选定正确的物种、证据通道与置信度阈值。
· 输入方式:可输入一个或多个基因/蛋白的标识符(如UniProt、Ensembl、NCBI编号),也可直接提交序列做同源映射。
· 选对物种:STRING覆盖12535个物种,每次分析都要定位到对应NCBI分类号;生物学结论只在同一物种内成立,跨物种推断需谨慎。
· 选对证据通道:不同问题看重不同通道。研究物理结合优先看experimental与database通道;研究功能/共调控可结合text-mining与co-expression;做跨物种泛化可参考基因组上下文类预测通道。
· 选对阈值:探索性分析用0.4更全面,验证性分析用0.7或0.9更严格;做差异表达等发现性筛选时,通常推荐先宽后严。
· 记录元数据:版本、物种、阈值、活跃通道、分析日期一并记录,保证结果可复现、可引用。
· 实用技巧:先做"窄而严"的高置信初筛,定位核心模块;再放宽到0.4找回较弱的间接关联,得到的基因集合往往更完整、更接近真实生物学。
· 知道边界:分数是置信度而非交互强度;文本挖掘通道天然含噪声;仅来自计算预测的通道通常不附带PMID;不同物种间的证据可比性有限。
条件与工艺:从序列到网络再到靶点的高效工作流
一个标准STRING工作流可概括为:定义目标蛋白→构建/检索网络→按置信度与通道筛选→聚类与富集→定位关键节点或候选靶点。
· 步骤1 定义目标:导入序列或ID,确认所在物种。
· 步骤2 构建网络:默认展示完整网络,可切换evidence、confidence或interactive等视图。
· 步骤3 筛选:设定置信度阈值与最大互作数,剔除低置信连接。
· 步骤4 提取与导出:下载PSI-MITAB或TSV文件,或直接导出网络图。
· 步骤5 富集与聚类:对网络做GO、KEGG、Reactome富集,识别功能模块与hub节点。
· 步骤6 验证:把候选带入湿实验或后续计算验证。
· 与组学衔接:把差异表达/差异磷酸化基因列表映射到网络,快速缩小候选范围,看模块与通路。
· 规模化:支持批量下载与REST API,适合大批量、流程化分析。
· 举个例子:你若关心某个与肿瘤相关的hub蛋白,可在STRING中拉出它的互作伙伴,做通路富集后常能看到细胞周期、DNA修复等模块,据此锁定更值得验证的候选基因。
· 应用场景:微生物与动植物系统生物学、宿主—病原互作、疫苗与药物靶点发现、多组学整合。

图3 从蛋白列表到候选靶点的STRING分析工作流
融入MatwingsVenus®(晓鹜®)的蛋白工程闭环
MatwingsVenus®(晓鹜®)的AI蛋白工程平台能把STRING这类公共互作证据接进"发现—设计—验证"闭环,让候选改造更有生物学依据。
· 先验网络:目标蛋白的互作伙伴、通路归属与功能模块,可作为设计约束与功能注释来源,减少"凭感觉挑位点"。
· 闭环衔接:把网络证据输入到序列设计、结构建模、亲和力成熟与多轮进化等环节,转化为可筛选的候选。
· 可解释设计:天鹜科技(Matwings Technology)主张数据驱动,用可解释的网络证据支撑商业化研发,降低黑箱风险。
· 边界声明:公共数据库证据用于指明方向,最终仍以实测数据为准,避免把预测当结论。
FAQ
Q1:STRING和PPI有什么区别?
PPI指蛋白质之间的相互作用本身,而STRING是收集、打分并整合这些相互作用的一个数据库与在线工具;前者是生物学概念,后者是承载该概念的数据与计算平台。
Q2:STRING的置信度分数越高越好吗?
不一定。分数越高代表互作越可能真实,但高阈值会漏掉真实却证据不足的互作;应根据是"发现"还是"验证"来选择阈值,而不是一味追高。
Q3:STRING能代替实验验证吗?
不能。STRING是整合与打分的公共资源,其分数是置信度而非实验事实;关键互作仍需湿实验或正交方法确认。
Q4:STRING免费吗?可以商用吗?
STRING免费开放网页访问、批量下载与API,可用于学术和商业研究;具体引用义务与使用条款请以官方网站为准。
总结
· STRING把分散的蛋白互作证据变成一张可解释的全局网络,核心是"七条通道+概率式合并+0–1置信度"。
· 选型关键是物种、证据通道、阈值三者的匹配。
· 12.5新增调控网络与方向性标注,让网络更贴近真实调控逻辑。
· MatwingsVenus®(晓鹜®)把公共网络证据接入"发现—设计—验证"闭环,让工程候选更有依据。
· 建议:先明确问题类型,再选通道与阈值,最后用实验验证关键结论。