BLASTp蛋白质比对如何帮你从一条序列找到它的同源蛋白?
发布于 2026年11月5日
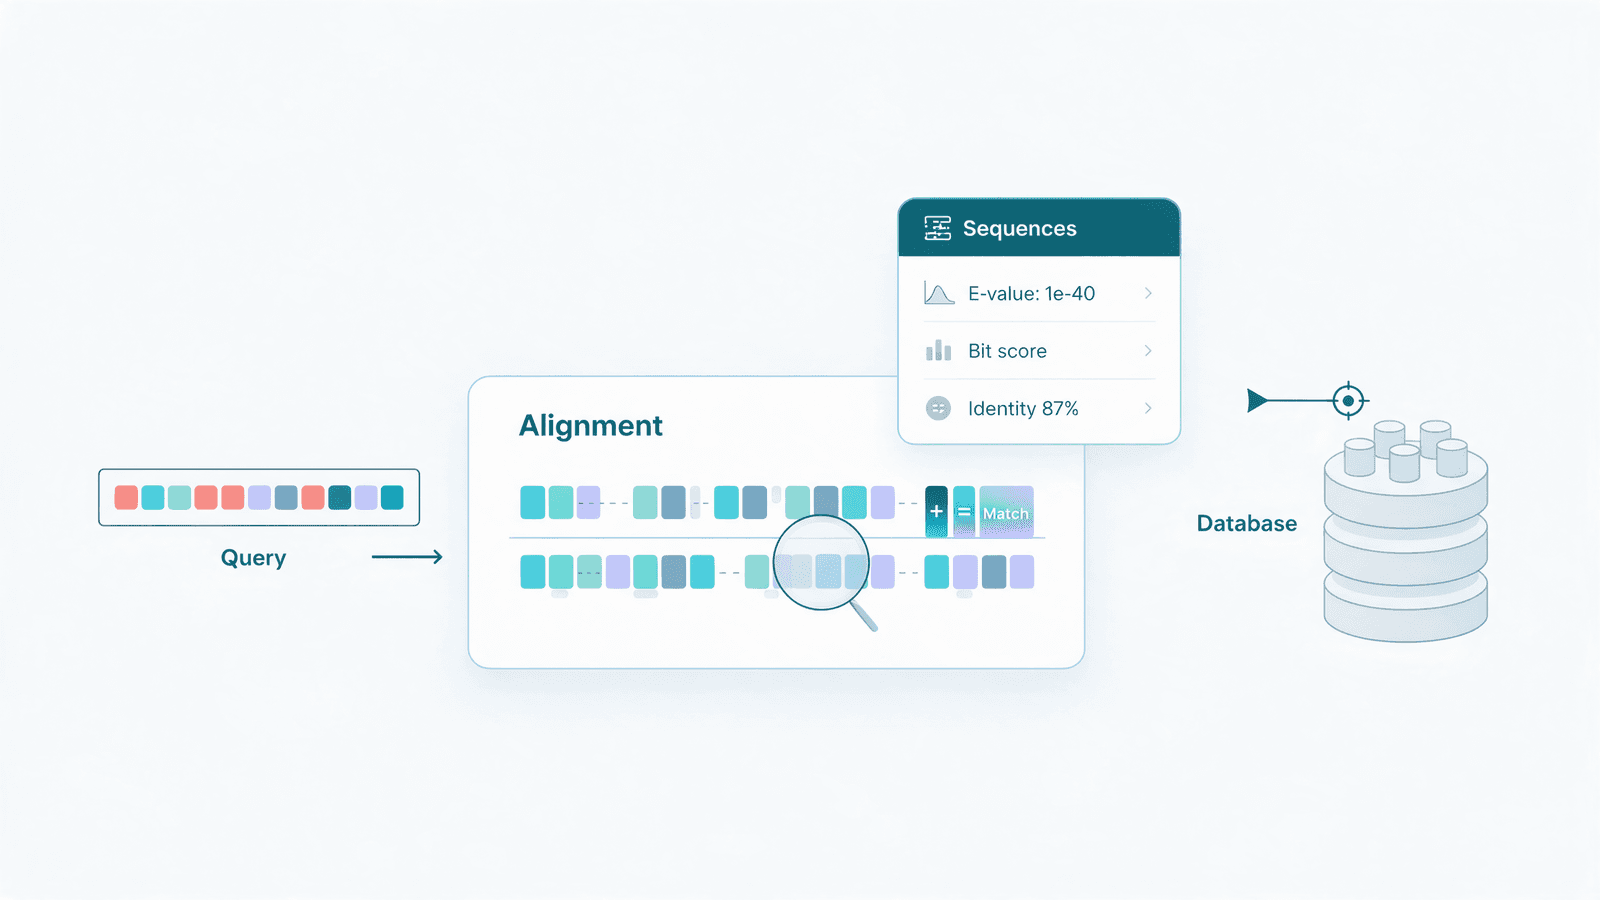
图1 BLASTp蛋白相似性搜索的概念全景
引言
拿到一条蛋白序列,第一个问题往往是"它是谁?和哪些已知蛋白相似?"。要回答这类问题,你需要的是一把能快速"在蛋白库里找相似"的尺子。BLASTp蛋白质比对正是这样一把被全球研究者使用了几十年的经典尺子。
很多时候,功能未知的蛋白就藏在一堆"看起来熟悉却又不同"的序列里;BLASTp用它"以短打长"的聪明策略,在几秒内帮你筛出最值得关注的同源候选。
什么是BLASTp蛋白质比对?
BLASTp是Basic Local Alignment Search Tool的蛋白质版本,把一条蛋白查询序列拿去与蛋白数据库比对,快速找出局部相似的序列并给出统计显著性判断。
· 它的来历:BLAST由Altschul等人在1990年提出;BLASTp是其中"蛋白序列对蛋白序列"的程序,也是日常用得最多的版本之一。
· 它用来做什么:识别未知蛋白、推断同源与功能、寻找基因家族成员、为功能注释提供证据。
· 谁在用:从鉴定新测序蛋白、注释基因组,到为酶工程选定起点,BLASTp都是绕不开的第一步。
· 和BLASTn等区别:BLASTp比的是氨基酸;BLASTn比核酸;blastx把核酸翻译后比对蛋白;tblastn用蛋白比对翻译后的核酸。对蛋白问题,BLASTp往往比核酸比对更能捕获远缘同源。
· 怎么用:NCBI WebBLAST免费开放,也能命令行或本地运行。
· 它的局限:BLASTp擅长局部相似性,但远缘同源可能因矩阵与阈值而漏检,需要结合profile或结构搜索互补。
· 输出什么:图形摘要、按显著性排序的描述列表,以及逐条比对(含一致度、E-value、bit score与覆盖度)。
BLASTp的原理与结构:从种子词到E-value
BLASTp不是把两条序列从头到尾比对,而是"局部"搜索:先用短种子词命中候选位点,再向两侧延伸,最后用替换矩阵打分并给出统计显著性。
· 种子词(seed word):默认word size为3,也就是把查询断成三个氨基酸的短词,在数据库里找匹配,迅速缩小搜索范围。
· 无空位延伸(ungapped extension):种子命中后向两侧延伸,直到分数开始下降为止。
· 带空位延伸(gapped extension):引入gap开启与延伸惩罚,允许插入或缺失,得到更贴近真实的比对。
· 替换矩阵BLOSUM62:默认矩阵。矩阵里的每个分数,是"观测替换频率除以背景频率"的对数几率;侧链大小与化学性质相近的替换为正分(如天冬氨酸D/谷氨酸E),差别大的为负分(如苯丙氨酸F/谷氨酰胺Q)。BLOSUM62包含最多约62%一致度的信息,被认为是最通用的默认选择。
· 怎么算分:BLAST score由匹配正分、错配与gap负分相加得到。
· 统计显著性:E-value(期望值)指在随机库中,出现该分数或更高分数的期望条数,越低越显著;WebBLAST默认Expect阈值为0.05,经验上低于0.001可视为显著。bit score与数据库大小无关,适合跨批次比较。
· 细节处理:低复杂度区域会被掩蔽(masking),避免重复序列造成假命中;需要更远缘同源时,可用迭代式的PSI-BLAST构建profile。
· 为什么快:BLASTp把"全库全序列比对"压缩成"种子词命中+局部延伸",用近乎线性的速度完成传统动态规划需要很久才能跑完的工作,这是它成为默认工具的关键。
· 打个比方:可以把它想成在图书馆里找书——先按书名首字母(种子词)锁定可能相关的书架,再逐本翻看(延伸),而不是把整座图书馆逐字读一遍。
· gap惩罚:gap开启与延伸惩罚控制"允许多少插入缺失",惩罚越大越保守、越小越宽松,可依比对目标调节。

图2 BLASTp算法流程:种子词→延伸→带空位比对→E-value
如何测定与选型:看懂结果、选对程序与参数
BLASTp的结果判断有固定套路:先看E-value与bit score,再看一致度与覆盖度,最后结合生物学背景判断是否真正同源。
· 先看E-value与bit score:E-value越低越显著;bit score越高越好,且不受库大小影响,适合比较不同查询。
· 再看一致度与覆盖度:一致度(identity)反映相似程度,覆盖度(query coverage)反映比对覆盖查询全长的程度;两者要一起看,才能避免"只比上一小段"的假象。
· 选对程序:已知近缘蛋白用blastp;想找远缘同源用PSI-BLAST;手头只有核酸序列却想查蛋白,用blastx。
· 选对参数:word size调小(如2)更敏感但更慢;矩阵可按进化距离选(BLOSUM80适合更近缘、BLOSUM50适合更远缘);gap惩罚按需调整。
· 选对数据库:nr(非冗余)最全面;要更可靠注释可选UniProtKB/Swiss-Prot;限定物种可提升精度与速度。
· 阈值怎么定:只想确认"确实相关"就用更严的阈值(如<1e-10);想"尽量找全"就放宽(如<0.001),再靠后续筛选去噪。
· 经验口诀:E-value低于1e-5常被视为可信同源,介于1e-5到0.001属"值得一看",高于0.05多视为随机;具体阈值应结合研究目的设定。
· 注意边界:BLAST并不直接"测"同源性,只是给出支持同源推断的证据;一次显著命中,不等于两个蛋白功能一定相同。
条件与工艺:从序列到同源到功能的工作流
一条标准BLASTp工作流可概括为:提交查询→选库与参数→解读显著性→提取同源与注释→结合设计或验证。
· 步骤1 提交查询:粘贴蛋白序列或FASTA,可选限定物种或数据库。
· 步骤2 选数据库与参数:选择nr、Swiss-Prot等;设定word size、矩阵与阈值。
· 步骤3 解读结果:按E-value排序,标记显著命中,检查一致度与覆盖度。
· 步骤4 提取同源:收集高置信同源,查看保守残基与功能特征。
· 步骤5 注释与推断:结合GO与结构域数据库做功能注释,推断关键位点。
· 步骤6 衔接下游:把候选带入湿实验或工程改造。
· 应用场景:未知蛋白鉴定、基因家族分析、结构与功能注释、物种间同源推断、疫苗与药物靶点候选筛选、蛋白工程位点选择。
· 举个例子:若你想验证某条新测序蛋白的功能,可先用BLASTp在Swiss-Prot里找同源,往往能得到匹配的已知结构与功能注释,再据此设计实验或工程改造。
· 常见误区:只盯着最高一致度而忽略覆盖率,或把一次显著命中直接当成功能相同;正确做法是综合E-value、一致度、覆盖度与结构域证据。
· 规模化:支持批量查询与命令行/API,适合流程化流水线。

图3 从查询序列到功能推断与设计的BLASTp工作流
融入MatwingsVenus®(晓鹜®)的蛋白工程闭环
MatwingsVenus®(晓鹜®)的AI蛋白工程平台能把BLASTp这类同源检索结果接进"发现—设计—验证"闭环,让设计起点更有依据。
· 同源先验:BLASTp找到的同源蛋白与保守残基,可作为设计约束与功能注释来源,减少"凭空选位点"。
· 闭环衔接:把同源与功能信息输入序列设计、结构建模、亲和力成熟与多轮进化等环节,转化为可筛选的候选。
· 可解释设计:天鹜科技(Matwings Technology)主张数据驱动,用可解释的检索与结构证据支撑商业化研发,降低黑箱风险。
· 边界声明:检索证据用于指明方向,最终仍以实测数据为准,避免把比对结果当结论。
FAQ
Q1:BLASTp和BLASTn有什么区别?
BLASTp比对蛋白序列(氨基酸),BLASTn比对核酸序列;对蛋白关键词,BLASTp往往更能捕获远缘同源。
Q2:E-value越低越好吗?
是的。E-value越低,代表该分数在随机情况下出现的期望越少,比对越显著;但仍要结合一致度与覆盖度一起判断。
Q3:显著命中就代表同源或功能相同吗?
不一定。BLAST只给出支持同源推断的证据,显著命中仍需结合结构、功能或实验证据进一步确认。
Q4:BLASTp免费吗?
免费。NCBI WebBLAST免费开放,也可通过本地命令行或API使用。
总结
· BLASTp是经典的蛋白—蛋白局部比对工具,核心是"种子词+延伸+矩阵打分+统计显著性"。
· 结果解读关键看E-value、bit score、一致度与覆盖度。
· 选型要点:程序(blastp/PSI-BLAST/blastx)、矩阵、word size与数据库。
· MatwingsVenus®(晓鹜®)把同源检索结果接入工程设计闭环,让设计起点更有依据。
建议:先看显著性,再结合生物学背景,最后用实验验证关键结论。