ESM3蛋白质生成模型:AI如何「编程」蛋白质?
发布于 2026年11月5日
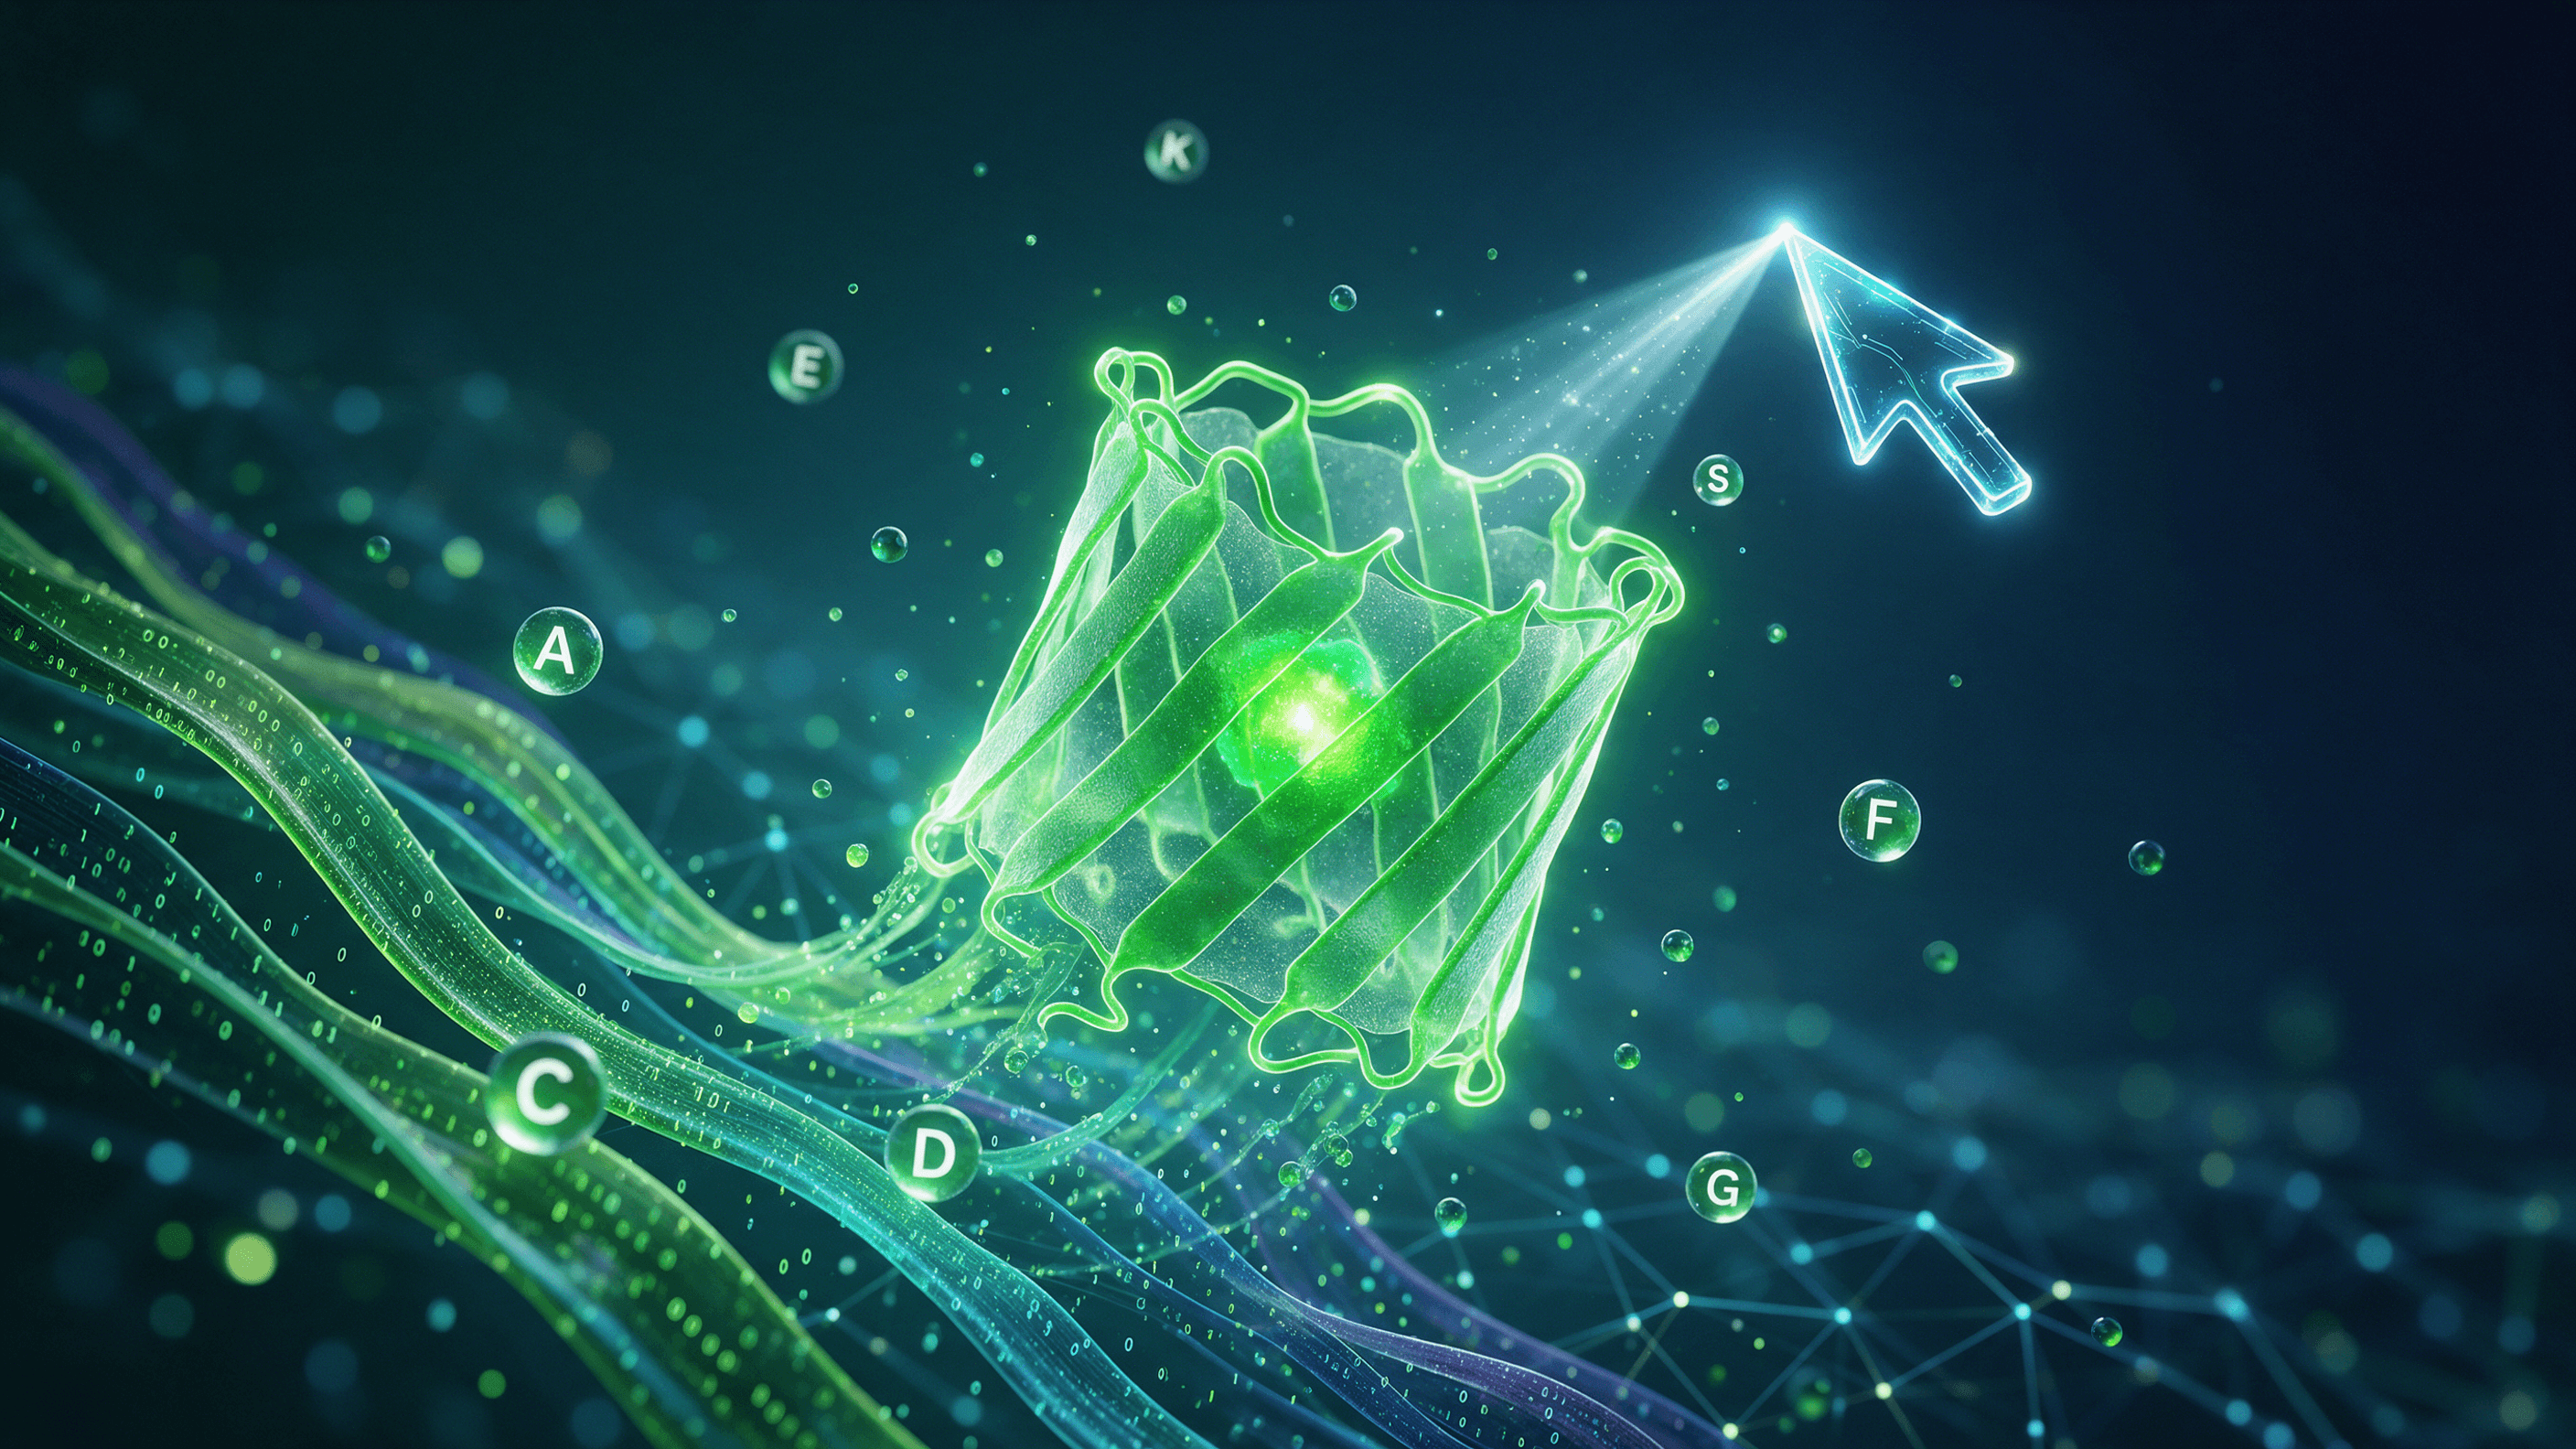
图1|ESM3将序列、结构与功能联合建模,像语言模型一样「编程」蛋白质
如果说AlphaFold让AI学会了「看懂」蛋白质结构,那么ESM3则让AI开始「创作」蛋白质。作为首个同时推理蛋白质序列、结构、功能的生物生成式模型,ESM3把生物学变成了一种可以「编程」的语言——你告诉它想要的功能、结构或序列线索,它就能生成自然界中从未存在过的新蛋白。在最具代表性的实验中,研究团队仅用一组发色团残基的「思维链」提示,就令ESM3生成了全新荧光蛋白esmGFP:它与最接近的天然蛋白仅有约58%同源,相当于在实验室里「模拟」了约5亿年的进化,并已在真实湿实验中验证发光。
背景:从「预测蛋白质」到「生成蛋白质」
蛋白质是一切生命功能的执行者,而人工改造蛋白质往往要在「保留功能」与「改变性质」之间反复权衡。传统的定向进化要在实验室里一轮一轮地突变、筛选,耗时长、成本高;以AlphaFold为代表的AI则擅长「预测」——给定序列,预测其结构。可真正让工程师惊喜的,是「生成」:不只回答「这个序列会折叠成什么样」,而是回答「给我一个能实现某功能的全新蛋白」。
ESM3正是在这一需求下诞生。它由EvolutionaryScale(创始团队多来自Meta/FAIR)于2024年6月发布,训练用了海量GPU算力(大模型约98B参数、训练计算量约1×10^24 FLOPS),数据覆盖地球上多种环境的数十亿蛋白,跨度可上溯到约38亿年的进化历史。它把序列、结构、功能三种「语言」同时建模——这正是它与此前只专精单一维度的蛋白模型的本质区别。
ESM3的原理与结构:序列、结构、功能三模态联合
ESM3的核心思想,是把蛋白质拆成三种「可编程」的模态,并让它们共享同一套表征:
• 序列(Sequence):氨基酸字母序列,相当于蛋白质的「文本」;
• 结构(Structure):原子的空间坐标与折叠形态,相当于蛋白质的「形状」;
• 功能(Function):功能token、基因本体(GO)等语义标签,相当于蛋白质的「用途」。
模型采用双向Transformer +几何注意力,把三类输入编码进一个共享的隐表征,再用掩码式的生成方式,从任意模态出发「补全/生成」其余部分。因此,ESM3既可以按结构生成序列、按功能生成结构,也可以在单一提示里同时约束多个维度。下图示意了这一三模态联合机制。

图2|ESM3的三模态机制:序列、结构、功能输入经共享表征后生成新蛋白
这一架构最直观的成果就是esmGFP。团队用「思维链」提示ESM3:保留负责形成并催化发色团的残基,以及天然GFP部分中央α螺旋的结构。ESM3在两次实验中都找到了远离已知GFP、却依旧明亮的候选蛋白;该蛋白被合成后,在大肠杆菌裂解液中实测到荧光。它仅与最接近的天然荧光蛋白(来自海葵*Entacmaea quadricolor*)约58%同源——这个距离,被估算为约5亿年的自然进化跨度。
能力边界与评测:一个好用的生成模型如何衡量
ESM3很强,但要「用好」它,先要看清它的边界:
• 生成≠保证正确。模型输出的是「候选」,其可折叠性、活性、稳定性需要实验证实。评测常用指标包括与已知蛋白的相似度/新颖度、可折叠性评分、以及在湿实验中的成功率。
• 预测≠实测。引用或比较时,应明确区分「模型预测」与「实验实测」。esmGFP的荧光是实测结果,而「5亿年进化跨度」是估算/推演,二者不能混为一谈。
• 单点vs多模态。若只关心「序列→结构」,AlphaFold等预测模型仍是更成熟的工具;ESM3的价值在于把「功能或结构约束」作为提示,去做多约束的设计,例如设计新型荧光探针、定制酶、甚至全新支架。
• 安全与可控。作为前沿基础模型,ESM3开放了小尺寸的ESM3-open权重,并配合安全策略;生成能力越强,越需要提示约束与湿实验闭环来约束风险。
条件与工艺:从提示到湿实验的「生成—合成—测试—学习」闭环
对真实研发来说,模型只是起点。一个可落地的流程是干湿闭环:AI生成候选设计(Design)→湿实验合成与表达(Synthesize)→检测功能表型,例如测荧光(Test/Assay)→把实验数据反馈给模型,用于偏好优化(Learn)→进入下一轮。这样一圈圈迭代,才把「生成」变成「可用的产品」。

图3|ESM3接入「生成—合成—测试—学习」干湿闭环
以esmGFP为例:提示发色团残基→ ESM3生成候选设计→合成并在大肠杆菌中表达→测定荧光。正是因为有了真实荧光这一「实测」反馈,设计才被确认有效。
MatwingsVenus®(晓鹜®)的赋能:把生成模型接进干湿闭环
生成模型再好,若没有可靠的湿实验与工程化验证,也只是「纸面候选」。MatwingsVenus®(晓鹜®)聚焦的,正是把前沿AI生成模型与真实实验能力连成闭环:
• [湿实验平台]:提供序列合成、蛋白表达、纯化与活性检测等环节的执行与优化,让ESM3生成的候选能尽快进入实测。
• [专家中心]:由分子与AI方向专家协助拆解提示、设计评测指标、解读实验数据,减少「不会用、不知道边界在哪」的试错。
• [干湿闭环平台]:把生成—合成—测试—学习的数据流统一管理,让每一轮实验都能回流到模型,形成持续改进的飞轮。
对团队而言,ESM3这类模型提供了一个强大的「创意引擎」,而MatwingsVenus®(晓鹜®)则负责把创意变成可验证、可复现、可放大的成果。两相结合,是「计算设计+实验验证」时代更务实的打开方式。
FAQ
1. ESM3是什么模型?它和AlphaFold有什么区别?
ESM3是首个能同时推理蛋白质序列、结构与功能的生物生成式模型。AlphaFold是「预测型」模型,主要回答「给定序列,预测结构」;ESM3是「生成型」模型,能从功能/结构/序列约束出发,生成自然界中不存在的新蛋白。
2. esmGFP是真的做出来了吗?还是只是模拟?
是真的合成并实测过。研究团队把ESM3生成的esmGFP在实验室中合成,并在大肠杆菌裂解液中实测到荧光。它与最接近的天然蛋白约58%同源,「约5亿年进化跨度」属于估算推演。
3. ESM3能直接用于药物研发或临床吗?
不能直接。ESM3生成的是候选序列/结构,仍需要折叠预测、湿实验验证、安全性评价等大量后续工作。它在分子发现、探针设计、酶工程等早期环节更具价值。
4. ESM3可以免费使用吗?
ESM3提供small/medium/large等不同尺寸,可通过EvolutionaryScale的API使用;小尺寸的ESM3-open以外放开源权重。具体访问方式与许可以官方为准。
5. ESM3生成的结果一定正确吗?
不一定。生成结果只是「候选」,需经可折叠性评估与湿实验验证。评测应区分「模型预测」与「实验实测」两类证据,不能混用。
6. ESM3和定向进化是什么关系?
二者互补。定向进化在真实生物体内逐步筛选;ESM3能一次性生成足够新颖、且满足多约束的候选,大幅扩宽「起点」,再用定向进化对候选做局部优化,形成「AI生成+实验筛选」的合力。
7. 普通科研团队该怎么用上这类模型?
可以先从「明确功能/结构约束」的提示开始,配合折叠预测与湿实验验证。若缺少实验或工程化能力,可通过成熟的干湿闭环服务(如MatwingsVenus®·湿实验平台)把生成结果快速落地为实测数据。
总结
ESM3把人工智能对蛋白质的理解,从「预测」带向了「生成」。它同时读取序列、结构和功能,让科学家能以「提示」的方式编程蛋白质,用一张全新的荧光蛋白esmGFP证明了「模拟5亿年进化」的潜力。但生成模型的价值,终究要靠湿实验来兑现。把ESM3这样的创意引擎,接入「生成—合成—测试—学习」的干湿闭环,才是把前沿模型变成可用成果的关键——而这,正是MatwingsVenus®(晓鹜®)与科研团队一起打磨的方向。
【一句话结论】ESM3把蛋白质工程从「预测」推进到「生成」:能同时读序列、结构、功能,用提示生成自然界不存在的新蛋白,但生成结果必须经湿实验验证,才能用于真实场景。
相关产品与服务
• 干湿闭环平台(Dry-Wet Closed-Loop Platform)