蛋白质Pfam家族分析如何准确读懂功能线索?
发布于 2026年10月14日
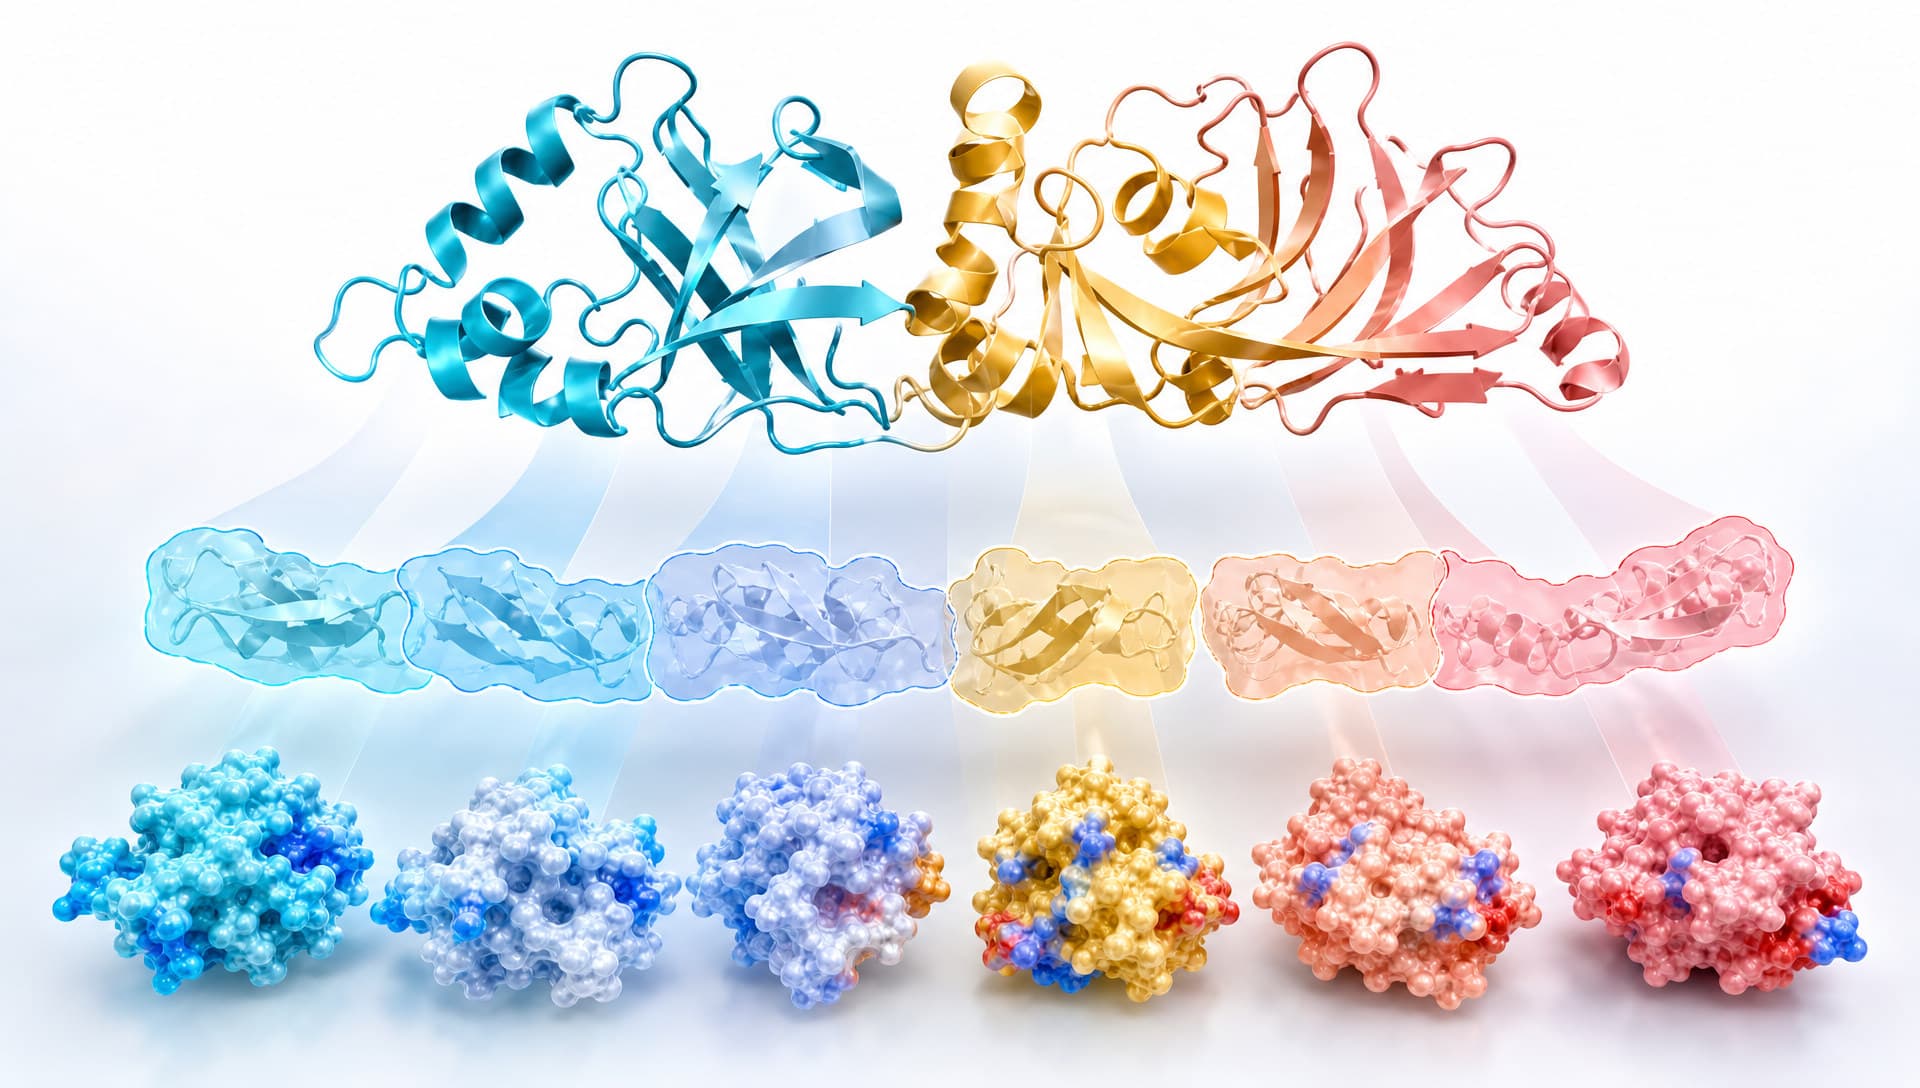
发光蛋白结构呈现家族域组成与潜在功能线索
分类: 计算生物学|蛋白质功能注释|生物信息学工作流
在宏基因组注释、酶资源筛选或蛋白质工程项目中,研究者经常遇到同一种困境:序列已经得到,但名称模糊、同源性不高,或者一个蛋白同时携带多个功能模块。此时,最危险的做法不是“没有答案”,而是把局部相似当作完整功能。蛋白质Pfam家族分析的价值,正在于先回答“哪些区域属于已知家族或结构域”,再逐层讨论这些区域能支持怎样的功能判断。
蛋白质Pfam家族分析先回答结构,再讨论功能
Pfam并不是简单的关键词目录。一个经典Pfam家族通常从具有代表性的种子序列比对出发,构建profile HMM,用保守位点、插入与缺失模式描述该家族的统计特征。待分析序列与模型匹配后,结果会给出家族编号、命中区间、得分、显著性及结构域排列等信息。与单条参考序列比对相比,这种模型能够汇总家族层面的保守规律,因此更适合发现具有一定序列分化的同源区域。
但“命中Pfam”不能直接等同于“功能已经证实”。家族或结构域注释首先说明序列的某一片段与模型相容;至于底物特异性、催化效率、细胞定位或生理角色,仍可能受到关键残基、结构环境、其他结构域和物种背景影响。专业的蛋白质Pfam家族分析应把命中视为可解释的起点,而不是结论终点。
当前Pfam内容已整合进InterPro生态,家族条目可以与其他成员数据库的注释、结构域分类和蛋白记录共同核对。对于研发团队而言,这意味着分析重点应从“查到一个PF编号”升级为“理解完整结构域架构,并确认不同证据是否指向一致的生物学解释”。
从输入质量到家族命中,流程决定结果上限
可靠流程始于输入核验。若输入是蛋白ID,应先确认物种、序列版本和长度;若只有裸序列,应检查非法字符、异常截短、起始与终止位置,以及低复杂度片段。来自基因预测的序列尤其需要留意错误外显子边界或提前终止,因为几十个残基的缺失就可能使结构域模型无法完整命中。
完成质量控制后,可用HMMER的hmmscan将蛋白序列扫描到Pfam profile数据库。结果解读不能只看最低E-value:家族特异的gathering threshold、域得分、命中覆盖度和边界完整性同样重要。高分且覆盖完整的命中通常更容易解释;接近阈值的短命中则需检查是否位于重复区、跨膜区或低复杂度区,并结合保守位点和相邻结构域复核。

蛋白序列经过概率模型扫描后形成清晰结构域
一体化分析工作流需要保留哪些核心能力
以MatwingsVenus®(晓鹜®)为例,一体化分析环境可以把ID解析、序列核验、InterPro/Pfam检索和结构化结果汇总放在同一任务中,减少手工复制带来的版本错配。
结构域架构比单个命中更接近真实生物学
许多蛋白并非由一个家族定义全部功能。信号肽、跨膜区、催化域、结合域和调控域可能按特定顺序组合,重复次数也可能改变相互作用方式。对这类蛋白,蛋白质Pfam家族分析应优先绘制从N端到C端的结构域架构,观察命中是否重叠、是否出现异常间隔,以及关键模块是否完整。
当两个模型覆盖同一区域时,不宜机械保留所有命中。应比较显著性、覆盖度、模型层级和InterPro整合关系,判断它们是同一超家族的不同描述,还是确实存在嵌套结构域。若某个预期结构域缺失,也要先排除序列不完整与边界偏移,再讨论家族分化或功能丢失。
批量项目还需要比较样本间的架构一致性。相同家族核心域配合不同辅助域,可能提示底物范围、定位方式或调控机制发生变化;但这类推断仍属于待验证假设。将命中结果按“数据库注释”“计算推断”“未知”分层呈现,可以避免把预测包装成实验事实,也能帮助团队优先选择最值得验证的候选。
蛋白质Pfam家族分析如何转化为可执行决策
高质量输出不应止于表格。面向单个蛋白,可进一步检查家族条目中的保守基序、活性相关残基和已知结构,并把结构域边界映射到实验构建设计。面向候选酶筛选,可按核心催化域完整性、辅助域组合和关键位点保守程度分层,而不是仅凭E-value排序。面向蛋白质工程,则应先把保守功能区域标记为谨慎改造区,再结合结构预测或实验数据选择可探索位点。

序列数据逐步转化为结构域架构与分层证据
这也是蛋白质Pfam家族分析与更广泛工作流衔接的关键:家族注释用于提出可检验假设,同源检索用于扩展候选,结构预测用于检查空间合理性,功能位点分析用于缩小实验范围,最终由生化或细胞实验确认。集成式平台若能统一管理输入、数据库记录、预测任务和导出结果,就能让每一步保留清晰上下文,并支持团队复现同一条分析链。
需要警惕三类常见误判。第一,只要有显著命中就套用完整蛋白名称,忽略该命中可能仅覆盖一个通用结合域;第二,把E-value差异直接解释为功能强弱,而它主要反映匹配显著性;第三,在序列不完整时将结构域缺失解释为生物学差异。解决这些问题的共同方法,是同时查看边界、覆盖度、结构域组合和证据等级,并为关键结论保留验证出口。
可解释结果来自阈值、边界与证据的共同约束
一个可交付的分析结果至少应包含输入序列版本、Pfam家族编号与名称、命中起止位置、域得分与显著性、采用的阈值、结构域架构图、冲突命中处理方式,以及后续验证建议。批量任务还应记录数据库版本和运行参数,便于未来数据库更新后重跑与比较。
蛋白质Pfam家族分析真正提升的,不只是注释速度,而是从序列到研发决策的可解释性。它让团队知道哪些判断来自权威数据库,哪些属于模型推断,哪些仍然未知。对于新蛋白、低同源候选和复杂多域蛋白,这种边界清晰、可追溯且能连接后续验证的工作方式,往往比一个看似确定的自动注释更有价值。