天然产物合成酶挖掘:如何从基因组中系统搜索「药物工厂」?
发布于 2026年10月22日
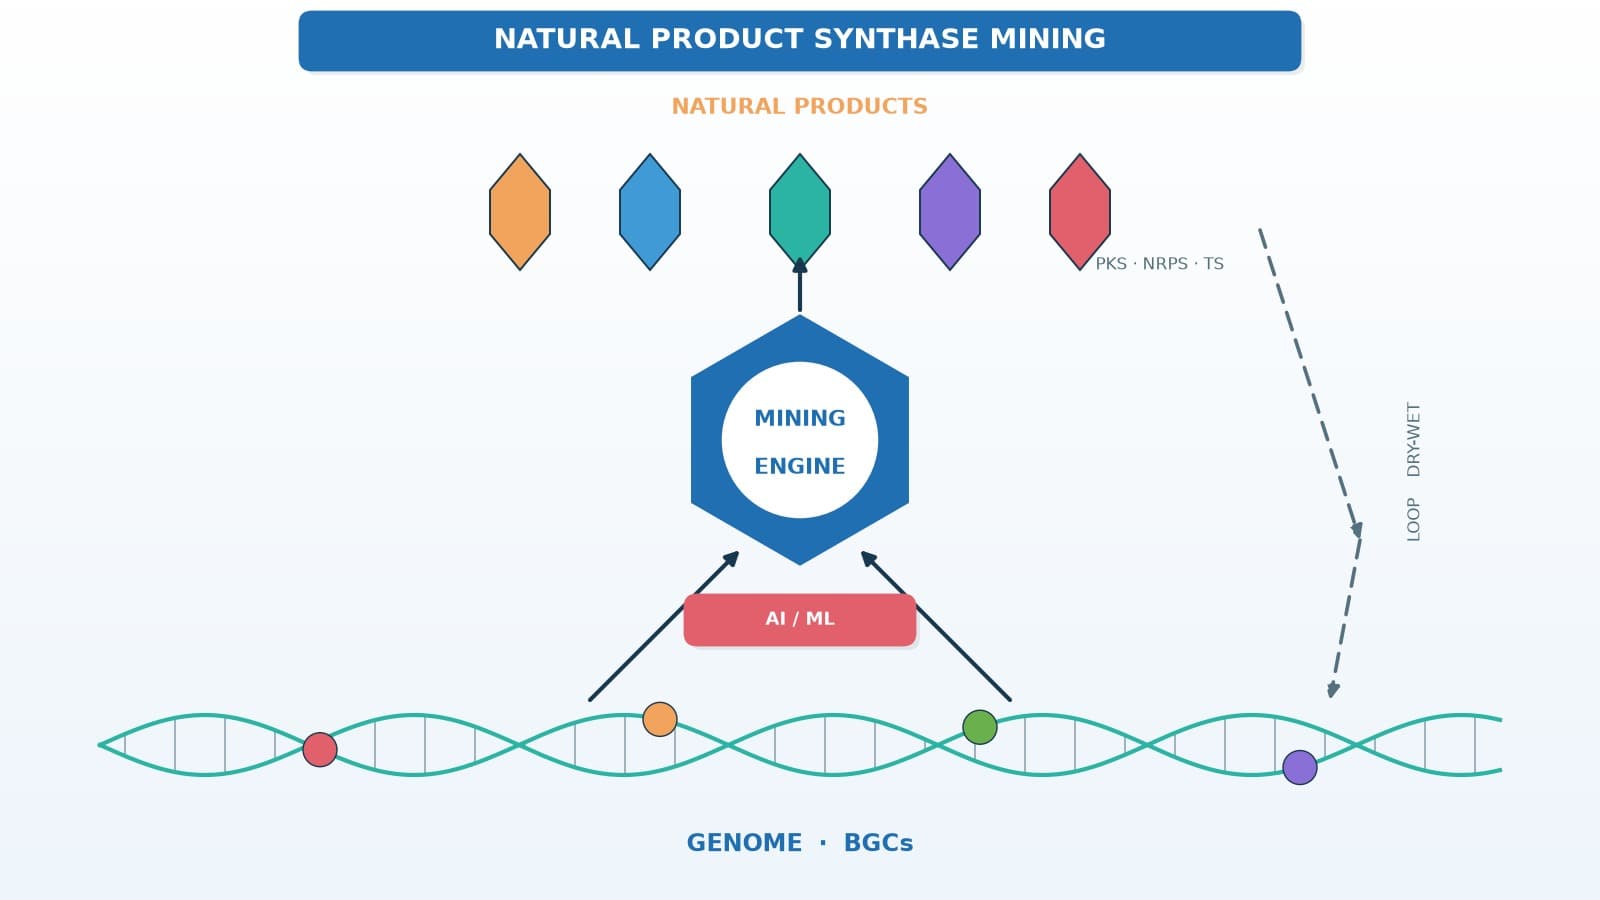
图1|天然产物合成酶挖掘概念全景(AI/ML 干湿闭环)
引言
地球上数以百万计的微生物、真菌与植物,各自运行着独特的「分子制造流水线」。流水线的核心,是一类被统称为天然产物合成酶的生物大分子:它们把简单的代谢前体——如乙酰辅酶A、氨基酸、异戊二烯单元——拼接成结构复杂、活性多样的分子。从青霉素、红霉素到紫杉醇、他克莫司,许多临床一线药物的源头都来自这类酶。然而,绝大多数生物合成基因簇(BGC)在实验室条件下并不表达,处于「沉默」状态。天然产物合成酶挖掘,正是借助基因组测序、生物信息学与人工智能,把这些沉睡在基因组中的合成能力系统性地定位、鉴定并「唤醒」。
为什么天然产物合成酶值得挖掘?
天然产物合成酶挖掘之所以值得投入,是因为天然产物仍是新药发现的重要来源——有分析显示天然产物及其衍生物占美国 FDA 批准新分子实体(NMEs)的三分之一以上,且在抗菌与抗肿瘤领域比例更高。
· 历史回报:天然产物平台是新药的重要基石,多个治疗领域的"重磅"药物都由此而来;天然产物及其衍生物占 FDA 新分子实体的三分之一以上这一比例,在抗菌、抗肿瘤领域更为突出。
· 「冰山」效应:在已测序的微生物基因组中,被注释为次级代谢的BGC 数量远超已被表征的已知产物,绝大多数合成酶与基因簇仍未被开发。【待核实:世界范围已知与未知 BGC 的具体数量比例】
· 结构新颖:传统培养与分离只能发现「已被表达」的分子;基因挖掘能触碰沉默基因簇,带来骨架新颖、机制独特的候选分子。
· 产业价值:合成酶既是天然产物的「催化中心」,也是「设计模板」;挖掘到新酶等于拿到新分子的钥匙,可服务药物、农化、食品与生物制造。
· 现实约束:并非所有BGC 都能在天然宿主中高效表达;沉默基因簇常需调控元件激活、异源表达与酶工程改造才能产出目标分子。
换个角度看,基因组挖掘本质是在「重新审视」已有的测序数据:许多菌株早已被测序,其中的天然产物合成能力却未得到系统解读。借助AI 辅助的自动化挖掘,团队可在不依赖大规模培养的前提下,先锁定「最可能带来新分子」的基因簇,再集中资源做验证。这正是合成酶挖掘有别于传统随机筛选的效率所在。
天然产物合成酶如何工作?
天然产物合成酶大多采用模块化流水线策略:聚酮合酶(PKS)与非核糖体肽合成酶(NRPS)以多个功能模块依次装配并延伸分子链,萜类合成酶则负责把异戊二烯前体环化成骨架。
· PKS(聚酮合酶):I 型 PKS 呈模块化,典型模块含酮基合成酶(KS,催化碳-碳键)、酰基转移酶(AT,选择延伸单元)与酰基载体蛋白(ACP,携带生长链);末端硫酯酶(TE)负责释放产物。II 型与 III 型 PKS 则以迭代/单酶方式逐轮缩合聚酮链。
· NRPS(非核糖体肽合成酶):模块含缩合(C,形成肽键)、腺苷酰化(A,识别并活化氨基酸)与硫酯化(T,携带中间体)结构域,常伴随差向异构、甲基化等后加工,拼成非核糖体肽。
· 萜类合成酶:以异戊烯基二磷酸(IPP/DMAPP)为起点,依次使用 GPP(单萜)、FPP(倍半萜)、GGPP(二萜)等前体,在活性口袋中经碳正离子级联环化,生成成千上万种萜类骨架。
· 杂交与后加工:PKS–NRPS 杂交酶可同时延伸碳链与肽链;骨架还需甲基转移酶、糖基转移酶、氧化酶等「后加工」酶修饰,最终形成多样结构。
· 结构域即身份标签:这些保守结构域正是挖掘时的识别特征——仅凭序列特征即可判断一个基因簇是否编码 PKS/NRPS。
值得注意的是,模块化合成酶大多遵循「共线性」规律——结构域或模块在基因中的排列顺序,往往与产物组装步骤一一对应。这一规律让研究者仅凭基因序列就能预测产物的组装顺序与大致骨架,是挖掘与工程的重要基础。同时,不同模块的底物特异性(如 AT 对延伸单元、A 结构域对氨基酸的选择)也决定了产物多样性的边界。

图2|天然产物合成酶的模块化装配与萜类环化机制
如何评估与选型候选合成酶?
挖掘得到的候选合成酶并非都值得进一步投入,评估与选型应同时看序列/结构特征、预测产物新颖性、可控表达可行性以及最终应用价值。
· 新颖性:与已知酶、已知产物比对,优先选择与已知分子差异大的基因簇。
· 完整性:起始、延伸与释放(如硫酯酶TE)模块是否齐全,直接决定能否产出完整分子。
· 预测产物:依据结构域排列顺序与底物特异性预测产物骨架,判断其成药相关潜力空间。
· 可表达性:密码子偏好、GC 含量、可溶性折叠倾向与异源宿主适配度,决定能否从「序列」走向「产物」。
· 可改造性:结构域边界清晰、存在已有模板,关系到后续定向进化与改造空间。
· 多组学辅助:结合转录组与代谢组(分子网络)优先锁定「活跃表达」的基因簇,提高命中率。
· 风险标识:对潜在毒性、低溶解度或难纯化等风险提前标记,并区分【实测】与【预测】。
实践中常把上述维度量化为可比较的评分,并为每个维度标注证据级别:来自实验的是【实测】,来自比对或模型的则是【预测】,缺乏证据时明确标注【未知】。这样既能加速决策,也不会把推断误当成事实。
基因组挖掘的标准工作流程
成熟的基因组挖掘通常遵循「样本→ 测序 → 基因簇预测 → 同源/结构比对 → 候选排序与验证 → 放大生产」的闭环,其中 AI 模型负责预测与排序,湿实验负责最终确认。
1. 样本与测序:对微生物/真菌/植物样本进行全基因组或宏基因组测序;长读长测序更利于组装完整的 BGC 与重复区域。
2. 基因簇预测:用antiSMASH 等工具按核心酶类型标注 BGC,并结合 MIBiG 等数据库比对已知簇。
3. 同源挖掘:对未知序列做BLAST 同源比对发现近缘催化,或用结构比对(如 Foldseek 式)发现远程同源与新骨架。
4. 候选排序:综合新颖性、完整性、可表达性、产物预测等多指标打分,并用多组学证据加权。
5. 验证与放大:异源表达(如放线菌、酵母宿主)、活性与结构鉴定(LC–MS/MS、NMR),再到发酵放大与纯化。
6. AI 闭环:每次湿实验数据回流模型,形成主动学习,逐步提升下一轮挖掘的预测准确率。
整个流程的关键在于「干湿结合」:干实验帮助收敛候选,湿实验提供真实反馈;缺少任何一环,都容易出现「预测准、落地难」或「大海捞针、成本高」的局面。

图3|天然产物合成酶挖掘标准流程:基因组到产物
MatwingsVenus®(晓鹜®)如何参与?
MatwingsVenus®(晓鹜®)把「AI 驱动的序列/结构挖掘」与「湿实验验证改造成果」串成闭环,帮助团队更快地从基因组走向可生产的新型天然产物。
· 干实验挖掘:基于序列同源(BLAST)与结构挖掘(VenusMine)对候选合成酶做功能注释、结构域与性质筛选,快速缩小目标范围。
· 结构预测与设计:借助蛋白结构预测与AI 设计工具,评估候选酶的可折叠性、活性口袋与可改造位点,为后续定向进化提供方向。
· 湿实验闭环:通过异源表达、纯化、活性与稳定性表征验证候选,并将结果回填模型,形成「干→ 湿 → 干」闭环节奏,让每一轮挖掘都更准。
· 一体化服务:从候选筛选、结构解析到表达验证与放大,可按需组合,交付可验证、可生产的酶与分子资源。
相关产品/服务(深链)
· 湿实验服务(表达、纯化、表征):湿实验平台
· 专家与定制服务:专家中心
· AI 干湿闭环平台:干湿闭环平台
FAQ
天然产物合成酶挖掘和传统分离天然产物有什么区别?
传统分离依赖微生物「已经表达」的分子,而挖掘可从基因层面发现处于沉默状态的合成酶与基因簇,触及更多未知结构。
PKS 和 NRPS 有什么区别?
PKS(聚酮合酶)拼接酰基/丙二酰单元,NRPS(非核糖体肽合成酶)拼接氨基酸单元,二者均由多个模块化结构域流水线式装配。
是不是只要有生物合成基因簇就一定能产出目标分子?
不一定。完整性与有效表达是必要条件:基因簇需具备完整装配与释放模块,且能在宿主中有效表达,必要时需异源表达或激活。
基因组挖掘需要哪些数据与工具?
通常需要基因组/宏基因组测序数据、BGC 预测工具(如 antiSMASH)、序列与结构同源比对,以及候选打分与验证流程。
如何判断挖掘到的合成酶是否有价值?
看新颖性、基因簇完整性、可表达性、可改造性与应用价值,并区分【实测】与【预测】结果。
AI 在天然产物合成酶挖掘中有什么用?
AI 用于基因簇/酶功能预测、候选排序、结构预测与主动学习优化,把「大量候选」快速收敛为「少数值得验证」的目标。
MatwingsVenus 能提供哪类支持?
可提供干实验挖掘/注释/结构预测、湿实验表达纯化表征,以及干湿闭环平台的一体化服务(具体范围以官方为准)。
总结
天然产物合成酶挖掘把「藏在基因组里的合成能力」系统性地转化为可验证、可生产的分子与酶资源。从测序、基因簇预测、同源与结构挖掘,到候选验证与放大,每个环节都需要AI 与湿实验的紧密配合。若您在候选合成酶挖掘、异源表达或放大生产中遇到瓶颈,欢迎获取选型建议或提交样品:电话13061973951,邮箱 info@matwings.com。
探索MatwingsVenus®(晓鹜®):了解更多AI 蛋白与酶工程能力,欢迎浏览平台产品与服务。更多技术文章与案例,请关注官网新闻中心。