新型酶发现方法:序列、结构与AI高效挖掘
发布于 2026年10月22日
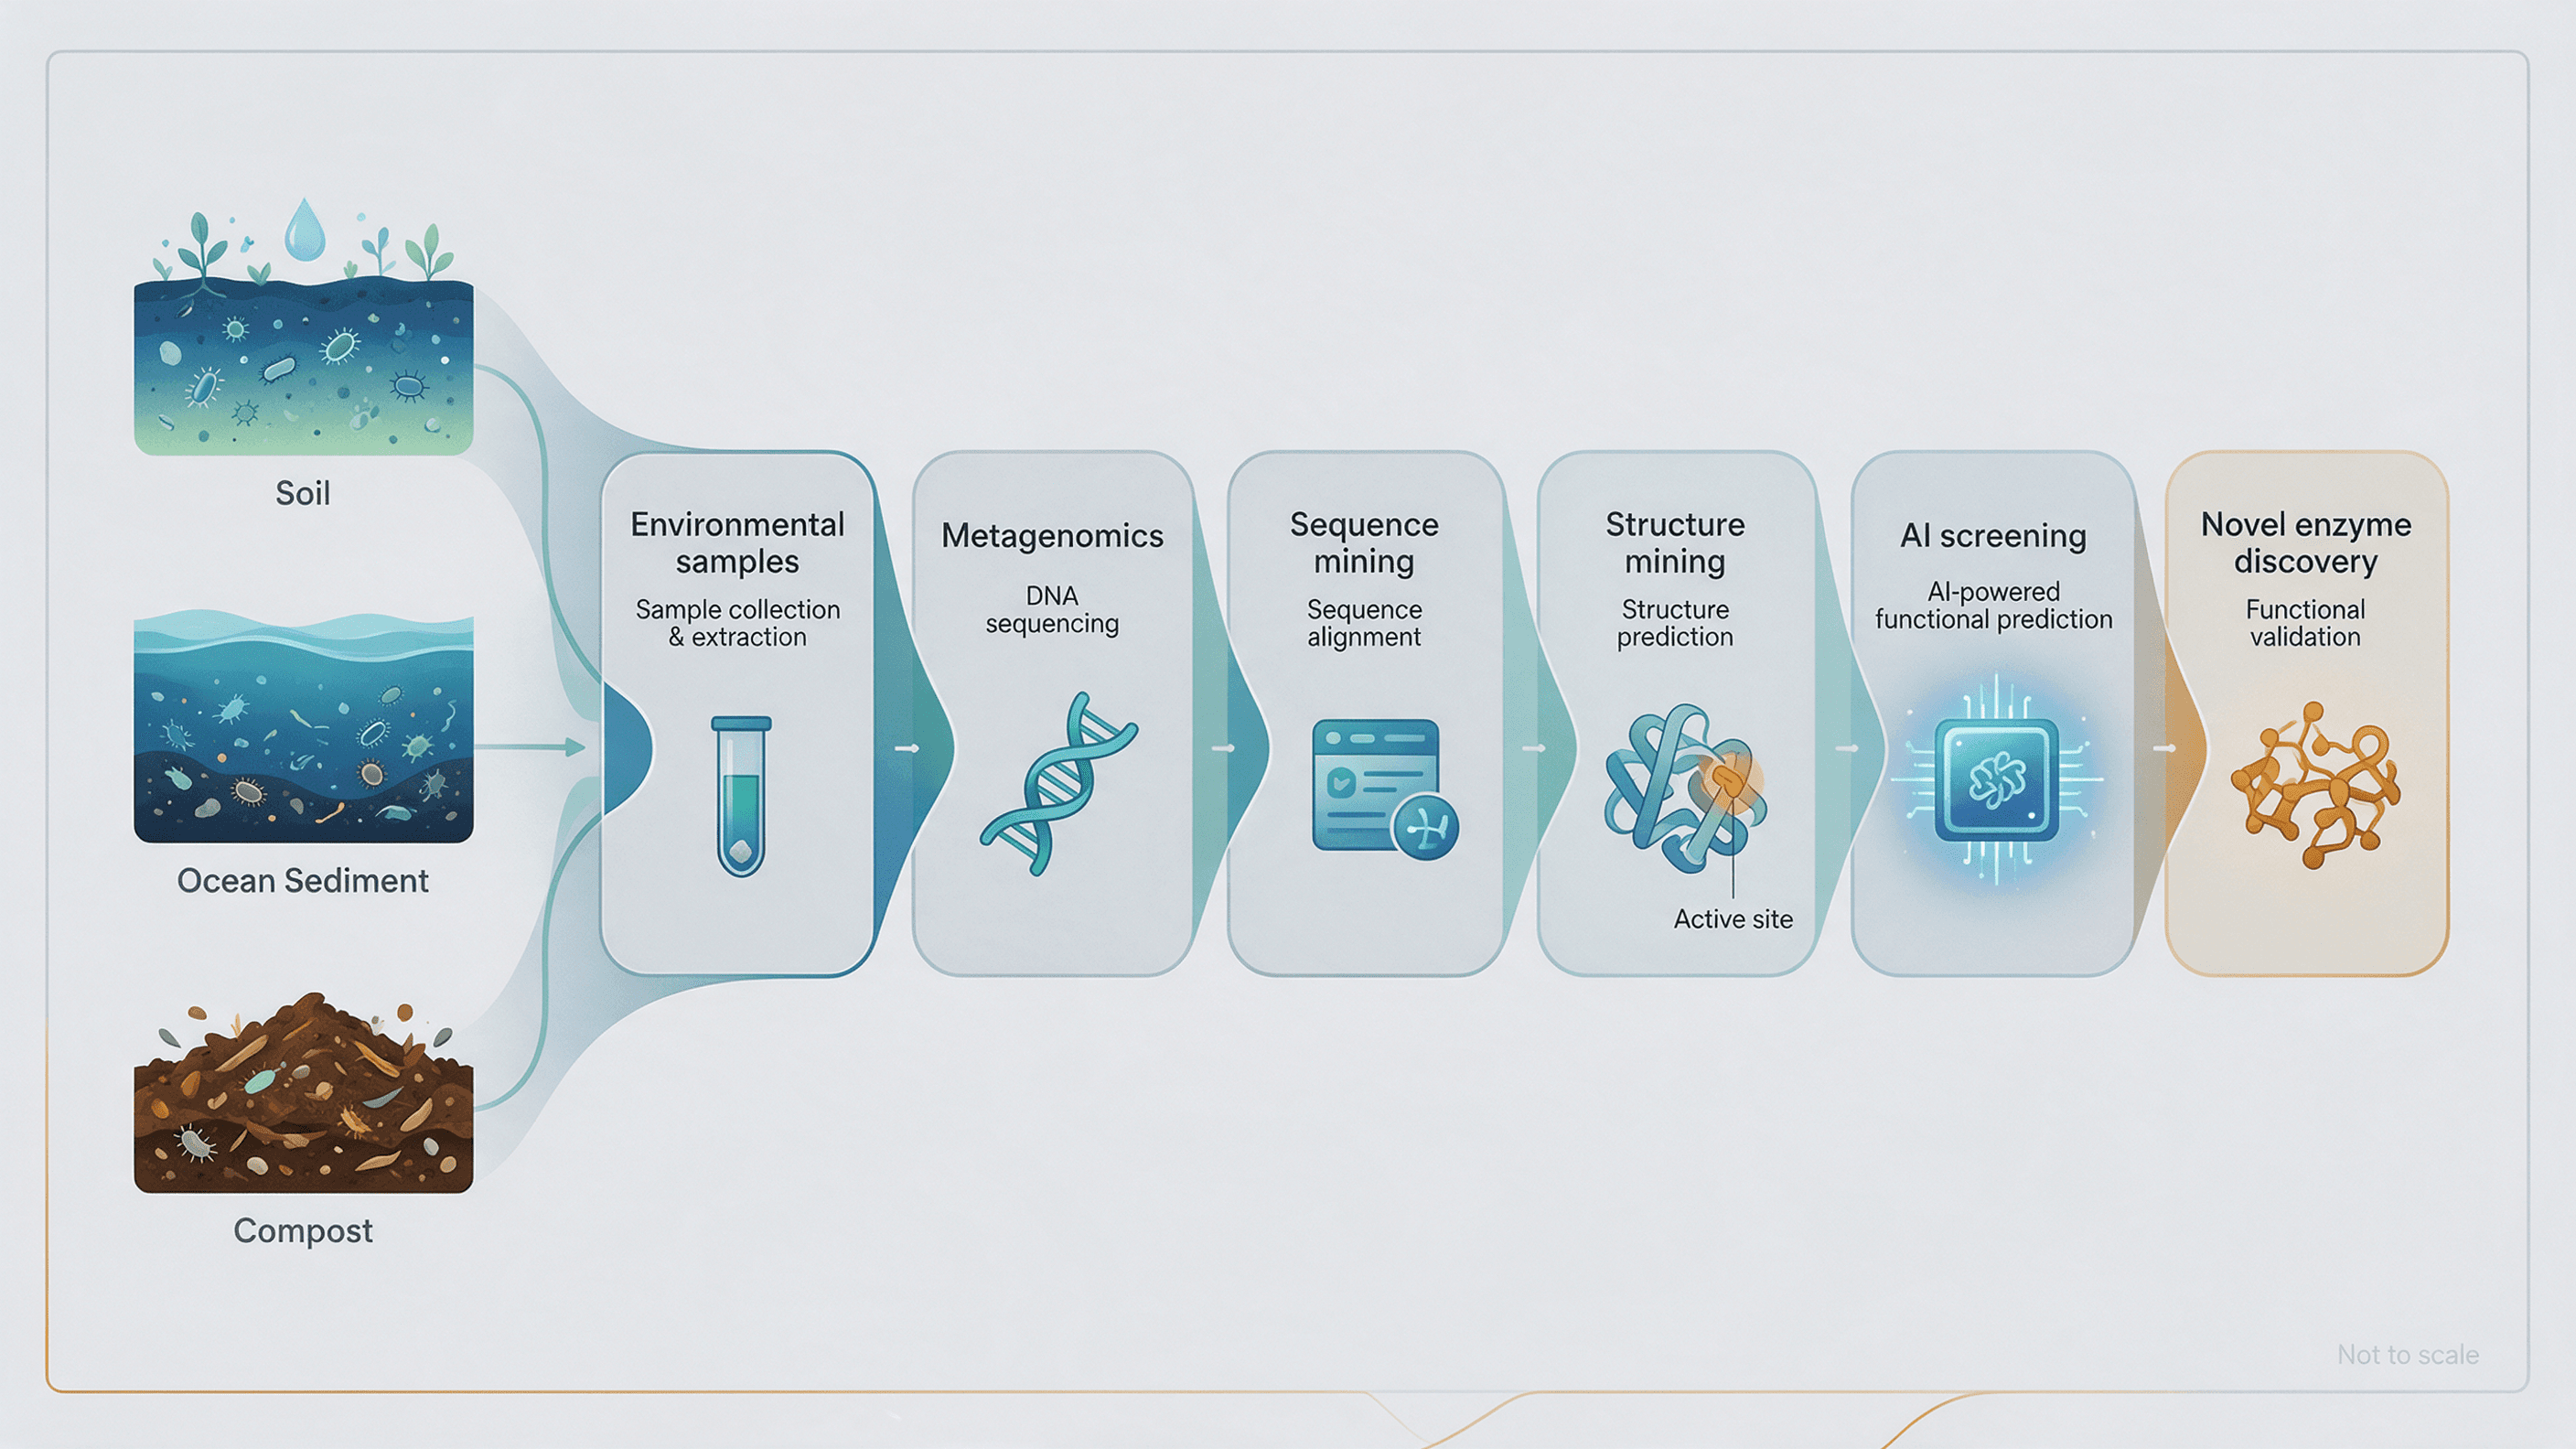
酶是生物催化的核心工具。工业界需要的酶,往往要在活性、热稳定性、底物范围与反应条件上“刚刚好”;而自然界中能被直接培养并使用的天然酶只是冰山一角。于是,“发现新型酶”成为酶工程与合成生物学持续追求的目标。过去,人们靠“培养微生物+功能筛选”来碰运气;如今,宏基因组学、序列与结构挖掘、以及AI驱动的功能预测,正在把“发现”变成一项可预测、可规模化的工程。本文带你系统看清新型酶发现的方法脉络,以及它如何一步步走向工业应用。
背景/机制 —— 为什么要系统地“发现”新酶,而不是只靠已知酶库?
人类能培养的微生物只占环境微生物的极小比例,大量酶的“藏身之处”根本无法通过传统平板培养触及。与此同时,工业反应常常要求酶具备特定热稳定性、溶剂耐受性或底物专一性,这些属性很难靠“改一改已知酶”就完美获得。因此,研究者把目光投向宏基因组——直接从环境样本提取DNA,跳过培养环节。再叠加公共数据库与预测模型,酶的“发现空间”从实验室培养皿扩展到了几乎整个生命数据空间。这样做的直接收益是:候选数量大幅上升,进而提高找到“刚好可用”的酶的数学期望。【实测/预测:以上方法学为公开共识,具体命中率与成本随项目而异。】
原理/结构 —— 新型酶发现的三大技术路径:序列挖掘、结构挖掘与 AI 功能预测

序列、结构与AI三条发现路径
(1)序列挖掘(Sequence mining):按“长得像”去找。 以已知酶的氨基酸序列为起点,用同源搜索(BLAST)、隐马尔可夫模型(如Pfam)与序列相似性网络,在数据库里寻找具有保守活性位点模体的新序列。它速度快、成本低,是首选的“广撒网”手段;缺点是容易被序列相似度“框住”,难以发现序列差异大但功能相近的远缘酶。
(2)结构挖掘(Structure mining):按“折叠得像”去找。 借助蛋白结构预测与结构比对(例如Foldseek式的结构对齐),绕开序列相似度的限制,去找“序列不同、但折叠与结合口袋相似”的候选。它强调催化口袋与结合口袋(binding pocket)的空间一致性,往往能捕捉到序列挖掘漏掉的远缘同源酶。
(3)AI功能预测(AI-assisted discovery):按“语义/能量”去找。 蛋白语言模型、功能注释模型与主动学习(active learning)被用于给大量候选打“功能分”,并通过适应度景观(fitness landscape)估计活性走势。需要区分的是:AI既可用于“发现”(从已有数据中挑出被低估的酶),也可用于“设计”(生成全新骨架);本文主线是前者。三条路径互补,实际项目中通常组合使用,把候选池收敛到可实验验证的规模。
测定或选型—— 如何验证候选新酶的活性与稳定性,并筛出真正可用的目标?
计算给出的是“可能有用”,湿实验才是“真的有用”。候选酶通常先被克隆到表达宿主(大肠杆菌、酵母/真菌、毕赤酵母等)进行异源表达,考察可溶性表达水平;随后做底物谱测定,确认它对目标底物的活性(kcat/KM);再评估热稳定性(如T50、半衰期)与溶剂/酸碱耐受性。真正落地的选择,往往要在“高活性但难表达”“稳定但活性低”之间做工程化取舍。此阶段应明确区分【实测】数据(来自本项目的测定值)与【预测】数据(来自模型的估计值)。【未知:特定酶的最优表达宿主与测定体系,需按项目实测确定。】
条件/工艺 —— 从候选酶到工艺放大:表达、纯化与反应条件如何被确定?

端到端酶发现工艺闭环
拿到一个可表达的候选后,工程化工作围绕“把活性放大成产能”展开。表达端要确定宿主、诱导温度与诱导剂浓度(如IPTG)、发酵时间;纯化端要根据标签与电荷特性选择亲和层析或离子交换;反应端则要系统优化pH、温度、缓冲液与底物浓度,并考虑辅因子依赖(是否需NAD(P)H等)与产物抑制。放大时还要核算酶/底物比与单位成本。这些条件通常相互耦合,往往需要一轮轮实验回归;把每次湿实验的结果“回灌”给计算模型,正是“干湿闭环”的价值所在。
MatwingsVenus®(晓鹜®)如何参与 —— 干湿闭环加速新型酶发现
发现方法要真正产生价值,关键在于“算”与“做”能否闭环。MatwingsVenus®(晓鹜®)的干湿闭环平台把计算侧(结构挖掘、功能预测、候选排序)与湿实验侧(表达、活性测定、稳定性评估)连成一条可迭代的数据通路:每次实验的实测值回灌模型,主动学习据此调整下一轮候选——这正是把“新型酶发现方法”变成可靠生产力的方式之一。各产品线的具体能力与交付范围,请以官网最新资料为准。
FAQ —— 新型酶发现方法常见问题
Q1:新型酶发现方法与传统的“培养 + 筛选”有什么不同?
传统方法必须先培养微生物才能筛选,往往只覆盖可培养物种;新型酶发现方法通过宏基因组与计算挖掘绕过培养限制,把搜索范围扩展到几乎全部环境基因组与数据空间。
Q2:宏基因组学在新型酶发现中起什么作用?
宏基因组学直接提取环境样本中的总DNA,跳过微生物培养环节,从而让研究者接触到大量“不可培养”微生物所携带的酶基因,极大拓宽了新型酶发现的候选来源。
Q3:序列挖掘和结构挖掘有什么区别?哪个更好?
序列挖掘按“氨基酸相似”找酶、速度快成本低;结构挖掘按“折叠与结合口袋相似”找酶、能发现远缘同源物,但成本更高;两者互补,没有绝对优劣,通常按项目特性组合使用。
Q4:AI 能直接“发明”全新的酶吗?
AI既能用于“发现”(从已有数据中挑出被低估的酶),也能用于“设计”(生成全新骨架),两者目标不同;本文讨论的新型酶发现方法以“发现”为主线,设计类成果需单独评估。
Q5:发现一个候选酶后,多久能到工业应用?
从候选到工业应用通常需经过表达、活性验证、稳定性评估与工艺放大等多轮迭代,周期可从数周到数月不等,具体取决于酶复杂度、底物体系与放大难度。
Q6:如何判断一个新酶是否真的“新”?
判断“是否新”首先要与公开序列/结构数据库做比对,确认其序列相似度低、且不属于已知功能家族;其次要用实验确认其活性谱与已知酶区分开,具体判定阈值需结合数据库版本与家族定义。
Q7:新型酶发现的成本与成功率如何?
成本与成功率高度依赖方法组合与目标酶家族;计算挖掘可显著压低“广筛”成本,但真正命中仍需湿实验验证,成功率宜按项目分别评估。
总结
新型酶发现已从依赖可培养微生物的“机会性筛选”,演变为把宏基因组、序列/结构挖掘与AI功能预测串成系统化闭环的工程方法;其价值在于更快、更广、更可控地供给适用工业的催化剂。把“发现”做成闭环,正是把酶工程从“运气”变成“工程”的关键。无论是初次接触酶发现,还是想为产线寻找更合适的催化剂,理解这些方法与验证路径,都是迈出第一步前最重要的一步。