酶挖掘保守位点分析:为什么它是找到酶催化机器的入口?
发布于 2026年10月22日
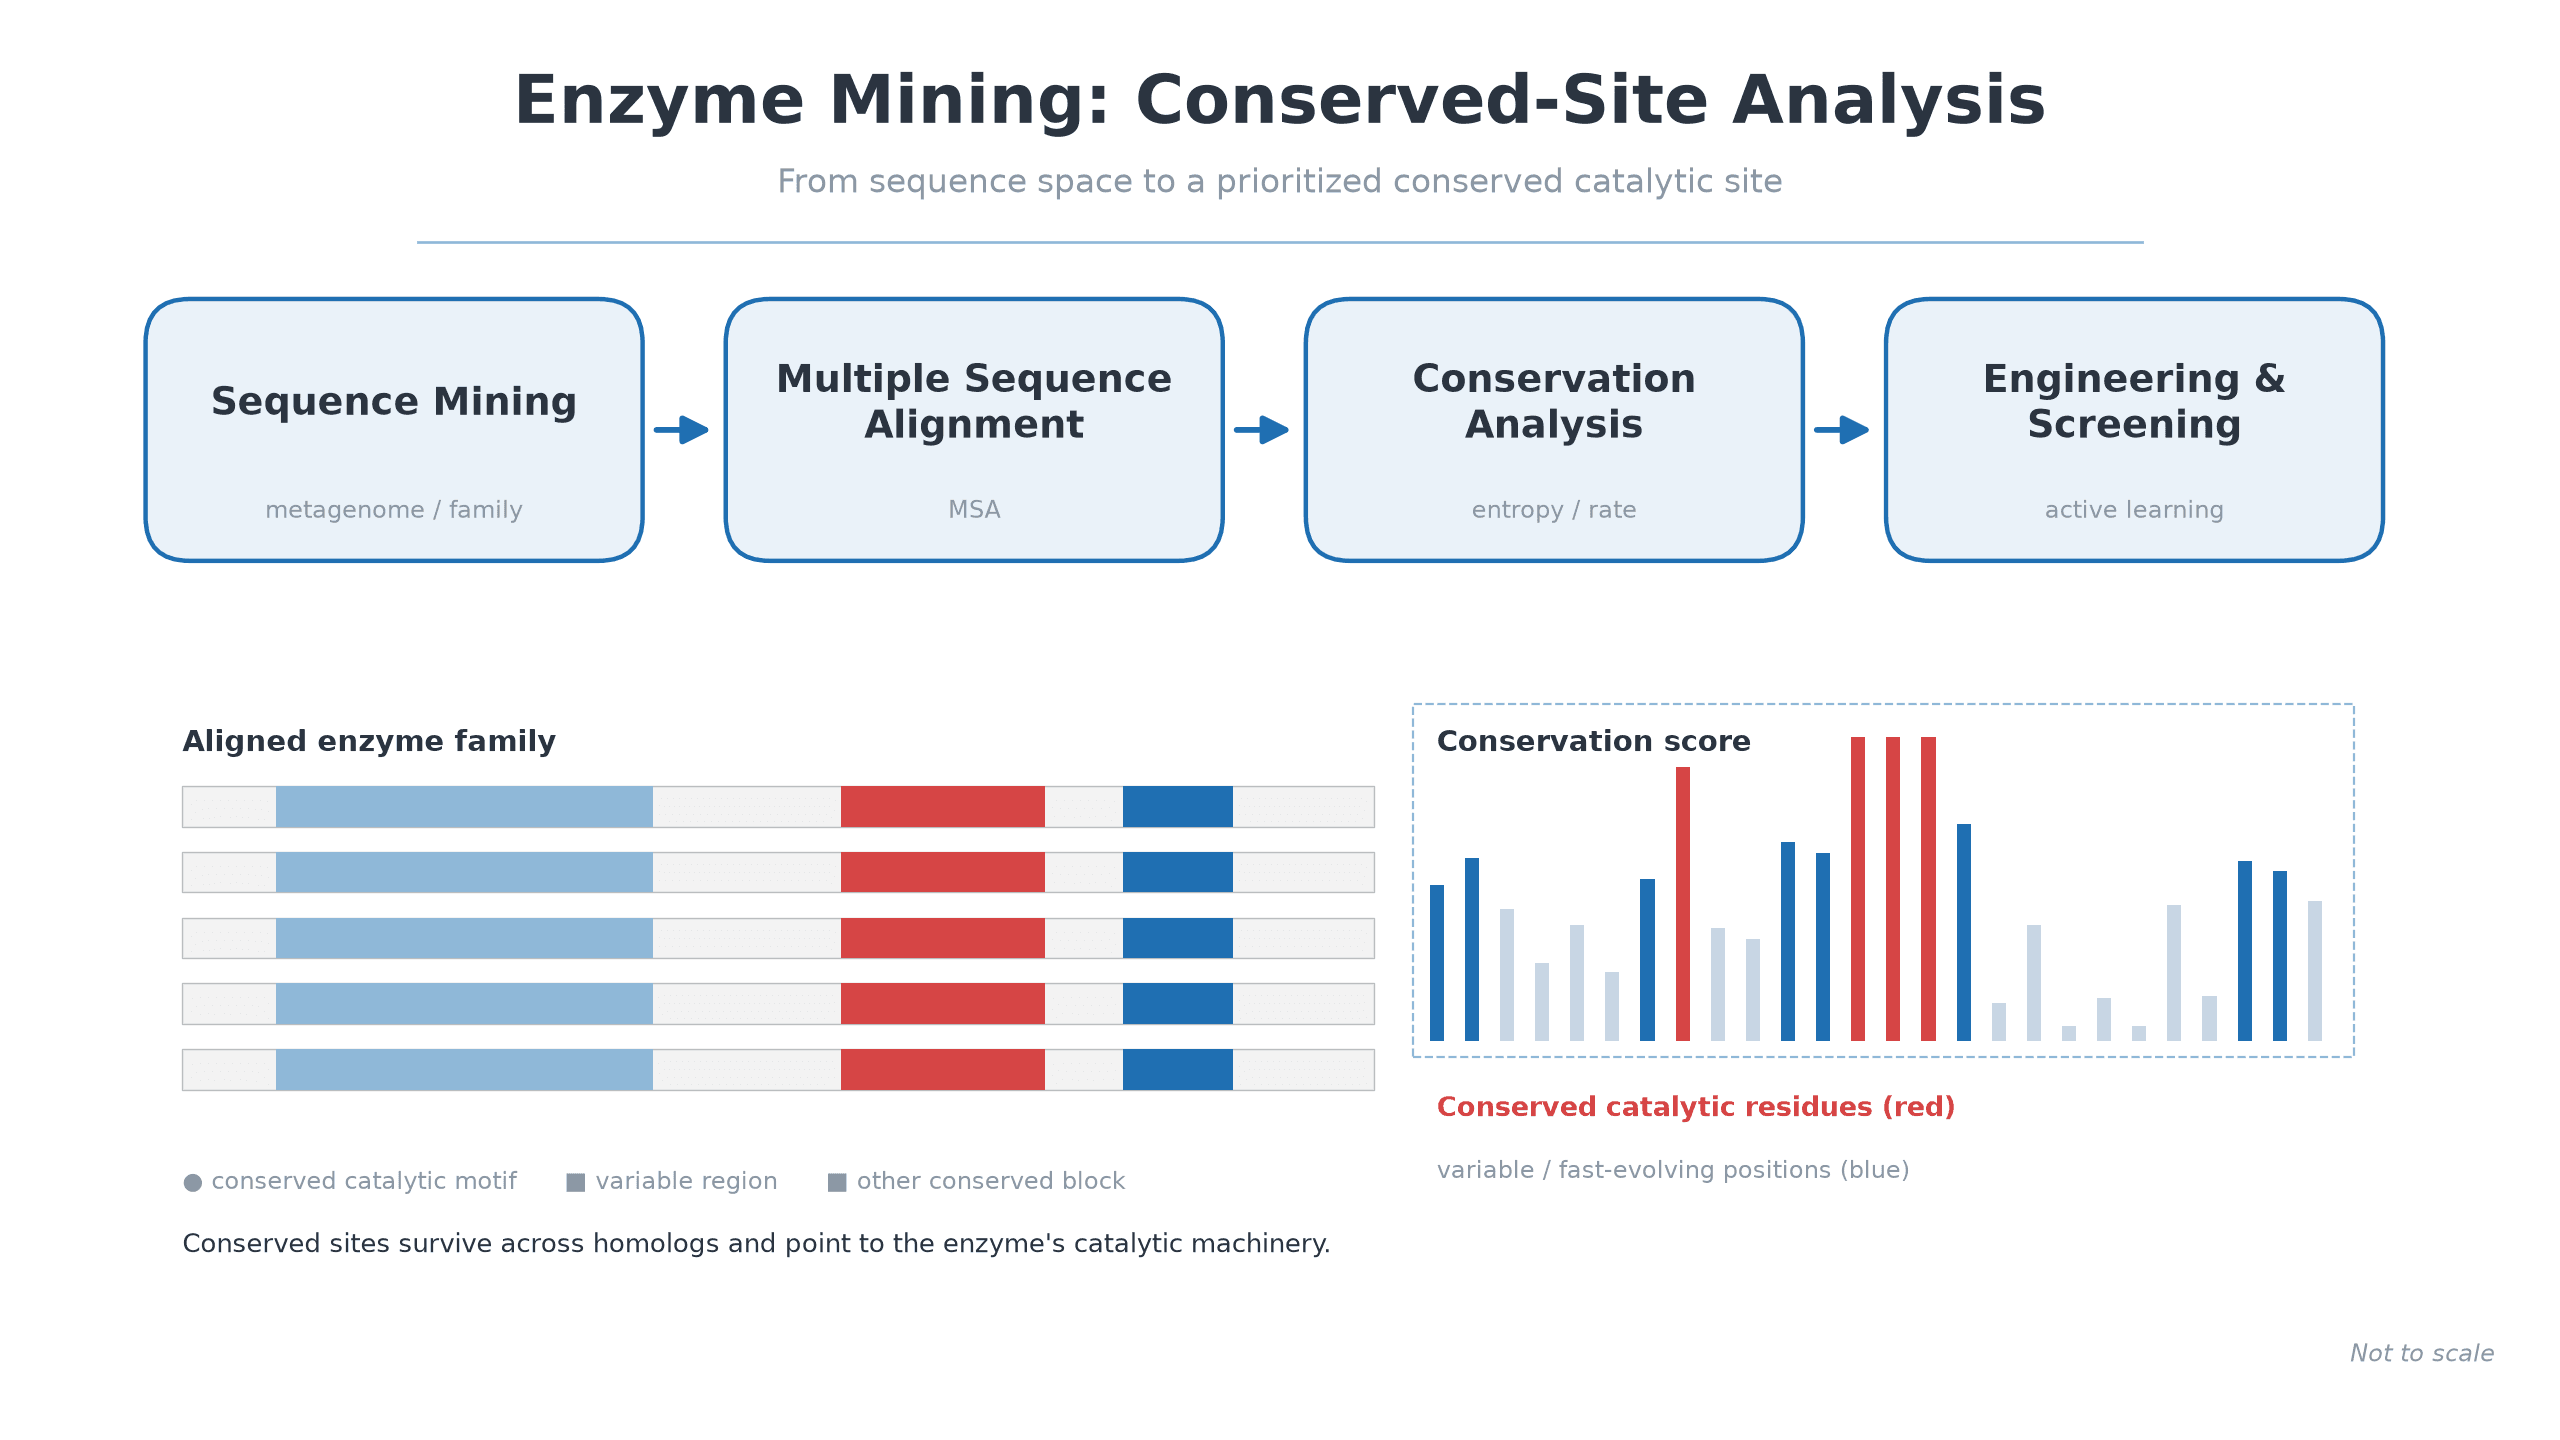
从序列空间到保守催化位点的酶挖掘全景
自然界里存在大量功能尚未被注释的酶序列,真正可用的酶往往藏在宏基因组与基因组数据库的噪声中。保守位点分析把“挖掘”变成一次有方向的选择:它通过比对一个酶家族的多个同源序列,识别那些在进化中几乎不变的位置,从而把注意力从大量可变残基,聚焦到决定催化活性与底物识别的关键残基上。本文用可复现的流程,讲清“保守”为什么能指向酶的催化机器,以及在工程化中如何利用它。
背景/机制:酶挖掘为什么离不开保守位点分析
酶挖掘的目标,是从海量同源序列里筛出真正可用的酶;而保守位点分析通过多序列比对识别在进化中保留下来的位置,把注意力从噪声序列聚焦到决定催化活性的关键残基上。
一个酶家族内部,承担催化与底物识别的残基往往高度保守——因为改变它们通常会牺牲功能;相反,表面与远离活性位点的位置更容忍突变。于是“保守”成了一个天然的过滤器。对一段新挖掘、功能未知的序列做保守位点分析,可以回答三件事:它是否具备完整的催化机器、催化残基与结合位点大致在哪里、以及哪些位置是工程化时“不该乱动”的功能核心。
需要提醒的是,“保守”并不等于“催化”:有的保守残基负责结构折叠、二硫键或疏水核心,有的负责底物识别或辅因子结合;只有把进化保守、结构定位与功能注释放在一起,才能做出可靠的判断。
原理/结构:保守位点如何定位酶的功能核心
保守位点之所以重要,是因为进化压力会保留那些对折叠、底物结合与催化不可或缺的残基,从而在结构上形成清晰的活性中心;例如木瓜蛋白酶(papain)的催化三联体Cys25–His159–Asn175,就是一个教科书式的例子。

木瓜蛋白酶催化三联体Cys25–His159–Asn175(真实结构)
以木瓜蛋白酶为例(结构来自RCSB PDB 1CVZ,真实实验结构,非按比例问题不适用):Cys25作为亲核体发起进攻,His159作为广义碱协助质子转移,Asn175稳定His159的取向;这三个残基在众多同源半胱氨酸蛋白酶中高度保留,构成严谨的催化电荷网络。【已知结构;残基编号与真实PDB一致】
这也解释了保守位点分析的判断逻辑:同一家族里反复出现、且位于活性口袋内的残基,通常就是功能核心;而只在某些物种出现、或位于表面的残基,多数是适应性的可变位点。把高保守残基映射到已知或预测结构,能进一步区分催化位点、底物结合口袋与结构骨架。
测定或选型:保守位点分析的常用方法与指标
衡量保守性的常用指标包括序列同一性、Shannon熵、相对熵与进化速率等,配合多序列比对(MSA)与结构映射,才能把“保守”落到可解释的化学功能上。
具体做法通常是:先用MUSCLE、MAFFT或Clustal Omega对同类序列做多序列比对;再用Shannon熵(熵越低越保守)、相对熵或ConSurf/rate4site的进化速率对每个位点打分;最后把高分位点投影到结构上,看它们是否落在活性位点或结合口袋。【温馨提示:不同算法与参数给出的口径不同,建议交叉验证,并说明阈值与数据来源】
选择方法时,要权衡序列多样性、比对质量与是否具备结构。若一个家族的同源序列过少,保守性打分噪声会很大;若已具备高分辨率结构,把序列保守性与结构信息结合,通常比单看序列更可靠。
条件/工艺:从序列到可工程化位点的落地流程
一次完整的保守位点分析,通常从收集同源序列开始,经过多序列比对、保守性打分、结构映射与实验验证,最终输出可工程化的候选位点及其置信度。

保守位点分析从序列到工程化靶点的工作流
下图给出通用流程(示意图,非按比例):①收集同源序列(基因组/宏基因组/家族数据库)→ ②多序列比对→ ③计算保守性(熵/相对速率/ConSurf)→ ④把保守位点映射到结构(活性位点/催化三联体/口袋)→ ⑤验证与优先级排序(突变、活性测定、适应度景观)→ ⑥交付带置信度与证据的工程化靶点。
关键条件有三:序列要有足够多样性与代表性;比对与守恒打分要可复现;验证实验要能区分“预测”与“实测”。可进一步加入主动学习闭环——把验证结果反馈回去,迭代更新候选位点集合,减少无效实验。
MatwingsVenus®(晓鹜®)如何参与
MatwingsVenus®(晓鹜®)把保守位点分析嵌入“干湿闭环”平台,用AI模型对残基做功能预测、活性位点与可开发性评估,并以实测数据持续校验预测结果。
在MatwingsVenus®(晓鹜®)的路径中,你可以把序列交给平台:AI负责候选残基与活性位点的功能预测(【预测】字段),湿实验负责验证与表征(【实测】字段),两者在干湿闭环中互训,逐步把噪声位点过滤掉,把有限的实验预算花在高置信靶点上。
相关模块与支持:
• 湿实验产品与专家中心→提供序列→结构→候选位点→验证的完整实验路径与专业支持。
• 干湿闭环平台→预测与实测代代互训,减少无效实验,提升命中率。
• 如需要具体产品参数、案例数据或服务定价,请与我们联系。
FAQ:关于酶挖掘保守位点分析
什么是酶的保守位点?
保守位点是指在一组同源酶序列中,经过进化仍然保持高度一致的氨基酸位置;它们常对应催化残基、底物结合位点或结构折叠所必需的残基,因此是功能与稳定性分析的重要线索。
保守位点分析能直接确定催化残基吗?
不能直接确定。保守位点分析给出的是“候选”,必须结合结构定位(活性口袋、催化三联体/二联体)与实验验证(点突变、活性测定)才能确认哪些残基真正参与催化。
做保守位点分析常用哪些工具与指标?
常用多序列比对工具包括MUSCLE、MAFFT、Clustal Omega;保守性指标包括Shannon熵、相对熵、rate4site/ConSurf的进化速率等。建议用多种口径交叉验证,并明确数据来源与阈值。
保守位点分析对酶工程有什么用?
它把酶的可工程化空间缩小到“可动”与“不可动”:高保守位点是功能核心,尽量不突变;可变位点才是活性、稳定性、底物偏好优化的主要战场。
序列信息和结构信息哪个更重要?
各有侧重。序列信息覆盖面广、成本低,适合大规模筛选;结构信息能把“保守”落到具体化学功能上,更加可解释。两者结合通常最可靠;没有结构时可用预测结构替代,但需注明不确定度。
MatwingsVenus®(晓鹜®)如何支持保守位点分析?
MatwingsVenus®(晓鹜®)把保守位点分析嵌入干湿闭环平台:AI预测候选残基与活性位点,湿实验验证与表征,实测数据再反馈迭代,帮助你更快锁定可工程化的功能核心。
总结
保守位点分析从“找相似”走向“找功能”:先把同源序列放在一起,用守恒性打分找出进化中不变的位置,再映射到结构上判断谁在催化、谁在结合、谁在支撑折叠,最后用实验确认并排出优先级。对酶挖掘而言,它既是功能注释的入口,也是定向进化与工程化的安全边界。
【一句话结论】 保守位点分析把“挖掘”变成一次有方向的选择:高保守位点指向酶的催化机器,既是功能注释的入口,也是定向进化与工程化的安全边界。
探索MatwingsVenus®(晓鹜®)
想更系统地了解酶挖掘与保守位点分析?欢迎探索我们的湿实验产品、专家中心与干湿闭环平台,或查阅更多新闻与科学解读。深入产品:湿实验产品与专家中心|干湿闭环平台。
更多新闻
深入产品:湿实验产品与专家中心,专家中心,干湿闭环平台。