酶基因挖掘,关键不只在找到同源序列
发布于 2026年10月21日
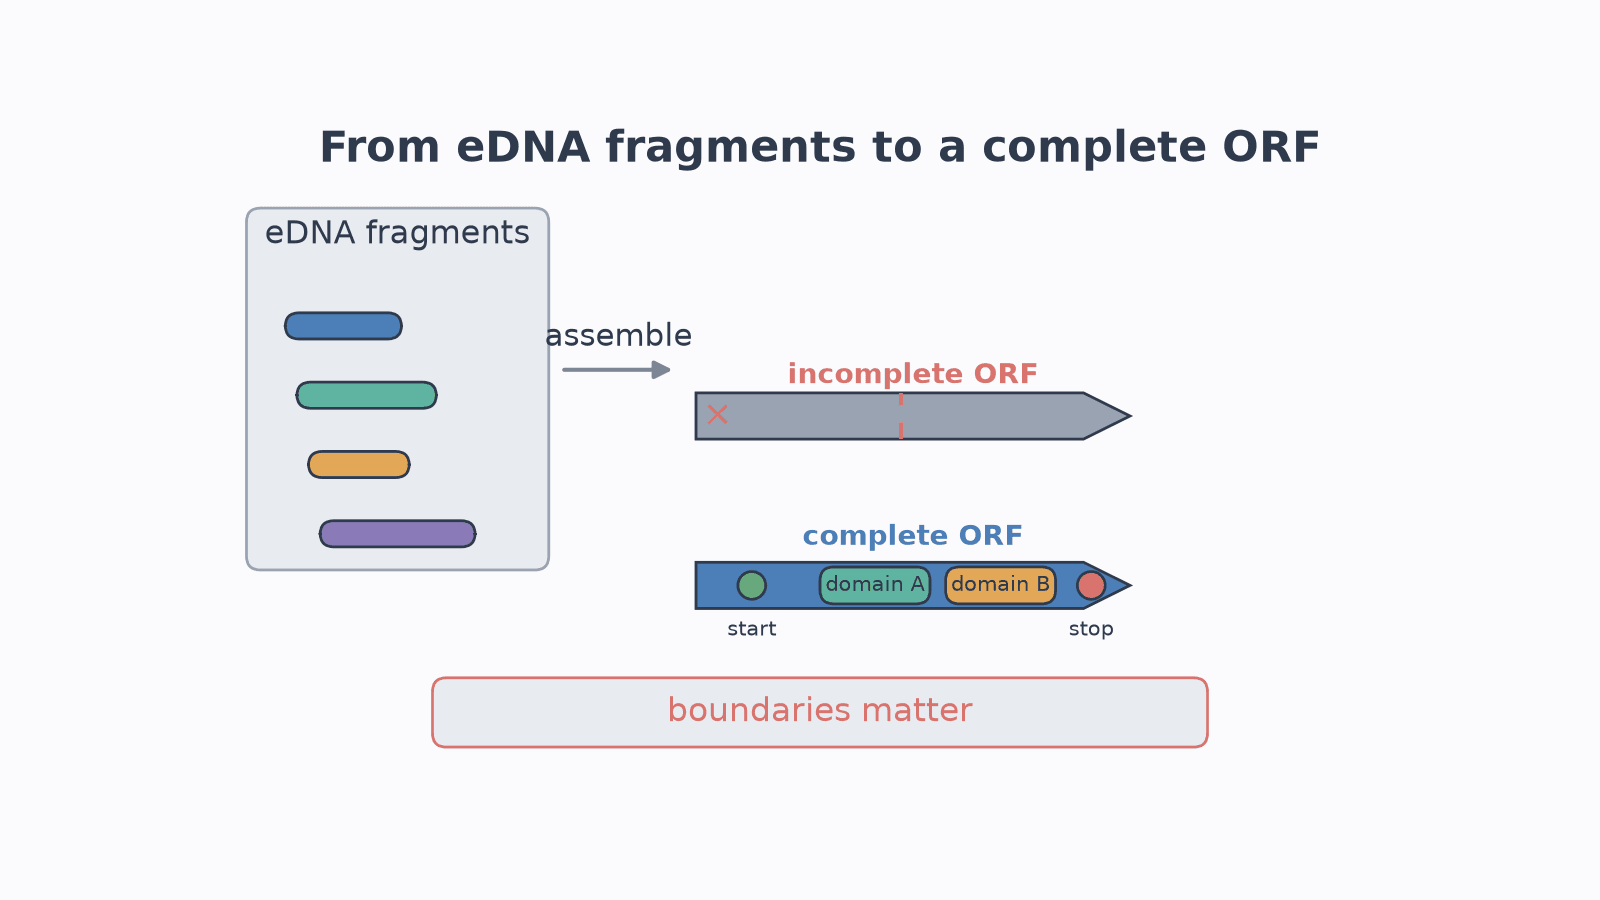
图1 从环境DNA片段确认完整开放阅读框
【分类】微生物生物技术/ 酶工程
环境中的微生物数量庞大,绝大多数无法在实验室里单独培养。宏基因组测序绕开“培养”这一步,直接从环境DNA中读取基因;然而,读到一段“像酶”的序列,并不等于找到了一条能表达、能催化的完整基因。装配断点、起始位点判错、提前终止与自动注释偏差,都可能把后续分析引向错误对象。因此,酶基因挖掘要从“这条基因本身是否可信”出发,而不是从相似度排行榜开始。对工业生物催化而言,一条可稳定表达、活性明确的天然酶,常意味着更温和的反应条件或更低的成本,起点更不容有失。
第一道关口:基因边界是否完整
判断一条候选基因,首先要看它的“起点—终点”是否清楚,而不是先看它像不像某个已知家族。
从片段到完整的开放阅读框
宏基因组数据由大量短片段拼成,候选基因可能位于拼接片段中部,也可能横跨装配边缘。开放阅读框(ORF)是从起始密码子到终止密码子的连续编码区;若它缺了开头、没了结尾,或少了关键结构域,翻译出的蛋白序列仍可能命中某个同源家族,却无法代表天然的完整酶。可以把开放阅读框想成一句话:起始密码子是句首,终止密码子是句号,中间不能出现让意思中断的停顿;拼接断点制造的,正是这种“断句”。
因此,在判断功能之前,应检查ORF的长度、起止位置、内部是否出现终止、有无移码迹象,以及与拼接片段边界的关系,并和近缘家族的典型结构域组成相互印证。长度异常不是直接淘汰的理由,但必须能解释它来自真实的生物差异、基因预测误差,还是装配不完整。
别忽略遗传密码的差异
翻译的“规则”并非处处相同。不同微生物群落、细胞器或特殊类群可能采用略有差异的遗传密码,简单套用默认参数会改变终止位点或蛋白长度。保留样本来源、装配版本与预测参数,候选才能在复核时经得起追溯。
第二道关口:基因组上下文能提供什么
基因很少孤立存在,邻居可以给线索,但邻居不能替代功能证明。
同一条代谢路径中的酶、转运蛋白与调控元件,常常在基因组相邻区域形成可解释的关联。若一个未知基因稳定地挨着某类底物代谢模块,就为它的功能推断增加了一层线索。这就像阅读一段文字,上下文常常能帮我们猜出某个生词的含义。

图2 基因组上下文为功能判断提供佐证
邻居是线索,不是证明
“邻居像什么”不能单独决定“它就是什么”。宏基因组拼接片段可能过短,邻域不完整;相邻基因也可能只是恰好共存,而非共同参与目标反应。稳妥的做法,是把邻域信息与保守基序、结构域、系统发育位置和已知反应证据交叉检查。
上下文还有助于判断基因是否属于多组分体系。有些催化过程依赖电子传递伙伴、辅因子合成或特定转运模块,单独表达核心酶未必能重现天然表型。提前识别这些依赖,可以避免把“缺少配套组分”误判成“这条基因没有功能”。例如,某些降解过程需要先由伙伴蛋白把底物转运进细胞,缺了它,核心酶即便表达出来也“无活可施”。
两条寻找路线:序列驱动与功能驱动
一条靠“长得像”,一条靠“干得了”,各有各的边界,最好互相补强。
序列驱动:从已知家族出发
序列驱动的发现以已知家族为入口,通过同源、基序、结构域、系统发育或结构线索扩大候选集合。它适合目标反应已有参考基因的任务,计算覆盖面大,也能追踪每条候选与已知证据的距离。但越依赖已知序列,越容易漏掉与参考家族差异较大的新型酶;低相似候选可能是真正的远缘成员,也可能是共享局部折叠但与目标反应无关,不能因为“新颖”就直接赋予目标功能。
功能驱动:从活性出发
功能驱动的宏基因组筛选从活性出发,把环境DNA片段送进宿主细胞表达,再寻找目标表型。它不必先知道候选属于哪个家族,有机会发现真正的新序列;但结果会受宿主能否正确转录、翻译、折叠,以及辅因子与筛选条件是否合适的影响。
两条路线可以互相补强:序列证据帮助设计更集中的候选集合,功能结果反过来为低注释基因建立真实的表型联系。酶基因挖掘不应把二者混成一个“万能算法”,而应根据已知参考、数据类型与实验能力选择主路线。实践中,可以从“最像”的一批候选入手,再逐步放宽到更远的同源,并用功能筛选回收漏网之鱼。
从候选基因到可用构建,还差几步
拿到一串核酸,不等于拿到一条能用的酶。
一个适合合成的候选,需要的远不止一串字符。首先要确认编码区完整,检查是否存在明显信号肽、跨膜区段或多结构域边界;随后根据表达宿主规划构建范围,判断是否保留天然前导序列、是否需要去除膜定位片段,以及是否可能依赖伴侣蛋白。

图3 表达与催化验证把候选连到真实功能
异源表达失败也不等于基因预测错误。密码子使用、启动子、折叠环境、翻译后修饰或辅因子供给,都可能限制蛋白产出。验证要区分“没有表达”“表达但不可溶”与“可溶却没有目标活性”,三种结果指向完全不同的下一步:只是没表达,先检查表达条件;表达却不可溶,常需更换标签、宿主或折叠伴侣;可溶却无活性,则要回到底物与反应条件。
真正的功能确认还要回到目标底物与应用条件。代理信号可用于初筛,但需要直接的底物反应、产物确认或适当的动力学表征来补充。成功与失败的数据都应和基因版本、构建方式、实验条件绑定,为下一轮缩小范围提供依据。
把蛋白层面的发现接续起来
确认核酸与蛋白序列后,平台可承接“天然蛋白发现与排序”。
MatwingsVenus®(晓鹜®)不替代宏基因组装配或ORF预测。确认候选编码区及其核酸序列、可靠获得对应蛋白序列后,平台承接天然蛋白发现与排序,遵循“先检索再挖掘”:先按功能检索策展资源,或用BLAST接收蛋白或核酸序列做同源搜索,优先复用已有证据。
当近缘结果多样性不足时,平台可在用户同意后扩大到结构挖掘。VenusMine以PDB或CIF结构为输入,寻找远缘同源与保守折叠,并返回候选及系统发育信息;只有序列时需先制备结构。候选集合形成后,可用VenusG结合理化性质计算开展蛋白候选评估,综合家族多样性、系统发育与Pareto排名,给出候选、FASTA与湿实验建议——这些属于预测与决策支持,不代表基因功能已经确认。
高质量的酶基因挖掘,不是从环境DNA中标出最多的彩色箭头,而是让每个候选都经得起四个问题:基因边界是否完整,邻域是否提供合理线索,蛋白证据是否支持目标反应,实验路径能否区分表达与功能。把这四层证据连起来,未知基因才有机会成为可验证、可复用的酶资源。平台把“发现—排序—建议”作为承接接口,基因合成、蛋白表达验证与纯化则交给后续湿实验,二者衔接,才不至于让发现停在纸面。
常见问题(FAQ)
问:测序中出现一段“像酶”的序列,能直接用吗?
不能。它可能被装配断点、错误起始位点或提前终止截断。要先确认这是边界完整的开放阅读框,再进入功能判断。
问:序列相似度越高,功能就越可靠吗?
不一定。相似度只反映同源关系;低相似候选可能是真正的新型酶,也可能是共享局部折叠但与目标反应无关,需要邻域、结构域与实验共同支持。
问:功能宏基因组学有什么优点和局限?
优点是不必预先知道候选属于哪个家族,有机会发现新序列;局限是依赖宿主能否正确表达与折叠,以及辅因子和筛选条件是否合适。
问:异源表达失败,说明基因预测错了吗?
不一定。密码子使用、启动子、折叠环境、翻译后修饰或辅因子供给都可能限制蛋白产出,需区分“没表达”“不可溶”与“可溶但无目标活性”三种情况。
问:什么是基因组上下文,有什么用?
指基因在染色体上的相邻区域。同一代谢路径的酶、转运蛋白与调控元件常在相邻处,可作为功能线索,但只能提供关联,不能替代功能证明。
问:如何理解“先检索再挖掘”?
即先检索已有策展资源与同源证据,优先复用已有知识,再考虑结构挖掘等重计算,减少重复与无谓开销。
小结
酶基因挖掘不能只盯着同源相似度。一条可信的候选要同时过四道关:边界完整、邻域合理、蛋白证据支持目标反应、实验能区分表达与功能。从环境DNA到可复用的酶,是证据层层加厚的过程,而不是一次相似度排序就能得到的答案。
【一句话结论】从环境DNA到可用酶,靠的不是相似度排行榜,而是让候选基因通过边界、邻域、蛋白与实验四道关。