目标反应酶怎么筛选:从候选发现到实验验证
发布于 2026年10月21日
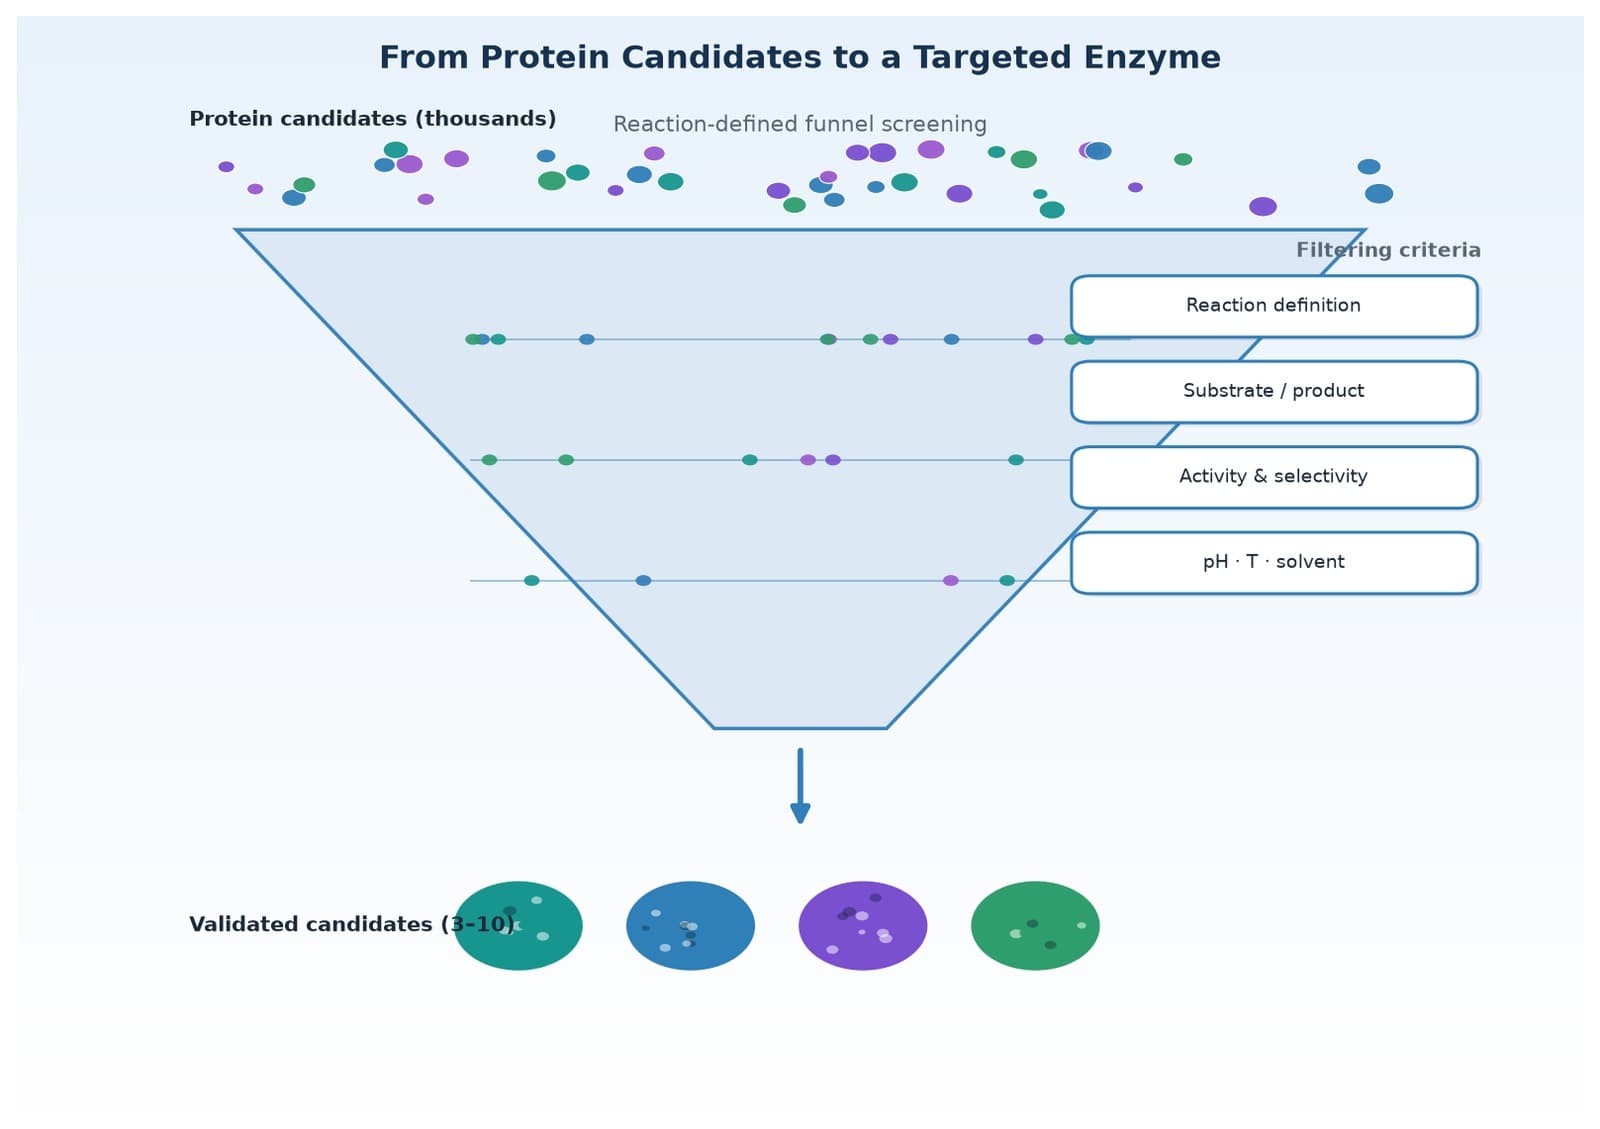
当研发人员搜索“目标反应酶怎么筛选”时,真正需要的不是一串数据库名称,而是一条能把反应需求、已知证据、候选排序与实验验证连接起来的路径。
目标反应酶怎么筛选,不能只靠“哪里能找到这个酶”来回答。项目须先说明需要催化什么键、接受哪些底物、排斥哪些副反应,以及在怎样的温度、pH、溶剂和表达体系中工作。目标不清,搜索结果越多,后续筛选反而越慢。更有效的做法,是先把目标反应翻译成可搜索、可排序、可测量的标准,再逐层收缩候选空间。
一、先定义“目标”,再讨论目标反应酶怎么筛选
筛选的第一步不是下载序列,而是建立反应规格:要清楚底物与产物分别是什么、反应中心与辅因子是什么、活性、选择性与转化率门槛是多少、温度、pH、溶剂与离子环境如何,最终采用什么宿主与检测方法。
这一步直接决定筛选能否闭环。高通量筛选的价值,不只在于“测得多”,更在于目标表型能否与检测方法稳定耦合;若检测信号不能准确反映目标反应,即便测了大量变体,也可能放大错误方向。因此建议先确定最小可行测定:明确阳性、阴性、空白对照,规定重复数、检测窗口与淘汰阈值,再向上扩充通量。
对话式蛋白质研发智能体适合在此阶段把自然语言需求拆成搜索条件、过滤条件与验证条件,并提示哪些必须满足、哪些可后续优化。它的价值不是替代实验决策,而是让需求定义成为后续检索与排序都能复用的结构化起点。
二、用三层证据建立候选池,而不是只看相似度
数据库证据
若目标反应已有已知酶,优先从权威蛋白质、功能、通路与酶动力学数据库寻找实测记录,核对物种来源、底物范围、反应条件与证据类型。数据库注释可建立基线,但不能把同一个功能标签直接等同于当前工艺条件下可用。
序列证据
序列同源搜索适合寻找近邻候选,并结合保守位点、结构域与家族信息判断功能是否可能延续。要警惕“整体相似但活性位点不同”,也要避免只保留最相似的少数序列,从而失去可能具有更好耐受性或底物谱的远缘候选。
结构证据
当序列相似度较低、注释稀疏或底物特异性难以判断时,可比较整体折叠、催化残基几何关系与底物口袋。结构相似性搜索有机会发现远缘同源,但结构相似≠催化功能相同,必须与反应机制、关键残基和实验读出交叉验证。

序列、结构与活性位点共同组成候选排序的证据链
在实际工作中,对话式蛋白质研发智能体可先编排数据库查询、序列同源搜索与结构相似性搜索,把结果统一到候选档案,并区分数据库实测信息、计算预测与未知项。这样,团队看到的不是混杂的结果页,而是可追踪的候选证据链。
三、排名不是选“最高分”,而是做多目标取舍
候选池建立后,按项目阶段设置分层门槛。
第一层:先排除硬性不合格项
例如关键催化残基缺失、明显不兼容的辅因子需求、无法接受的跨膜特征或表达风险。
第二层:评估反应相关属性
包括活性位点可信度、底物口袋匹配、可能的kcat、最适温度与pH。
第三层:加入制造维度
如溶解度、稳定性、表达宿主适配性与纯化难度。
预测工具可帮助缩小实验范围,却不能把预测值包装成实测结果。更稳妥的做法,是把每项结论标成“实测、预测或未知”,并记录预测适用范围。多目标冲突时,不宜把所有指标粗暴相加成一个总分;可先保留一组各有优势的候选,再按当前项目最紧迫的约束选择3~10个进入实验。
对话式蛋白质研发智能体能根据已确认任务,衔接功能位点、溶解度、稳定性、最适温度、pH、kcat与理化性质分析,并把“为什么保留、为什么淘汰”写入候选记录。需要重计算的任务,应执行前确认输入、成本与预期输出,避免把计算流程变成新的黑箱。
四、对话式智能工作流:目标反应酶怎么筛选并验证
候选数量缩小后,验证顺序应从低成本、可排错的指标开始:先确认表达与可溶性,再验证目标底物上的活性,最后测定选择性、动力学参数与工艺条件耐受性。若一开始就把所有候选推入昂贵的完整动力学测试,失败后往往难以判断问题来自表达、折叠、检测体系还是催化本身。
建议每轮实验都保留原始读数、实验条件、批次信息与阴性结果。阴性结果并非“无用数据”,它能帮助下一轮识别错误注释、检查同源序列、建立证据等级与停止条件。若已有可靠的序列—功能数据,可进一步做功能位点测绘、单点突变评估、多点组合建模或数据驱动的定向进化;但推荐突变仍需明确标注为预测,并通过实验确认。

计算筛选与湿实验验证共同形成持续优化闭环
五、常见问题:让筛选范围更快收敛
没有参考酶,目标反应酶怎么筛选?
先从反应类型、底物结构、酶家族与反应条件建立功能关键词,再检索功能数据库与家族资源。若策略记录不足,可扩大到序列与结构层面的天然蛋白发现;仍无合适候选时,才评估是否进入全新支架设计。每一步都应保留证据等级与停止条件。
只有一条蛋白序列,可以直接判断功能吗?
不建议直接下结论。应先识别蛋白身份,检索同源序列、结构域、保守位点与已有数据库注释,再决定是否需要功能位点或属性预测。预测结果适合形成可验证假设,不应替代酶活实验。
候选越多,筛选成功率越高吗?
不一定。候选规模必须与检测通量和读出质量匹配。能稳定区分阳性、阴性、背景噪声的测定体系,通常比未经约束地扩大候选库更重要。先用证据和硬性条件收缩范围,再提高实验通量,往往更经济。
六、总结:把一次搜索变成可复用的研发流程
“目标反应酶怎么筛选”的核心,是把反应定义、检索证据、序列与结构分析、多目标排序、湿实验验证与后续改造连成闭环。理想的智能工作流应先检索、再预测,对实测与预测清晰标记,并让每次实验结果回流到下一轮决策中。这样,筛选不再是一场依赖运气的候选堆叠,而会成为能解释、能复盘、能持续优化的研发系统。
【FAQ】
Q1 没有参考酶时,应该从哪里开始?
从反应类型、底物结构、酶家族与反应条件建立功能关键词,先检索功能数据库与家族资源;证据不足再扩大到序列与结构层面的天然蛋白发现,仍无合适候选才考虑全新支架设计。每一步都保留证据等级与停止条件。
Q2 只凭一条序列就能判断酶功能吗?
不建议。应先识别蛋白身份,检索同源序列、结构域、保守位点与已有注释,再决定是否需要功能位点或属性预测;预测结果适合形成可验证假设,不能替代酶活实验。
Q3 候选越多,成功率越高吗?
不一定。候选规模必须与检测通量和读出质量匹配;能稳定区分阳性、阴性、背景噪声的测定体系,通常比盲目扩大候选库更重要。先用证据和硬性条件收缩,再提高通量更经济。
Q4 计算或AI预测的结果可以直接用于生产吗?
不能直接当作实测。应把每项结论标成“实测、预测或未知”,记录预测适用范围;推荐突变需明确标注为预测,并经实验确认后方可放大。
Q5 为什么要记录阴性结果?
阴性结果并非“无用数据”。它能帮助下一轮识别错误注释、检查同源序列、建立证据等级与停止条件,是让筛选持续收敛、可复盘的关键。
【小结】
目标反应酶筛选不是一次“大海捞针”,而是“定义反应规格→三层证据建池→多目标排序→低成本闭环验证”的可复用流程:先检索、再预测,对实测与预测清晰标注,并让每次实验结果回流到下一轮决策。这样,筛选才能从依赖运气的候选堆叠,变成能解释、能复盘、能持续优化的研发系统。