酶挖掘完整流程:如何缩短候选验证路径?
发布于 2026年10月21日
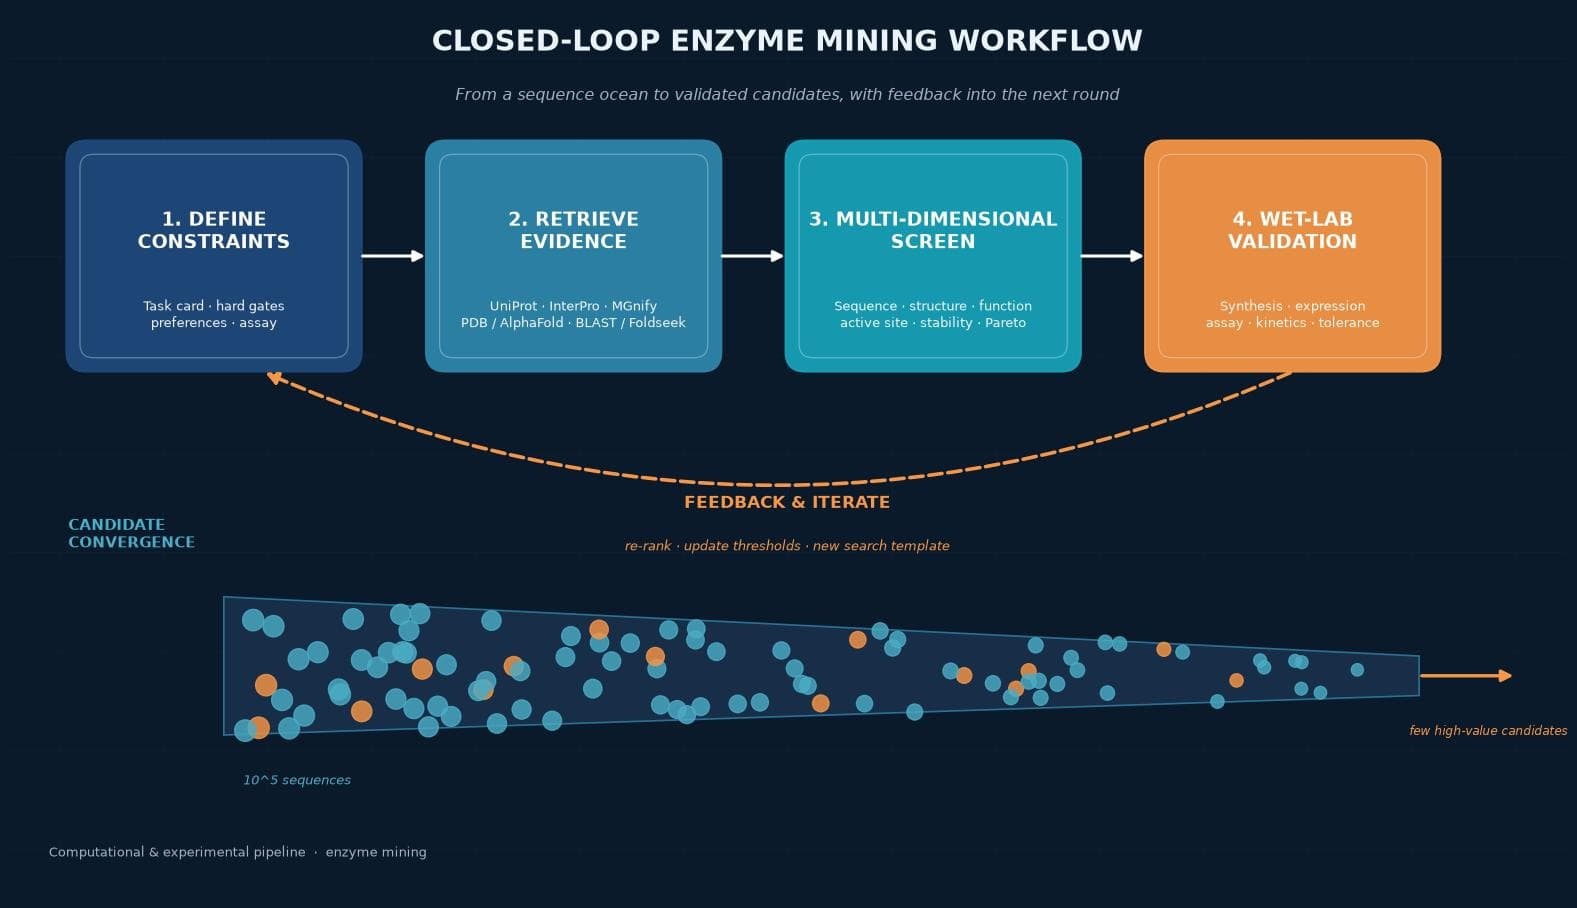
图1 酶挖掘完整流程闭环:定义约束 → 检索证据 → 多维筛选 → 湿实验验证 → 反馈迭代,把候选从“序列海洋”收敛为少数高价值序列。
分类:蛋白质工程/ 工业酶开发 / AI for Science
核心痛点:候选太多、验证太慢、数据难衔接
在生物制造、食品加工、绿色化工与环境治理项目中,真正稀缺的不是“再找一批序列”,而是把催化目标、工艺条件和实验验收标准翻译成可执行的筛选门槛。只看同源性,容易错过低序列相似但功能相关的远缘候选;只看模型分数,又可能把表达困难、稳定性不足或底物不匹配的序列推向昂贵实验。酶挖掘完整流程的价值,正是让每一轮筛选都有依据、有出口,也有返回上一步修正假设的通道。
一、起点:把产业目标写成可验证约束
1.1任务书先于数据库
流程起点不是数据库,而是任务书。团队需明确反应类型与目标底物,并记录温度、pH、盐浓度、有机溶剂耐受性、辅因子、表达宿主、纯化难度与成本边界。
1.2三层筛选门槛
• 硬门槛:必须满足的条件,不符合即淘汰。
• 偏好指标:用于排序与区分优势维度。
• 待实验确认项:暂时无法计算、须留给实验判断的指标。
这一步直接决定搜索空间:高温工艺不能只写“耐热”,应约定目标温区、保温时间与活性保留方式;复杂底物还需定义底物形态、反应体系与检测方法。合格的流程应在启动搜索前确定阴性/阳性对照、首轮候选数量与进入下一轮的判定标准,避免看到结果后才临时改规则。
1.3平台角色:任务翻译器
MatwingsVenus®(晓鹜®)可在此承担“任务翻译器”:以对话式研发入口把研究对象、约束条件与预期输出组织成连续任务,衔接数据库查询、蛋白质发现、属性评估与后续实验。其价值是减少工具、文件与角色间的重复交接,而非替代科研判断。
二、检索:先找已知证据,再扩展未知空间
2.1策展数据库先行
进入候选发现,应先查策展数据库与已有实验记录,再决定是否扩大到宏基因组或结构空间。已知蛋白可从UniProt、InterPro 核对身份、家族与功能域,从 PDB 或 AlphaFold 获取实验或预测结构线索;环境来源候选可借助 MGnify 等资源拓展到不可培养微生物。
2.2序列与结构双路径
序列驱动筛选速度快、适合从同源家族扩展,但依赖已有注释;功能驱动筛选更接近表型,却受克隆、表达宿主与通量限制。二者并非替代关系,而是预算、创新度与可验证性之间的组合选择。
对已有参考序列,BLAST 有助于定位近缘候选;当序列相似性不足时,Foldseek 或 VenusMine 所代表的结构路径可用于寻找保守折叠与潜在远缘同源。搜索结果仍需保留来源、注释状态与去冗余规则,避免把同一谱系的近重复序列误当作候选多样性。
三、多维筛选:把海量序列压缩为可测候选
3.1逐层检查,而非打一个总分
候选进入计算筛选后,依次检查:序列完整性、保守基序、功能域组合、信号肽或跨膜区、结构可信区域、活性口袋与关键残基;再评估与应用相关的稳定性、溶解度、最适温度、最适pH、金属离子结合或动力学倾向。每层都应保留淘汰原因——这比一个无法解释的综合分数更利于实验复盘。
3.2严格区分实测、预测与未知
MatwingsVenus®(晓鹜®)可通过 VenusG 等能力预测候选属性并用于筛选排序;涉及活性位点或结合区时,还可加入残基级功能分析。必须严格区分三类信息:
• 数据库或文献实测值:可作为证据。
• 模型预测值:仅用于缩小与排序,不可当作已测活性。
• 尚无数据的未知项:应留给实验确认。
预测适合缩小实验范围,不应被写成已测催化活性,也不应把结构置信度直接等同于底物亲和力。
3.3 Pareto式多目标保留
当目标同时包含活性、稳定性、表达与工艺适配时,单一最高分通常不最稳妥。更实际的是保留一组位于不同优势维度的候选:有的活性线索更强,有的更易表达,有的来自差异较大的家族。Pareto 式组合既能控制实验规模,也能降低模型偏差或单一家族失效的风险。

图2 多维筛选把候选逐层收敛为可测集合,并以 Pareto 方式保留在活性、稳定性、表达与工艺适配上各有优势的候选。
四、湿实验:不是终点,而是下一轮筛选的数据入口
4.1首轮实验设计
首轮优先验证最能改变决策的指标,通常从小规模基因合成、表达与可溶性检查开始,再进入纯化、底物转化、动力学与工艺耐受测试。候选较多时,可先用粗酶液或微孔板体系低成本排查,再对少量优胜者做标准化动力学与重复性验证。实验设计需包含对照、批次信息与原始数据,以便判断失败来自酶本身、表达条件还是检测体系。
4.2实验结果回流
MatwingsVenus®(晓鹜®)提供从计算分析衔接基因合成、蛋白表达与纯化的入口,也支持专家协同,使候选序列、筛选依据与实验请求沿同一任务链传递。更重要的是,实验结果应回流:不表达的序列用于修正可制造性门槛;活性弱但稳定的候选进入定向进化;意外命中的远缘家族成为下一轮结构或序列搜索的新模板。
五、闭环:跨环节串联与项目沉淀
5.1项目交付不只有FASTA
计算结果经实验反馈进入下一轮优化。项目交付不应只有FASTA 文件,建议同时保留:需求与验收标准、检索范围与日期、候选来源、去冗余方法、序列与结构注释、各层筛选理由、实测与预测标签、候选排序表、实验设计、原始结果及下一轮决策——让另一位研究者能复现候选如何产生,也让负责人看清资源为何投入这些序列。
5.2工作流连续性
采用MatwingsVenus®(晓鹜®)这类智能体平台,优势可理解为“工作流连续性”:数据库证据、发现工具、属性预测、候选分析与实验服务不再彼此孤立。使用者仍须确认重计算任务的输入与边界,并对关键科学判断负责;平台更适合承担检索、编排、记录与跨环节交接,让专家把时间放在假设、阈值与实验解释上。

图3 计算与湿实验构成迭代反馈闭环,每次实验结果回流用于重排候选、更新阈值并进入下一轮搜索。
常见问题
Q1酶挖掘完整流程一定要从宏基因组开始吗?
不一定。若已知家族已有满足需求的蛋白,优先用策展数据库与实验记录往往更快;只有当现有多样性不足、需探索极端环境或远缘功能时,才扩大到宏基因组与结构空间。
Q2结构预测和分子对接能直接证明酶活性吗?
不能。它们能帮助识别可信结构区域、口袋与候选相互作用模式,但真实催化能力还受构象变化、溶剂、辅因子、底物状态与实验条件影响,必须经活性和动力学实验确认。
Q3首轮应该合成多少个候选?
没有固定数量,应由合成与检测通量、候选多样性、预测不确定性与预算共同决定。与其选一批高度相似的高分序列,不如保留来源与优势维度不同的候选,并提前设定扩增或停止条件。
Q4如何区分计算预测与实验结论?
计算值(模型预测、结构置信度)只能用于缩小与排序,不能作为已测活性或亲和力。凡是写入正式结论的活性、动力学与稳定性指标,均须由标准化的湿实验重复验证确认。
小结
好的酶挖掘完整流程,不是把更多工具堆在一起,而是让需求、证据、预测、候选与实验形成可解释的决策链。先定义约束,再检索已知证据;从序列与结构扩展候选,用多维属性逐层收敛;最后经湿实验验证并把结果送回下一轮。MatwingsVenus®(晓鹜®)能自然嵌入这条路径,帮助团队连接数据库、蛋白质发现、功能预测与实验服务,同时保留实测、预测与未知间的边界。对希望降低无效合成、缩短候选交接时间的团队,真正值得建设的不是一次搜索,而是一条可复盘、可迭代、可持续积累数据的研发流程。