蛋白质通路分析,显著通路真的代表被激活吗?
发布于 2026年10月12日
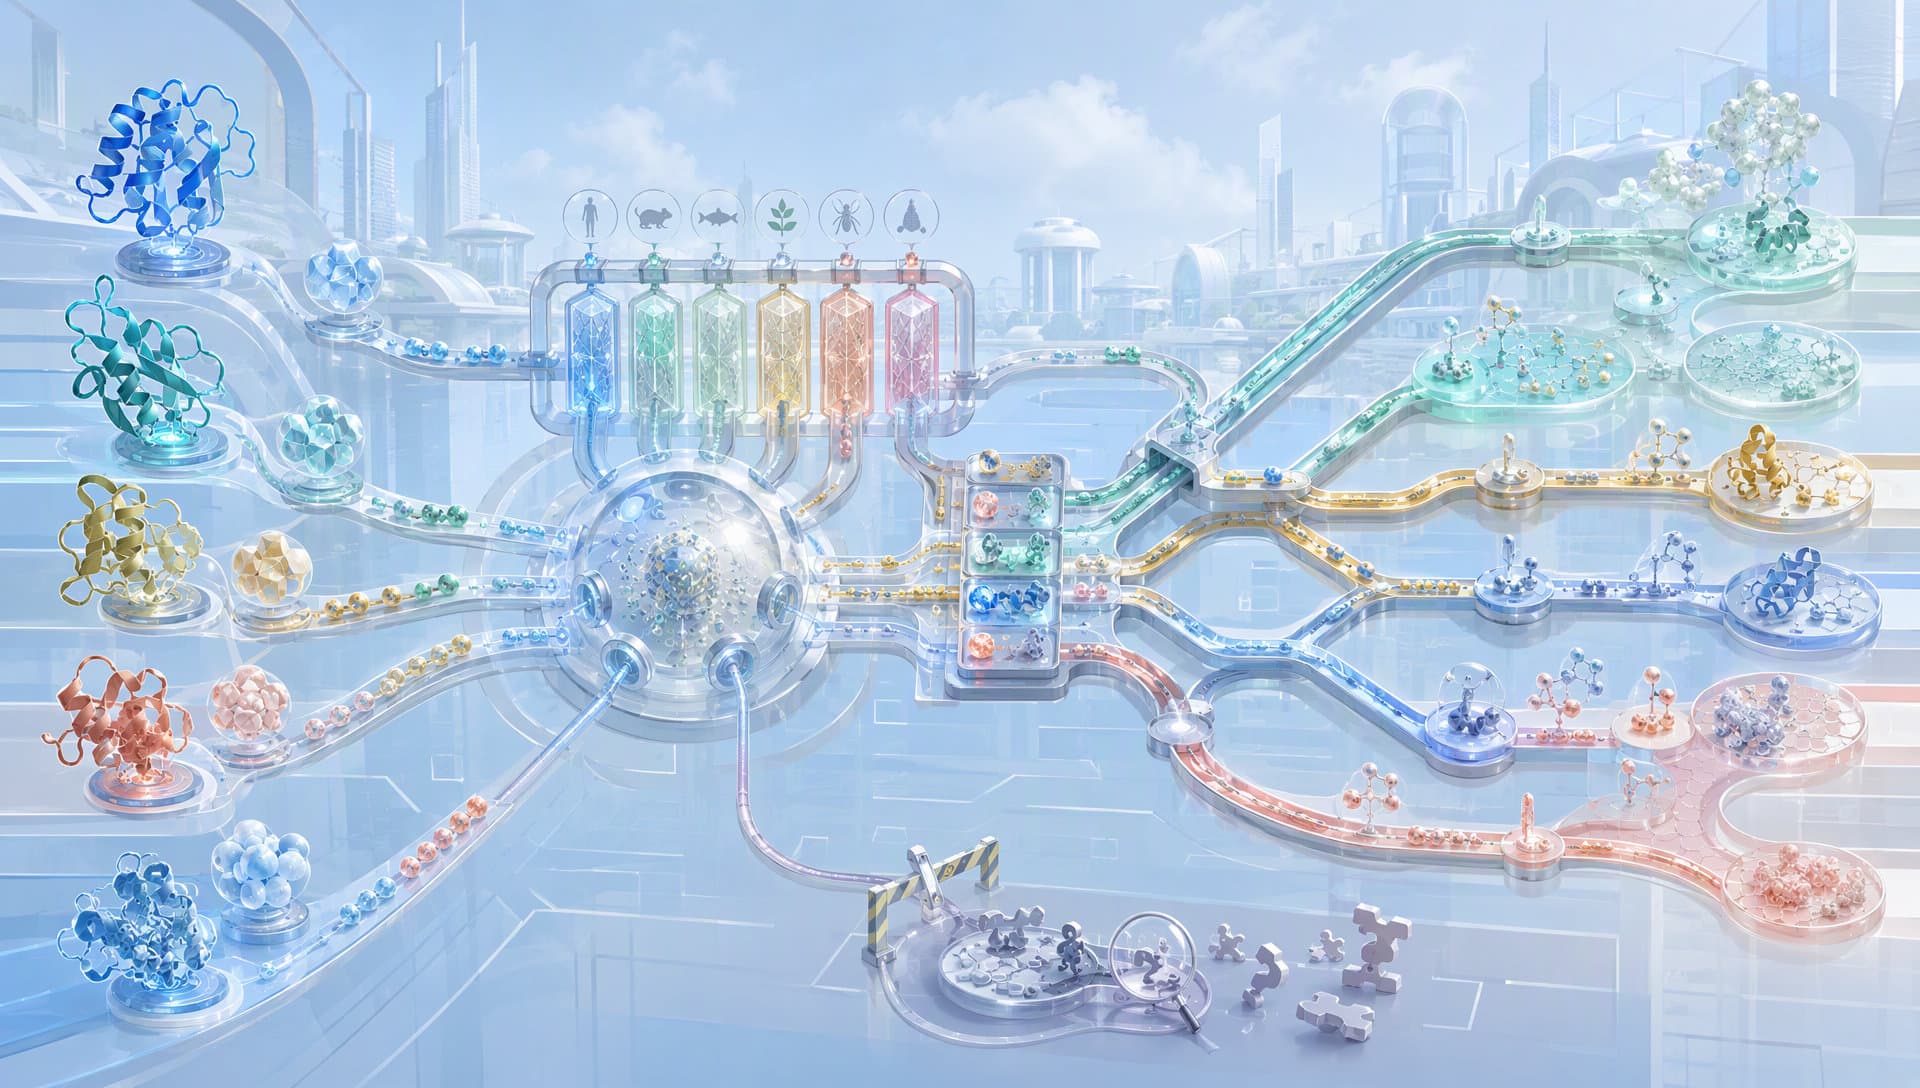
先校准蛋白身份,再进入通路网络
蛋白质通路分析先要分清两个问题
研究者常把两类任务放在同一个搜索框里:一类是询问“某个蛋白参与哪些已知生物过程”,另一类是判断“一组实验蛋白在哪些通路中过度出现”。前者偏向数据库检索与知识归属,后者通常涉及富集统计。若没有先明确问题,即使得到一张漂亮的通路图,也可能回答了错误的问题。
对单个蛋白,重点是物种、同工型、亚细胞定位、复合物成员关系及已有通路记录;对蛋白集合,则要进一步考虑筛选阈值、参考背景、命中比例和多重检验。换句话说,蛋白质通路分析不是把名称贴到网络上,而是先定义“谁与谁比较、依据什么知识、要回答哪类问题”。
MatwingsVenus®(晓鹜®)可通过智能对话承接研究问题,并将蛋白或基因标识符导向UniProt、Gene Ontology(GO)、Reactome、KEGG 等知识资源的检索与整理。这里的价值在于缩短信息组织链路,而不是让模型替代数据库证据,更不是自动生成一条“已证实”的机制。
第一道关:先处理标识符,而不是先看气泡大小
同一个蛋白可能以UniProt accession、基因符号、旧名称或同工型编号出现。列表中还可能混入不同物种、重复条目和无法映射的对象。Reactome 的分析文档明确提示,输入标识符会先映射到通路实体,未成功映射的条目也需要检查。若这一层处理不完整,后续“没有富集”可能只是因为蛋白没有被数据库识别。
一个稳妥的输入整理顺序是:
1. 确认研究物种与样本条件;
2. 统一标识符类型,保留原始编号以便回溯;
3. 处理重复蛋白、同工型与一对多映射;
4. 记录成功映射、歧义映射和未映射比例;
5. 再决定哪些对象进入统计分析。
这一步看似基础,却决定了通路分析的可解释上限。对于未映射对象,不应简单删除:它们可能代表命名过时、序列尚未充分注释,也可能是值得单独核查的未知信号。借助MatwingsVenus®(晓鹜®)的数据库检索与蛋白序列分析能力,研究者可以把这些条目分为已有实验支持的Measured、来自计算推断的Predicted,以及证据仍不足的Unknown,避免把不同确定性的内容混写成一个结论。
蛋白质通路分析的显著性究竟说明什么
常见的过度代表分析会问:在当前输入列表中,落入某条通路的蛋白是否比随机预期更多。Reactome 的相关工具采用超几何检验,并用 Benjamini–Hochberg 方法控制多重检验下的 False Discovery Rate(FDR)。因此,显著结果首先是一种统计富集信号,而不是生物学“开关”。
至少有四个因素需要与FDR 一起查看:
• 背景集合:若实验只能检测到部分蛋白,背景应尽量接近“有机会被检测到的总体”,而非默认使用所有已知蛋白;
• 通路大小:超大通路容易吸收更多命中,小通路则可能由少数蛋白驱动;
• 命中结构:命中的是多个独立节点,还是同一复合物的一组成员;
• 数据版本:数据库内容持续更新,不同时间的注释范围可能改变结果。
所以,“FDR 较低”可以支持该通路值得优先审查,却不能单独证明它被激活、被抑制或导致了某种表型。蛋白丰度上升与通路活性增强也并非同义:关键步骤可能受磷酸化、定位变化、复合物装配或抑制蛋白控制。

显著性要放回背景与证据中理解
别只看排名:把方向、拓扑与条件放回通路
排名列表压缩了很多信息。更有价值的做法,是把丰度变化、磷酸化水平或其他观测值叠加到通路图上,观察信号集中在入口、核心反应、分支节点还是末端效应区。通路拓扑能够提示“覆盖发生在哪里”,但它并不给出机制成立的概率,也不能替代实验。
例如,同一条通路中既有上调蛋白也有下调蛋白,可能反映反馈调节、细胞群体差异或时间相位错位;若命中集中在共享上游节点,多条显著通路可能只是同一信号模块的重复投影;若结果依赖外部互作扩展,还要警惕未经充分策展、条件不匹配或意义不明的关联被引入网络。
因此,解释一条候选通路时,建议按以下顺序追问:实验条件是否支持该过程发生?关键蛋白是否真实测得?变化方向是否一致?命中是否覆盖决定性步骤?是否存在另一条更简单的解释?这套问题能把“看图讲故事”转化为可证伪的研究假设。
一条可执行的蛋白质通路分析工作流
可靠流程不追求一次点击给出终局答案,而是逐层减少不确定性:
第一步,定义比较。 明确样本、处理条件、时间点、筛选规则和可检测背景,保留原始数据与分析版本。
第二步,统一身份。 完成物种、蛋白ID、同工型和重复项处理,把未映射对象单独列出。
第三步,检索已知知识。 在Reactome、KEGG、GO 等资源中查看通路、反应、功能和证据记录,区分数据库事实与计算推断。
第四步,运行并审查富集。 同时查看命中数、通路大小、FDR、背景设置及相近通路之间的重叠,不凭单一排名下结论。
第五步,回到蛋白层。 将丰度、修饰、定位、结构域或结构信息叠加到关键节点,识别真正影响解释的证据缺口。
第六步,设计验证。 为核心节点安排正交检测、扰动实验、时间序列或结合验证,并把阴性结果也纳入模型修订。
在MatwingsVenus®(晓鹜®)中,这条任务链可由对话入口开始:输入单蛋白或蛋白列表,组织数据库检索与已知功能记录,再对关键对象继续开展蛋白功能预测、结构预测或更深入的文献核查。涉及重计算、参数选择与关键结论时仍应由研究者确认;平台的角色是连接任务与证据,而不是替代实验决策。

网络位置最终要回到实验闭环
怎样判断结果已经足够支持下一步
一份可用于决策的蛋白质通路分析结果,至少应让读者回答五个问题:输入对象是否完整可追溯?背景集合为何这样设定?显著性是否经过多重检验?关键命中在网络中处于什么位置?哪些结论是实测,哪些只是预测,哪些仍未知?
若这些问题没有答案,增加更多彩色通路图不会让结论更可靠。相反,主动展示未映射蛋白、证据冲突和替代解释,往往更有助于筛选下一轮实验。通路分析真正的产出,不是一张“机制已完成”的示意图,而是一组经过优先级排序、能够被验证或推翻的假设。
让通路成为研究导航,而不是结论终点
蛋白质通路分析最适合承担导航角色:它把分散的蛋白变化放进已知生物过程,帮助研究者发现值得追踪的模块与关键节点。但富集不等于激活,连接不等于因果,预测也不等于测量。只有把标识符质量、统计边界、通路拓扑和蛋白层证据一并呈现,结果才具有可复核性。
对于需要把蛋白列表继续推进到功能核查、结构理解和验证设计的项目,MatwingsVenus®(晓鹜®)提供了一个可对话的任务组织入口。以数据库记录为锚点、以Measured / Predicted / Unknown 标注证据层级,再让实验回答真正关键的问题,才是把通路图转化为研发行动的稳健方式。