
蛋白质多模态模型:多模态AI如何重塑蛋白质研究
发布于 2026年11月2日
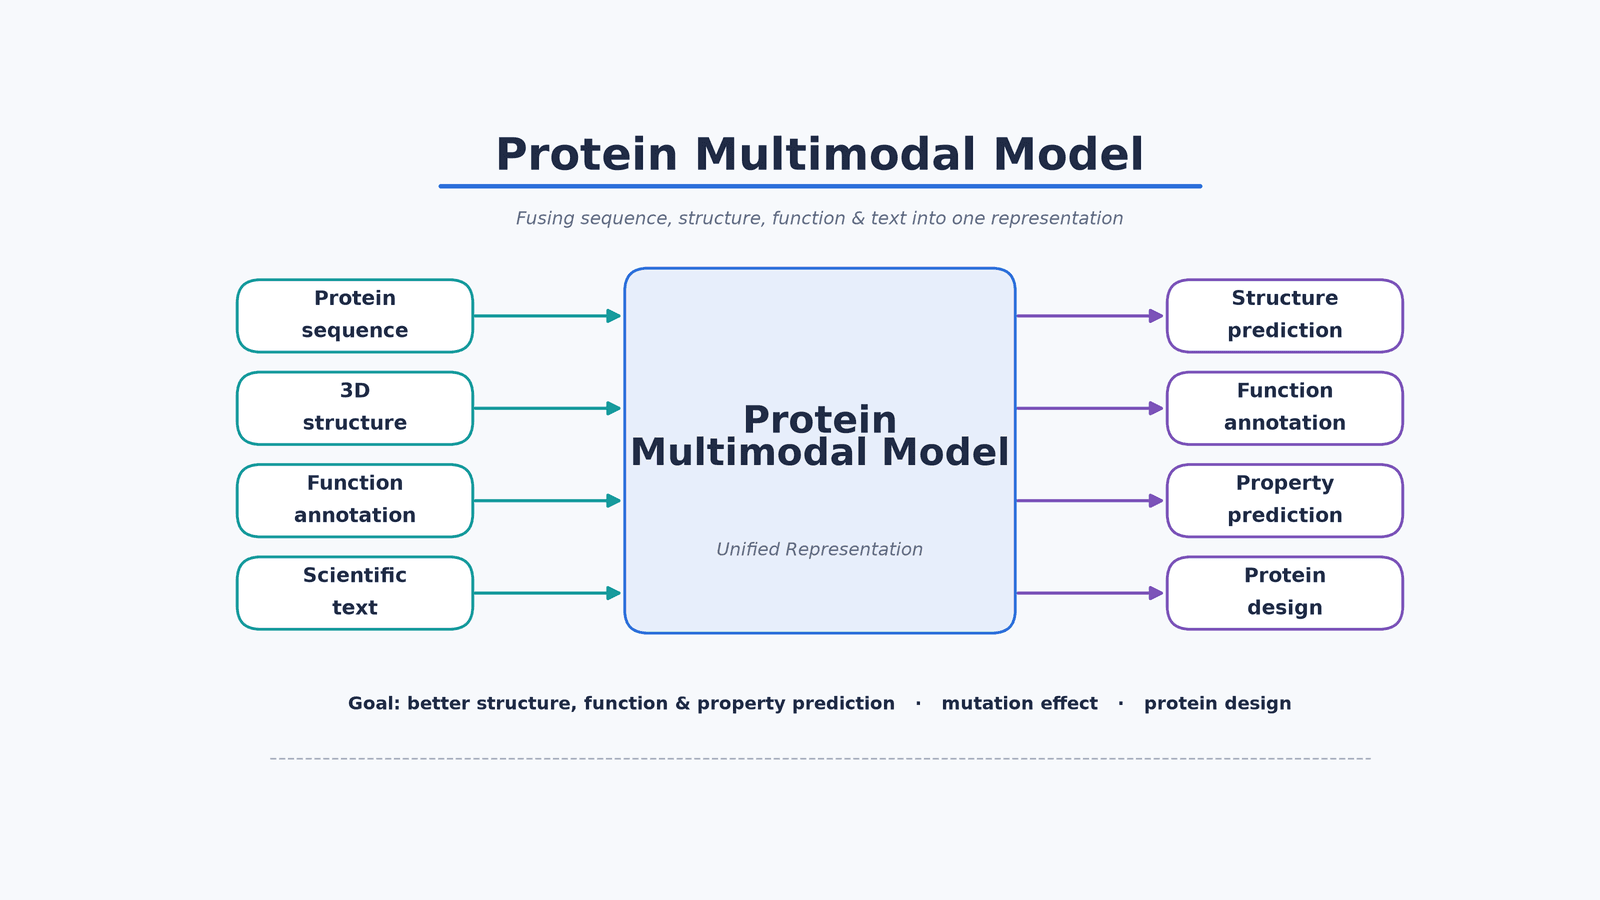
图1 蛋白质多模态模型融合多源信息为统一表征
分类 主类D(AI / 算法 / 平台)· 概念科普 + 能力边界;副类涉 A(蛋白研究机制)。插图风格:数据 / 示意图。
过去几年,AI 在蛋白质领域的能力飞速提升:有的模型擅长“读懂”氨基酸序列,有的擅长“画出”三维结构,有的擅长“解释”功能。但它们大多是各干各的。蛋白质多模态模型试图把这几件事统一起来——让 AI 同时“看”到序列、结构、功能与科学文献,从而更接近人类对蛋白质的整体理解。
背景与机制:为什么蛋白质研究需要多模态模型?
蛋白质的功能由序列、三维结构、动态构象与相互作用共同决定,单一模态信息往往无法全面刻画;蛋白质多模态模型把序列、结构、功能与文本等多源数据映射到同一表征空间,从而更完整地理解蛋白质。
蛋白质不是一条静止的字符链。氨基酸序列只给出“一维”信息,但真实功能还取决于它如何折叠成三维结构、如何与其他分子相互作用,以及翻译后修饰与动态变化。过去,研究者往往把序列模型、结构模型与功能注释分开训练,每一个都只能看到“冰山一角”。
用一个人做类比:只凭一张照片很难了解一个人的全貌;若能同时看到照片、聊天记录与背景履历,判断就全面得多。多模态蛋白模型做的正是这件事——把来源不同的证据(sequence、structure、function、text)对齐到同一个语义空间,让模型一起“阅读”。
· 信息互补:序列模型擅长捕捉共进化信号,结构模型擅长空间几何,功能注释与文本提供语义先验。
· 更强泛化:多模态联合训练可在单一模态数据稀缺的蛋白家族上借用其他模态信息。
· 更贴近真实生物学:蛋白质功能本质是多因素耦合,多模态更接近“整体大于部分之和”。
原理与结构:蛋白质多模态模型如何工作?
蛋白质多模态模型通常以蛋白语言模型编码序列、以图神经网络或几何模型编码结构,再通过跨模态注意力与对比学习对齐表征,最终以多任务方式联合预测结构与功能。
一个典型的蛋白质多模态模型包含三条“编码支路”与一个“融合层”:
· 序列支路(Protein Language Model):采用掩码语言建模,从海量无标注蛋白序列中学习氨基酸的共进化与位置依赖,代表如基于Transformer 的自监督蛋白语言模型。
· 结构支路(Graph / Geometric Network):把蛋白质建模为图(节点=残基或原子,边=空间邻近),或用几何深度学习编码三维坐标,捕捉空间构象与距离关系。
· 语义支路(Text / Knowledge):引入基因本体(GO)、酶学分类(EC)、功能位点注释与科学文献文本,提供生物语义先验。
融合层是模型的关键:
· 跨模态注意力:让不同支路的表征互相“提问与回答”,例如结构支路询问序列支路某残基的保守性。
· 对比学习:拉近同一样本不同模态的表征,推开不同样本。
· 多任务目标:同时优化结构、功能、性质等多个损失,迫使模型学到共享的“蛋白质通用表征”。
模型常见的输出任务包括:
1. 结构预测:给定序列预测三维结构,常用TM-score / lDDT 评估。
2. 功能注释:预测GO / EC 标签、活性位点与结合位点。
3. 性质预测:预测稳定性、溶解性、表达量等(回归或分类)。
4. 突变效应预测:评估单点或多点突变对功能与稳定性的影响。
能力边界同样重要:
· 依赖对齐数据:若序列、结构、功能数据不同步或噪声大,融合反而可能引入偏差。
· 文本模态易“幻觉”:需要可验证的湿实验或权威注释来校验。
· 预测≠实验:高置信度预测仍需实验确认。

图2 序列、结构、语义三条支路经跨模态注意力融合
评测与选型:如何评估与选择蛋白质多模态模型?
选择蛋白质多模态模型需同时看任务匹配、评测基准、数据覆盖与可解释性;结构任务看TM-score 与置信度,功能与性质任务看 AUROC 与相关性,并要检查对未见家族的泛化。
选型的第一步是明确任务,再据此选择指标:
· 结构预测:看TM-score、lDDT 与已知结构的一致性。
· 功能/ 分类:看AUROC、精确率/召回率、F1 等。
· 性质/ 突变效应:看与实验数据的相关系数(Pearson / Spearman)与 RMSE。
· 数据覆盖与家族:评估训练数据是否覆盖目标蛋白家族;对未见家族(novel family)的零样本 / 少样本表现尤为关键。
· 可解释性与证据:能否给出位点级注意力或归因,便于与实验对照。
· 工程可用性:推理速度、显存占用、是否提供置信度与不确定性。
选型对照时建议重点核对:数据规模与多样性、是否支持多序列比对(MSA)输入与长序列、是否提供置信度 / 不确定性量化、在公开评测基准上的表现,以及是否便于接入自有蛋白工程流程。
需要强调的是,再强的模型也只是“模型”。建议把评测基准与真实业务目标对齐,用小型验证集做端到端测试,而不是只看排行榜分数。
条件与工艺:多模态模型在蛋白工程中的落地流程
蛋白质多模态模型的落地是“预测—实验—迭代”的闭环:先用多模态预测生成候选,再用湿实验验证,最后把数据回馈模型进行主动学习,逐步逼近目标性质。
在蛋白工程中,多模态模型不是一次性“算命”,而是一个持续收敛的工程闭环:
5. 定义目标:明确要优化的性质,如热稳定性、活性、底物特异性。
6. 预测筛选:用多模态模型对候选序列/ 结构打分排序,挑出高回报候选。
7. 实验验证:通过高通量湿实验测量真实活性/ 稳定性,并与预测对比。
8. 数据回馈:把实验标签加入训练集,用主动学习挑选下一轮最有信息量的样本。
9. 迭代收敛:重复以上步骤,逐步逼近目标性质。
关键条件需要提前准备:
· 数据质量与标签:实验标签的准确性与通量直接决定闭环效率。
· 计算与实验成本:多模态模型推理与实验验证需要平衡预算。
· 不确定性利用:让模型“知道自己不知道”,优先验证低置信度但高潜力的样本。
· 版本与可复现:记录模型版本、数据版本与评测协议,便于长期迭代。

图3 预测—实验—主动学习的蛋白工程闭环
MatwingsVenus®(晓鹜®)如何应用蛋白质多模态模型
MatwingsVenus®(晓鹜®)把蛋白质多模态模型与蛋白工程平台相结合,在序列—结构—功能的统一表征上开展蛋白设计与改造,为酶、抗体等方向提供从预测到实验的闭环能力。
MatwingsVenus®(晓鹜®)是面向蛋白工程与生物制造的多模态蛋白智能平台。它将蛋白语言模型、结构模型与多模态融合技术嵌入设计工作流,帮助研发人员在候选生成、性质预测与筛选排序之间形成闭环,并把“预测—实验—主动学习”沉淀为可复用的流程。
在具体方向上:
· 酶工程:结合结构与功能联合建模,辅助提升活性、稳定性与底物特异性。
· 抗体/ 蛋白药物:面向亲和力成熟与可开发性评估,融合序列与结构证据。
· 蛋白设计与从头设计:在多模态表征上生成并筛选新候选。
需要说明的是,平台在具体任务上的实测表现涉及目标蛋白与实验数据,需结合场景评估;此处不做未经核实的量化承诺,相关指标请以【待核实】标注后按实际评测为准。
常见问题(FAQ)
蛋白质多模态模型与单模态蛋白AI模型有什么区别?
区别在于信息联动:多模态模型把序列、结构与功能证据联合建模,单模态模型通常只依赖一类数据,因此多模态在信息互补与跨模态迁移上更具优势。
单模态模型(如纯序列蛋白语言模型)擅长捕捉进化信号,但缺少空间与语义先验;结构模型擅长几何,但依赖结构输入。多模态让三者互相补充,尤其适合数据覆盖不足或需要同时刻画结构与功能的场景。
蛋白质多模态模型能预测哪些内容?
它能联合预测蛋白质的三维结构、功能注释、理化性质与突变效应,并在多个任务之间共享底层表征。
典型输出包括结构(TM-score / lDDT)、GO / EC 功能标签、活性与结合位点、稳定性与溶解性等性质,以及单点或多点突变对功能的影响。具体能力取决于模型的训练数据与任务设计。
多模态模型的预测结果可以直接用于实验设计吗?
不宜直接当作结论:预测应作为候选排序与优先级工具,关键结果仍需湿实验验证,并配合主动学习迭代。
预测能显著减少待测候选、提高命中率,但真实活性与稳定性只能由实验确认。建议把模型当作“高效的筛子”,与高通量实验和主动学习结合,形成可收敛的闭环。
使用蛋白质多模态模型需要哪些数据与计算条件?
需要一定规模的氨基酸序列,通常还需结构或功能注释用于对齐与训练;推理阶段依赖GPU 推理服务,训练与评测更消耗算力。
若用于自有项目,建议准备目标家族的序列集,尽量带上可用结构(PDB / 预测结构)与功能注释(GO / EC / 文献),并评估所需 GPU 资源与推理延迟。数据越规范、越对齐,多模态融合的收益越大。
总结
蛋白质多模态模型把序列、结构与功能等证据统一到同一表征空间,让AI 更完整地理解蛋白质;其价值不止于单次预测,更在于与实验闭环结合、贴近真实工程目标。
· 信息互补:多模态比单模态“看得更全”。
· 能力边界:依赖数据对齐,预测需实验验证。
· 落地闭环:预测—实验—主动学习是现实中的正确用法。
· 选型关键:任务匹配、评测基准、泛化与可解释性并重。
