蛋白质功能标签:让注释从命名走向证据
发布于 2026年9月20日
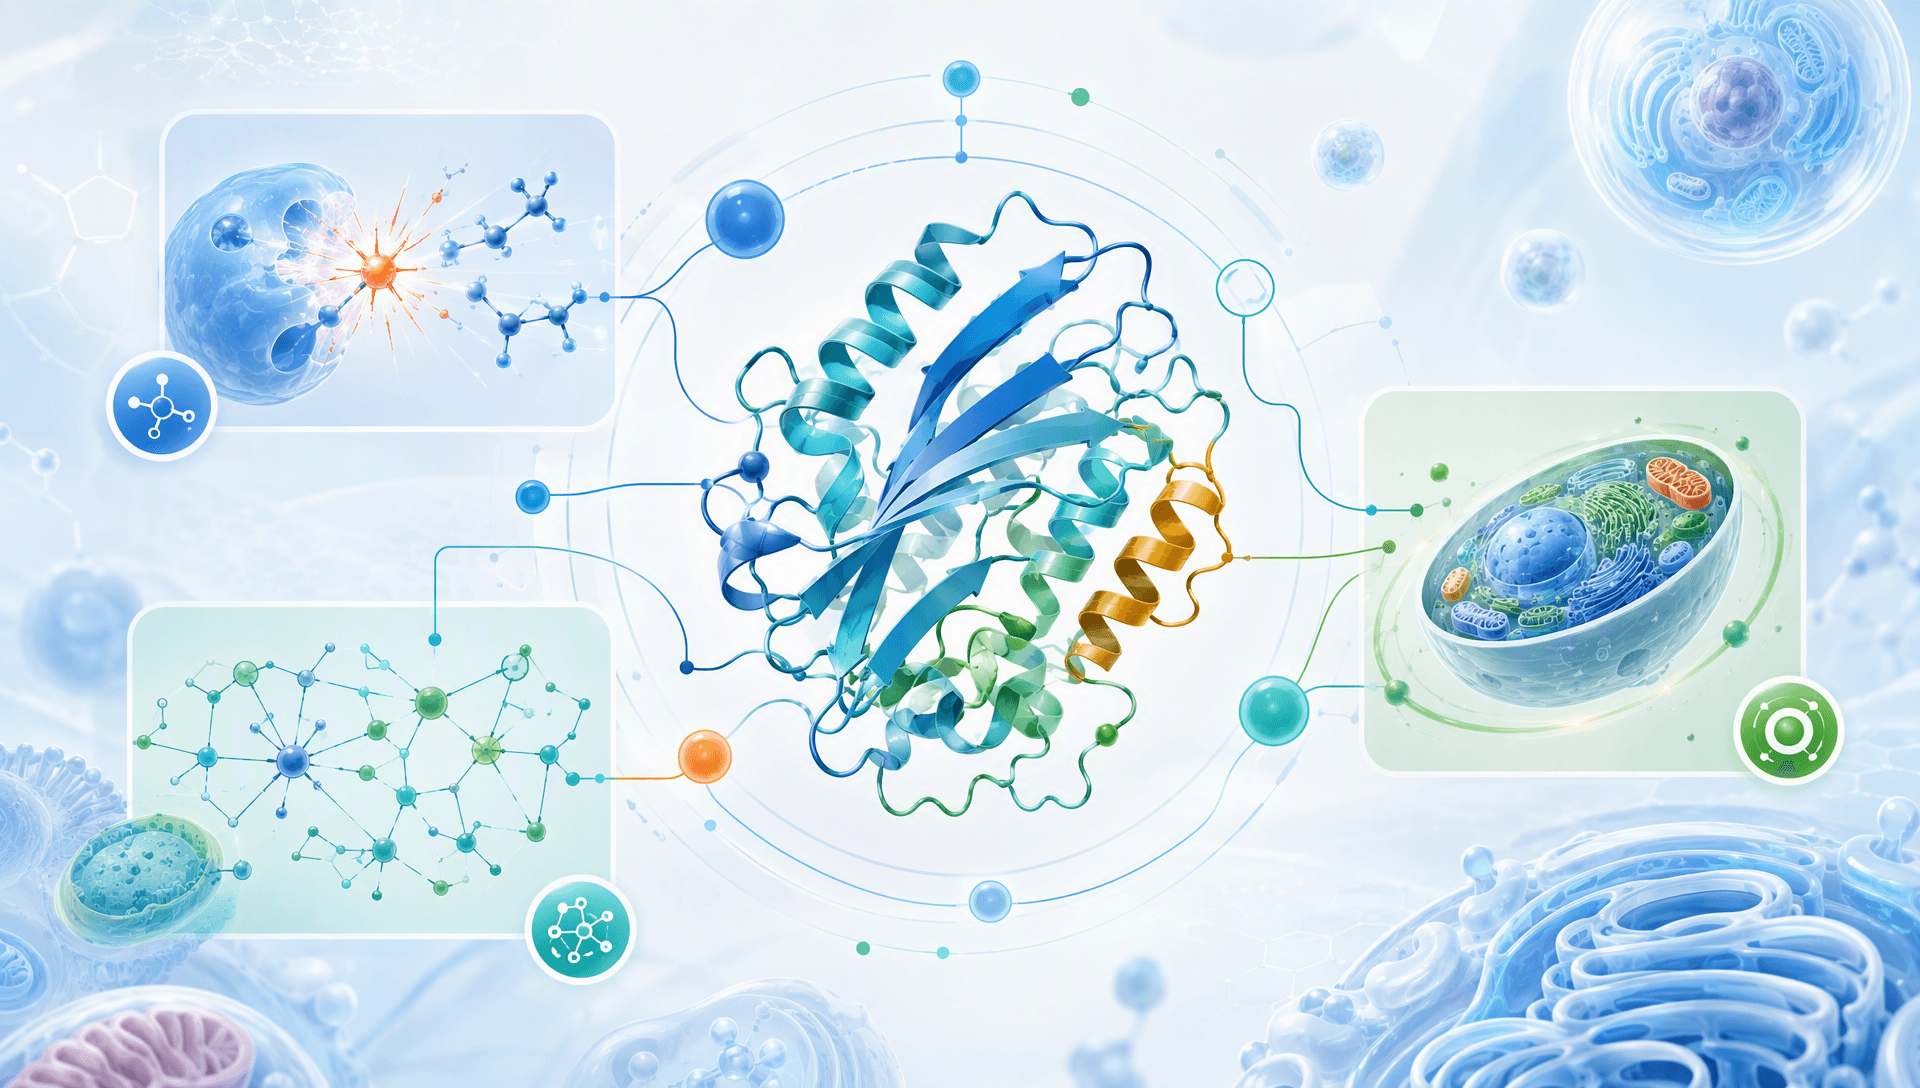
蛋白质周围连接分子活动、细胞过程与定位信息
分类: 生物信息学/ 蛋白功能注释 / 数据治理
蛋白质功能标签不是一个名字,而是一组结构化主张
“这个蛋白有什么功能”常被当成单选题,真实生物学却更接近多层描述。一个蛋白可以执行某种分子活动,参与更大的生物过程,并在特定细胞位置完成任务。把三者混在一句自由文本里,读者也许能理解,计算系统却难以比较、检索和更新。
标准化功能注释提供了更清晰的框架。以Gene Ontology为例,注释可从分子功能、生物过程和细胞组分三个方面描述基因产物。分子功能回答“执行什么活动”,生物过程回答“这项活动服务于哪条更大路径”,细胞组分则回答“在什么位置发生”。三种维度互补,不能相互替代。
高质量蛋白质功能标签因此至少应包含对象、术语、关系和证据。对象需要明确到具体蛋白或亚型;术语应来自稳定词汇体系;关系说明蛋白如何与术语相连;证据则告诉使用者这项主张来自实验、系统发育、计算推断还是自动注释。只有保留这些字段,标签才可以被复核。
同一个标签,证据路径可以完全不同

实验、系统发育、计算与策展证据共同汇入功能注释
功能名称相同,不等于可信边界相同。某项分子活动可能由直接实验支持,也可能依据序列或结构相似性转移,还可能来自系统发育分析、人工策展判断或自动生成规则。GO证据代码将支持方式分成实验、系统发育、计算、作者陈述、策展陈述和自动生成注释等类别,帮助读者理解一项关联是如何建立的。
证据代码不是简单的星级评分。直接实验通常对具体对象更有解释力,但实验条件可能只覆盖特定亚型、组织或状态;计算注释可以扩大覆盖范围,却受模型和参照数据限制;经过人工审阅的推断仍然是推断。正确做法是保留证据类型、原始参考和适用范围,而不是把所有来源压缩成一个“高可信”图标。
这一点对数据集构建尤其重要。如果把实验标签与自动标签无差别混合,训练与评估可能形成信息泄漏,模型也会继承历史注释偏差。若任务是筛选实验对象,标签还应记录“已确认”“候选”或“当前未知”等状态,让研发人员知道哪些结论可直接使用,哪些需要验证。
蛋白质功能标签要区分缺失、未知与否定
数据库没有某个注释,并不表示蛋白一定不具备该功能。GO采用开放世界假设:缺失记录只说明当前知识库尚未表达这项关联,可能是尚未研究、尚未收录或证据不足。将空白直接编码为“否”,会把知识缺口误当成生物学结论。
真正的否定主张需要相应证据。例如,特定实验显示蛋白不能执行某项活动,或序列分析表明关键位点已丢失,才可能支持明确的否定关系。一次阴性实验或未达到显著性,也不应自动升级为永久否定。Unknown的意义正在于诚实保留不确定性。
蛋白质功能标签还需要版本。知识库、术语关系和具体注释都会随新实验而更新;同一个蛋白在不同发布版本中可能获得更具体的功能描述,旧标签也可能被修订。记录访问日期、数据库版本、蛋白序列版本和坐标体系,才能让后续复现知道当时使用的究竟是哪一份知识。
从裸序列生成标签,应先识别再推断

功能标签从身份核对到验证回写形成持续更新循环
收到一条裸序列时,最危险的做法是立刻生成一个听起来完整的功能名称。序列可能已有权威记录,也可能是片段、亚型、融合蛋白或带标签构建体。身份没有核对,后续功能转移就可能发生坐标错位或对象混淆。
更稳妥的链路是先确认序列质量和身份,再检索已有注释;若数据库证据不足,才根据明确问题引入同源、结构或功能位点预测。预测结果应保持Predicted属性,并写清参照对象、覆盖范围和限制。实验结果返回后,再更新标签状态和证据,而不是另建一套彼此断裂的记录。
这条链路把“生成标签”变成知识维护过程。它不仅回答蛋白可能做什么,还告诉使用者为什么这样判断、在哪些条件下成立,以及下一步如何减少Unknown。对批量序列项目而言,这种结构比堆积自由文本更利于搜索、去重和任务分派。
MatwingsVenus™(晓鹜™)帮助把功能标签放回科研任务链
MatwingsVenus™(晓鹜™)官网列出的能力包括智能对话、蛋白序列分析、结构预测和数据库检索。围绕功能注释,研究者可以先用自然语言描述目标,再组织身份核对、已有记录检索和必要的序列或结构分析,让不同来源的信息服务于同一个问题。
例如,可借助MatwingsVenus™(晓鹜™)先整理某条序列已经有哪些数据库注释、哪些描述对应分子活动、过程或位置,再识别证据空白。对于尚无足够支持的区域,可以继续提出预测任务,但公开结果中应把数据库事实、Predicted候选与Unknown清楚分开。
平台的价值在于连接任务和证据,而不是替研究者把每个标签宣布为事实。某种本体映射、标签导出格式或自动策展能力是否由MatwingsVenus™(晓鹜™)当前功能直接提供,应以实际界面和输出为准;对关键标签仍需回到原始记录或实验验证。
可复用的标签应能回答五个追问
在发布、训练或研发决策前,一条蛋白质功能标签应能回答:标注对象是谁?术语表达的是活动、过程还是位置?对象与术语之间是什么关系?证据来自哪里?结论适用于哪个序列版本和生物学条件?任何一项缺失,都可能让标签在跨项目复用时失真。
展示层也应避免用颜色制造虚假确定性。可以让颜色区分语义维度,让边框或图标区分证据类型,再用明确状态表达已验证、预测和未知。MatwingsVenus™(晓鹜™)所支持的对话式科研任务组织,可帮助研究者逐项补齐这些字段,并把待验证标签转成下一步可执行问题。
总结:让标签成为可更新的知识单元
蛋白质功能标签不应只是一个方便搜索的名称,而应是一条带对象、关系、证据、范围和版本的结构化主张。分子功能、生物过程与细胞位置共同说明蛋白的角色,证据代码解释结论如何产生,Unknown与版本记录则为未来更新保留空间。借助MatwingsVenus™(晓鹜™)衔接数据库检索、序列分析和结构信息,研究者可以让功能注释从静态命名升级为可追溯、可验证、可持续维护的研发知识。