
蛋白质基座大模型是什么?它如何助力蛋白质研发?
发布于 2026年11月3日
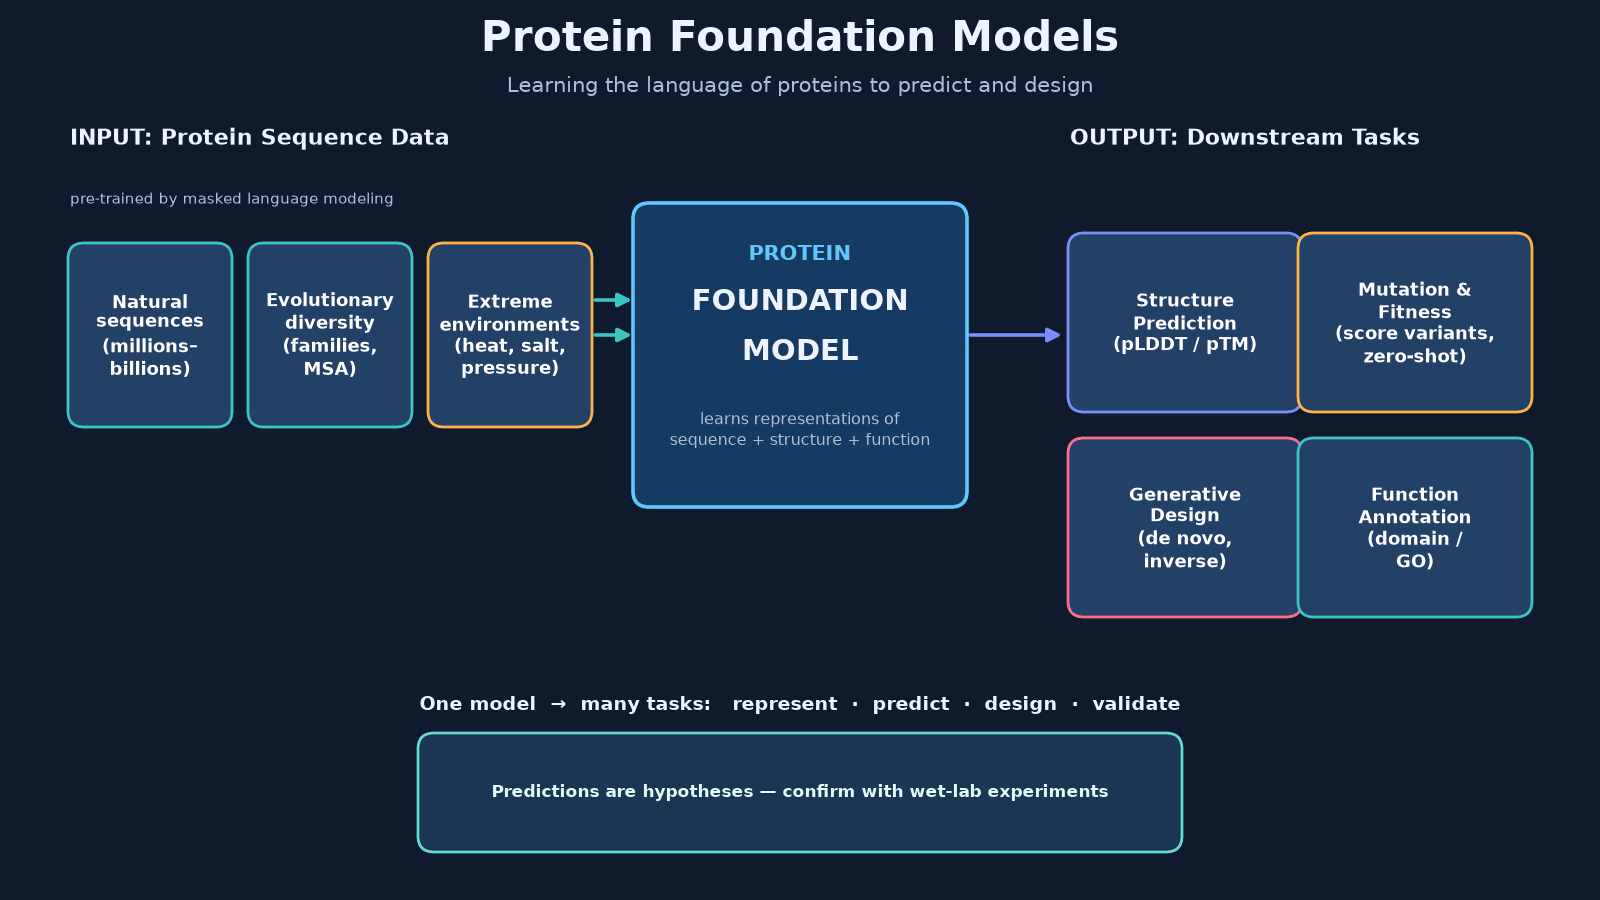
图1 蛋白质基座大模型概念全景
蛋白质是生命活动的执行者,而"氨基酸序列如何决定折叠与功能"这一规律极为复杂。蛋白质基座大模型(Protein Foundation Model)用海量蛋白质数据训练出通用"底座"AI,让结构预测、突变评估和全新蛋白质设计可以在同一个模型上完成。它把过去依赖专家经验、靠人工大量试错的研发方式,转变成"AI 提出假设、实验验证假设"的工程化范式。
背景:为什么蛋白质需要"大模型"
蛋白质基座大模型之所以出现,是因为序列与功能之间的规律太复杂,传统方法难以全面捕捉,而AI 能从海量数据中把它"读"出来。 蛋白质由20 种氨基酸按顺序拼成,折叠成三维结构后发挥催化、结合、运输等作用。过去,科学家要么逐一在实验室测定结构与功能,要么借助多序列比对(MSA)、分子动力学等计算手段,周期长、成本高。2018—2021 年,AlphaFold、ESM 等证明 AI 能从序列中学到结构规律;基座大模型进一步把这一思路"规模化",形成可与通用大语言模型类比的技术路线。
如今公共数据库中的蛋白质序列已达上亿至数十亿条,而带有实验标签的数据却相对稀缺。这恰好契合自监督学习:不需要标注,模型就能从序列本身"自我学习"。更关键的是,一次预训练得到的是通用表征,可迁移到结构预测、突变打分、功能注释等众多任务,省去为每个任务重复训练模型的开销——这正是"基座(foundation)"的含义。与处理文字的通用大模型不同,蛋白质基座大模型的"语言"是氨基酸序列这一"生命语言",其 token 是氨基酸或结构片段。
原理:蛋白质基座大模型如何工作
蛋白质基座大模型通过"掩码语言建模"在大量序列上自监督预训练,让模型学会填补缺失的氨基酸,从而获得关于演化与结构的隐式表征,再微调或零样本用于各类下游任务。
• 掩码学习:类似"完形填空"。把一条蛋白质序列中的部分氨基酸遮挡,让模型根据上下文预测。训练数据越多,模型学到的"蛋白质语法"越准确。
• 表征即知识:预训练得到的表征向量(embedding)隐式编码了演化与结构信息,不同"下游头"挂在这个底座上,就能完成不同任务。
• 三大下游能力:
• 结构预测:ESMFold 等直接由单条序列预测原子级 3D 结构,无需 MSA,速度比传统方法最高可快约 60 倍。
• 突变/适应度预测:用log[P(突变体) / P(野生型)] 近似突变效应,可零样本对候选变体排序。
• 生成式设计:ProteinMPNN 做"逆折叠"(由结构生成序列),RFdiffusion 生成全新骨架,再经结构预测模型过滤验证。
• 多模态趋势:ESM-3、AlphaFold 3 等把序列、结构、功能乃至配体作为统一输入,让模型"同时思考"多种模态。
通俗地说,预训练像让模型"读遍"蛋白质世界里的"书",积累关于折叠与演化的常识;下游任务像"考试",只需在底座上稍加微调(或零样本直接使用)就能作答。与传统依赖高质量同源序列(MSA)或昂贵物理解算的方法相比,基座大模型不依赖同源信息、无需物理模拟,对缺乏同源序列的新蛋白尤其有价值——但代价是这类模型更"黑箱",需要置信度分数与实验来兜底。

图2 基座大模型关键机制
能力与边界:它能预测什么,不能代替什么
蛋白质基座大模型擅长结构预测、突变排序与生成设计,能显著缩小搜索空间,但它是"待验证的假设",不能替代湿实验,对柔性区域、动态构象与远端突变也存在盲区。
• 强项:一模型多任务。结构预测达到接近实验的精度;零样本突变打分与深度突变扫描(DMS)呈相关(相关系数约 0.4–0.5),适合排序与初筛;生成式设计能探索广阔的序列空间。
• 置信度工具:pLDDT、pTM 等置信度分数用于标示哪些区域更可靠。
• 边界:
• 静态单构象:多数模型给出单个静态结构,难以捕捉柔性、构象变化与动态过程。
• 语境依赖:仅靠序列的语言模型可能忽略生化与远端突变效应;针对性微调或监督模型,在特定任务上常能超过更大的零样本模型。
• 数据风险:训练集可能存在数据泄漏,标准基准(如ProteinGym)的结果需谨慎解读。
在生成式设计一侧,基座大模型已显现出"创造"能力:例如 ESM-3 生成了明亮的稳定荧光蛋白 esmGFP;而"设计骨架—设计序列—结构验证"的流水线(RFdiffusion → ProteinMPNN → AlphaFold/Boltz)已成为从头蛋白工程的标准做法。需要提醒的是,模型的泛化往往在与训练分布相近的蛋白家族内更好,面对全新折叠或高度突变的序列,预测可靠性会下降。因此,业界用 ProteinGym 等基准在多套深度突变扫描数据上做统一评估,并反复强调必须用湿实验复核。
• 结论:把这些预测当作"实验起点",用干湿闭环去验证。
应用:从预测走向设计,蛋白质大模型如何落地
蛋白质基座大模型不是纸上谈兵,它与定向进化、自动化实验结合,构成"设计—构建—测试—学习"的干湿闭环,把大量试错交给 AI,把验证交给实验。
• 干湿闭环:AI 设计候选序列 → 构建表达 → 自动化实验室测试 → 实验数据回流 → 主动学习更新模型,逐轮缩小搜索空间。
• 应用场景:酶的热稳定性/耐盐等性质优化、抗体与结合蛋白设计、新酶挖掘(尤其从深海、火山等极端环境序列中挖酶)、从头设计功能蛋白。
• 价值:把"试错"前置到计算阶段,减少实验样本量、缩短迭代周期。
在实际项目中,常见做法是先由模型对数千至数万个候选变体打分排序,挑选一小批进入实验;实验结果返回后再用主动学习挑选"最有信息量"的新变体,把有限的实验预算花在刀刃上。这样,实验室不再是无目标地海量试错,而是"带着问题"去验证,从而在创新药、合成生物学、食品营养、绿色化工等领域加速酶的改造与功能蛋白的开发。

图3 AI 干湿闭环驱动蛋白工程
MatwingsVenus®(晓鹜®):以蛋白质基座大模型为核心的研发范式
天鹜科技(Matwings Technology)以自主研发的蛋白质设计通用大模型为核心引擎,深度融合 AI 生物设计智能体与自动化实验平台,打造"从 AI 设计到 AI 验证"的蛋白质全流程研发范式。
• 底座:MatwingsVenus® 蛋白质设计通用大模型,依托百亿级蛋白质序列数据预训练,具备AI 定向进化、AI 挖酶与 De novo 等核心能力。
• 数据:MatwingsVenus® Pod 汇聚多源、含数十亿标签的蛋白质序列数据,覆盖深海、火山等极端环境(耐高温、耐强压、耐强酸/碱)序列,为模型提供样本多样性。
• 智能体:MatwingsVenus® Agent 通过自然语言交互完成蛋白序列分析、定向突变设计、酶挖掘、结构预测与数据库检索。
• 自动实验:MatwingsVenus® Auto 融合生成式 AI、具身机器人与智能仪器集群,实现从序列设计、表达纯化到功能表征的智能决策与执行。
• 干湿闭环:模型设计—自动实验—数据回流逐轮迭代。天鹜科技采用多智能体协同架构,可按自然语言指令自动拆解任务、规划实验流程,并依据实验反馈动态调整参数,形成"模型设计—自动实验—数据回流"的干湿闭环。据披露,可将研发周期从传统的 2–5 年压缩至 2–6 个月,单项目实验量从上万次降至约百次量级,研发成功率由约 5% 提升至约 30%(以上为官方口径,实际结果因项目而异)。
• 落地案例(公司披露):6 个月内完成高效塑料降解酶设计;AI 设计的酶法乳果糖项目已进入中试阶段。
常见问题(FAQ)
蛋白质基座大模型和AlphaFold 是一回事吗?
不是。AlphaFold 是专注"结构预测"的模型,蛋白质基座大模型是更通用的"底座",结构预测只是它众多能力之一。 AlphaFold 2/3 把蛋白质结构预测推到了接近实验精度,AlphaFold 3 进一步覆盖蛋白质—配体、蛋白质—核酸相互作用;而 ESM、ESM-3、ProGen 等基座大模型在结构预测之外,还承担突变效应评估、生成式设计、功能注释等任务,并可微调迁移。
我可以直接用蛋白质大模型预测突变效应吗?
可以,但要把它当作"排序工具"而非"精确测量"。 零样本突变打分用log[P(突变体)/P(野生型)] 近似效应,与深度突变扫描数据呈中等相关(约 0.4–0.5),适合优先筛选候选变体;若要精确量化,仍需结合实验或针对特定蛋白的监督/微调模型。
蛋白质基座大模型能替代湿实验吗?
不能。模型输出的是"需要验证的假设",湿实验仍是最终裁决。 模型在柔性区域、动态构象与远端突变上存在盲区,且训练数据可能存在泄漏,因此业界普遍采用"模型设计—自动实验—数据回流"的干湿闭环,让 AI 缩小搜索空间、实验确认结果。
学习使用蛋白质大模型需要懂编程或建模吗?
现代平台通常不需要。 以MatwingsVenus®(晓鹜®)为例,用户可直接用自然语言提出研发需求,由 Agent 自动拆解任务、调度设计、预测、分析与筛选能力,并衔接自动化实验。
总结
蛋白质基座大模型把"蛋白质的语言"教给了 AI,让结构预测、突变评估与生成式设计在同一个底座上完成,正推动蛋白质研发从"经验+试错"走向"AI 假设+实验验证"的工程化范式。它并非万能:预测需要置信度与湿实验护航,对静态构象、远端突变等仍有局限。真正可落地的路径,是把基座大模型与定向进化、自动化实验组成干湿闭环,用数据闭环持续迭代模型,从而更快、更省地把候选蛋白变成可用产品。
