
蛋白质智能体如何打通「设计—验证—迭代」的研发闭环?
发布于 2026年11月10日
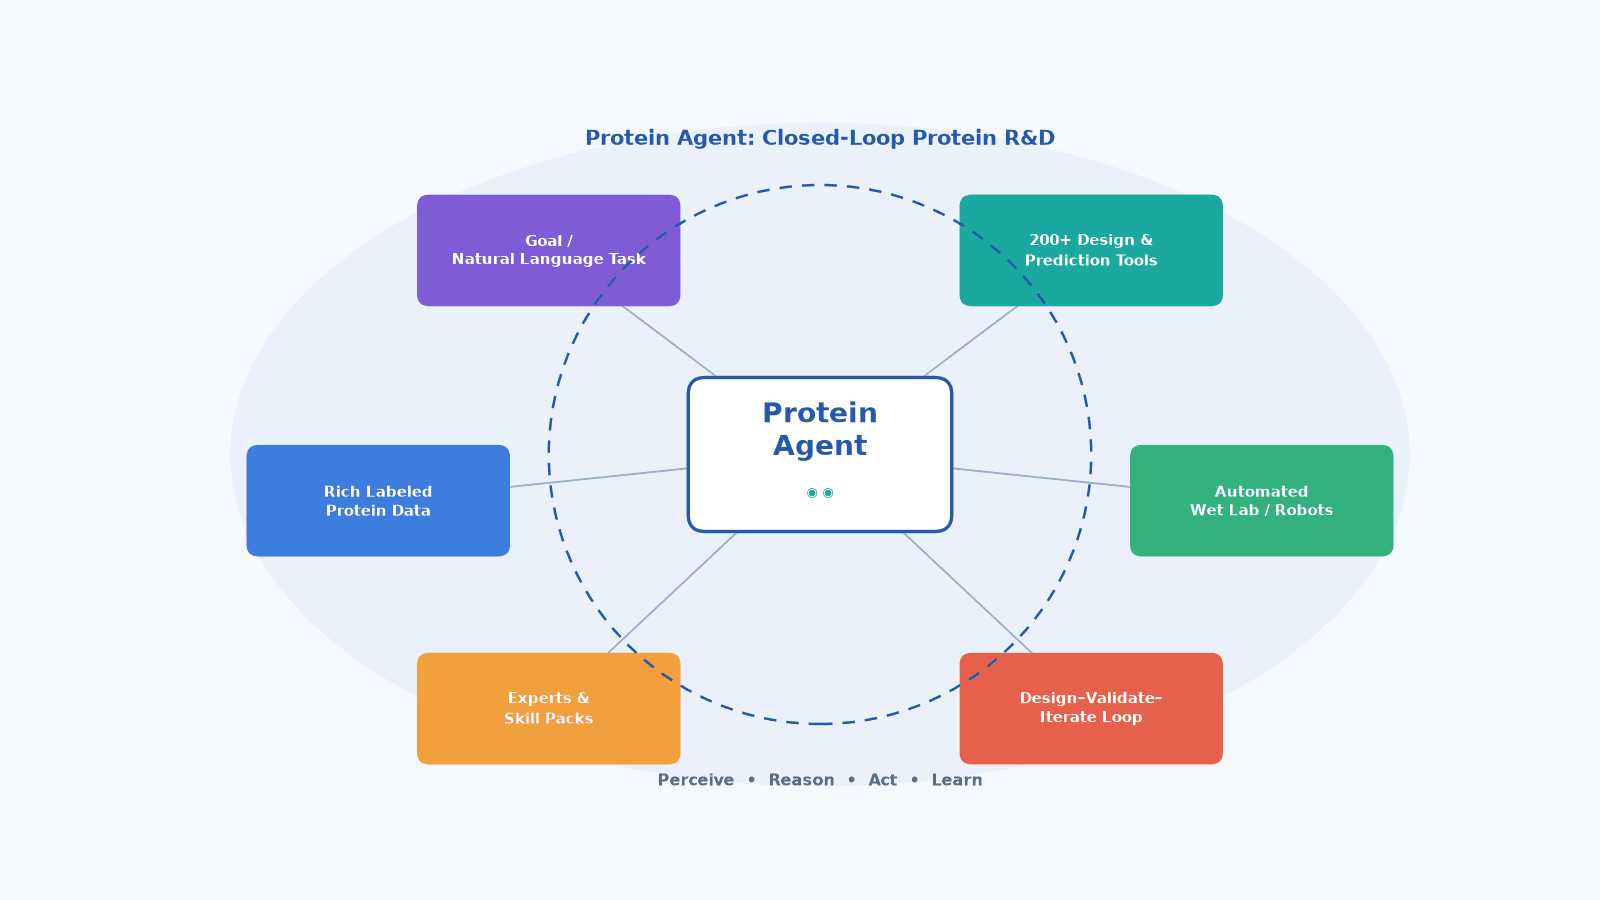
图1 蛋白质智能体:一站式研发中枢,串联数据实验
蛋白质是医药、食品与材料等领域最重要的生命元件之一。想用人工智能去设计或改造一个「更好用的蛋白质」,过去往往要依赖专家经验与人工大量试错——从成千上万种候选变体里挑出「对的那一个」。如今,一种全新的角色正在登场:蛋白质智能体。它的价值,是把「想方案」和「做验证」串成一个能自动迭代的闭环:智能体负责设计和推算,自动化实验负责验证,结果再回流给智能体,让它下一轮「想得更准」。
蛋白质研发为什么需要「智能体」?
传统蛋白质研发依赖专家经验与海量人工试错,设计靠直觉、实验靠筛选,反馈慢、迭代难,研发周期常以年计,这正是引入蛋白质智能体的根本动因。
蛋白质设计的历史可以追溯到1978 年定点突变技术问世,从此从「探索性研究」走向「精准工程设计」。方法越来越多样,但也带来新的现实痛点。
· 三大痛点:筛选效率低、专业知识要求高、预测准确性不足。
· 更深层的问题:设计、预测、实验这些能力散落在不同工具里,缺一个能「自动组织工作路径」的中枢。
· 所谓智能体(Agent),就是能自主感知环境、围绕目标做决策并调用工具的系统;放到蛋白质研发里,它自动串起数据、工具与实验。
· 智能体恰好补上这一环:以任务目标为中心,自动拆解、调度、衔接上下游,把「设计—验证—迭代」串成一条自动运转的流水线。
蛋白质智能体是什么?它如何工作?
蛋白质智能体是一类以自然语言任务为目标、能自动感知蛋白质数据、拆解目标、调用设计/预测/筛选工具并衔接实验执行的 AI 系统,核心是「感知—推理—工具调用—反馈学习」四步闭环。
通俗地说,它像一个「会思考、会调用工具、还会安排实验」的数字研究助手:你只用一句话描述目标,它自己拆分步骤、选择工具、逐步推进,还能指挥自动化实验去验证。
· 第一步,感知:读取蛋白质的序列、结构、功能与标签数据。数据越丰富、越真实,设计越有依据,例如带真实标签的大规模蛋白序列库。
· 第二步,推理:把一句目标拆成可执行的子任务,比如「挖酶」「定向进化」「从头设计」。
· 第三步,工具调用:调度设计、预测、分析、筛选等几十上百种能力,替代人工逐个调用软件。
· 第四步,反馈学习:把实验结论回流给模型,通过主动学习(active learning)不断收窄搜索空间,让下一轮设计更接近目标。
· 关键支撑:云端计算设计与物理实验室的深度协同,让「算」与「做」真正接上,实现「设计即验证、验证即迭代」。

图2 核心机制:感知→推理→行动→学习的干湿闭环
怎么判断与选择蛋白质智能体的能力?
评估蛋白质智能体,关键看数据底座、能力覆盖、闭环兑现与可量化收益四个维度,以及它能否清晰说明自己的能力边界。
· 数据底座:是否拥有大规模、带真实标签的蛋白数据,这直接决定设计的置信度。
· 能力覆盖:能否调度足够多的设计、预测、分析与筛选工具,决定它能否处理多种任务。
· 闭环兑现:设计结果能否自动衔接到真实实验并回流反馈,这是「真闭环」与「假演示」的分水岭。
· 可量化收益:研发周期、所需实验量、成功率是否显著改善。
· 能力边界:哪些可预测、哪些必须实验验证。预测是假设,实验才是证据,二者不能混为一谈。
· 选型建议:按场景匹配——深度研究、挖酶、定向进化、从头设计,各自需要的工具与专家组合不同。
蛋白质智能体怎么落地使用?
落地路径是:用自然语言描述目标,智能体拆解任务并完成设计,自动化实验接着完成样品制备、蛋白纯化与功能检测,结果回流再设计,逐轮收窄搜索空间。
· 入口很简单:自然语言对话,一般不需要编程。
· 完整流程(见图3):目标 → 任务拆解 → 序列设计 → 自动化实验(制备、纯化、检测)→ 数据回流 → 再设计。
· 自动化实验是关键一环:由机器人与智能仪器完成样品制备、蛋白纯化、功能检测,替代大量重复的人工操作。
· 迭代不是一次性的:每轮实验数据都进入下一轮设计,逐轮缩小搜索空间、逐步优化候选集合。
· 平台还支持专家在线协同,为设计方案提供权威见解,形成「人机协同」。
· 带来的价值:把研发周期从2–5 年压缩到约 2–6 个月,单项目实验量从数万级降到约百级。

图3 从目标到优化候选,实验数据回流再设计
MatwingsVenus®(晓鹜®)如何实现「对话式干湿闭环」?
MatwingsVenus®(晓鹜®)是以智能体为中心的蛋白质一站式研发平台,把 AI 设计、自动化湿实验与专家协同连成可执行、可反馈、可迭代的闭环。
· 定位:对话式蛋白质研发智能体。用户用自然语言提出功能需求,AI 完成序列设计,随后自动衔接自动化实验室。
· 组成四大板块:MatwingsVenus™ 大模型(蛋白质设计通用大模型)、MatwingsVenus™ Agent(对话智能体)、MatwingsVenus™ Auto(全自动化实验设备)、MatwingsVenus™ Pod(多源序列数据)。
· 数据底座:支持百亿级真实标签蛋白序列检索,覆盖深海、火山等极端环境的耐高温、耐强压、耐强酸碱序列。
· 能力整合:200+ 蛋白质设计工具、50+ 平台认证专家、30+ 各领域专家调优的 skills。
· 工作方式:自然语言输入→ 自动拆解任务 → 调度设计/预测/分析/筛选 → 完成深度研究、挖酶、定向进化、从头设计以及自动化湿实验协同。
· 研发模式:「设计即验证、验证即迭代」。
· 实践案例:免疫调控受体靶点从头设计,获得多个具体外细胞阻断活性的全新结合分子;甜度蛋白多轮优化,多个样本甜度较野生型提高十几倍、耐热性约75℃。
FAQ
蛋白质智能体和传统蛋白质设计软件有什么区别?
传统软件把功能「堆」在一起,需要人工逐个调用;智能体则以任务目标为中心,自动组织工作路径、调度所需工具,并把结果直接衔接到自动化实验,形成可迭代的闭环。
蛋白质智能体真的「会做实验」吗?
通常不是智能体亲手做,而是通过自动化共享实验室:把设计结果导入质粒订购与实验编排流程,驱动机器人完成样品制备、蛋白纯化与功能检测,再把数据回流给AI 做下一轮设计。
用蛋白质智能体需要会编程或懂机器学习吗?
一般不需要。用自然语言描述目标即可,任务拆解、能力调度与反馈都由平台完成。不过,理解它的能力边界——哪些靠预测、哪些必须实验验证——仍然很重要。
蛋白质智能体目前能解决什么问题?有什么局限?
它已在挖酶、定向进化、从头设计等场景落地,并在真实项目里打通「设计—实验—迭代」全流程;局限在于预测仍需实验确证,且受数据与算力约束,属于能力边界,不能替代实验证据。
总结
蛋白质智能体的价值,不是替代科学家,而是把「算、做、验、改」连成一条可自动迭代的流水线,让研发更快、更省、更可复现。
· 以目标为中心自动组织工作路径,减少人工试错。
· 云端设计与物理实验深度协同,形成真正落地的干湿闭环。
· 能力边界清晰:预测负责提出假设,实验负责确证。
· 对团队而言,意味着更短的周期、更少的实验量与可沉淀的数据资产。
一句话结论:蛋白质智能体把计算设计与自动化实验连成闭环,让蛋白质研发从「凭经验试错」转向「可对话、可迭代」。
