蛋白质序列预测酶功能的核心判断逻辑
发布于 2026年9月16日
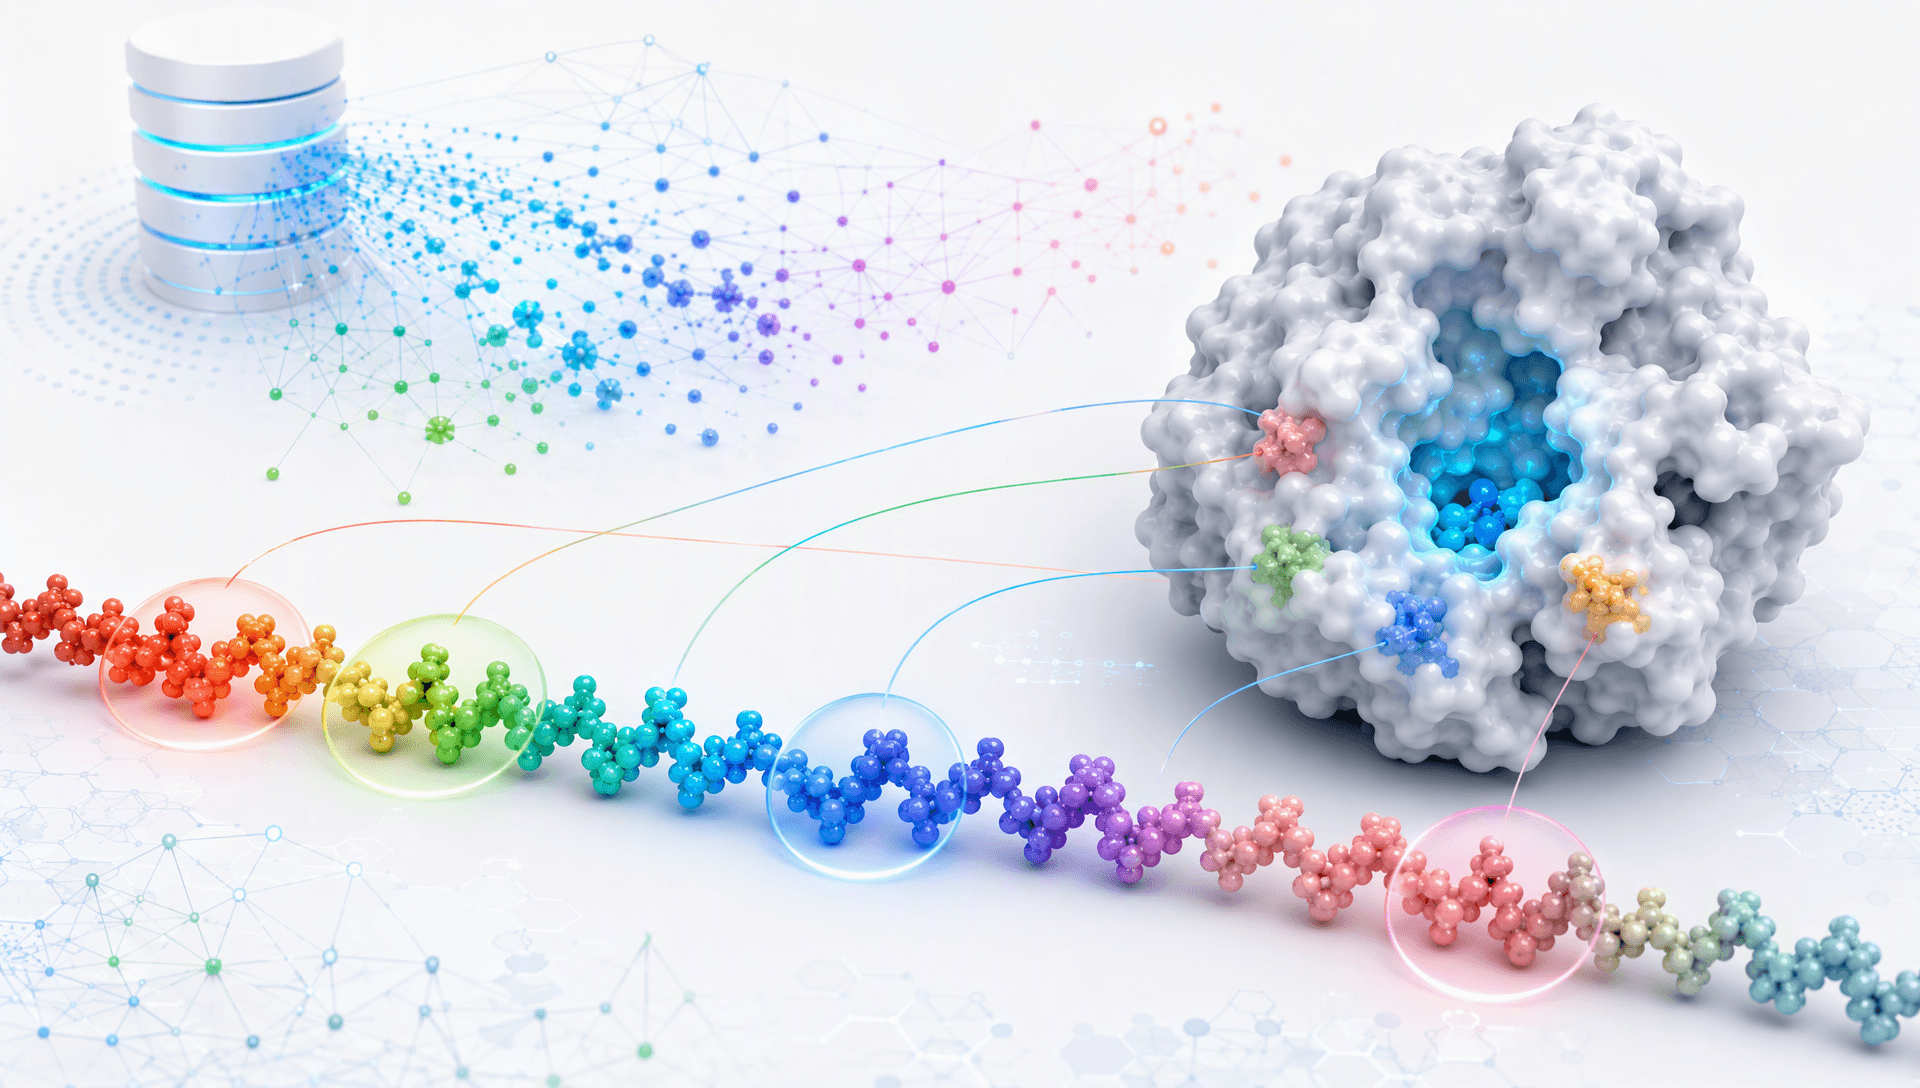
蛋白质序列中的保守基序指向潜在酶活性口袋
分类: 酶工程/ 计算生物学 / 合成生物学
在酶挖掘项目中,真正让团队停下来的往往不是序列数量不够,而是候选太多。宏基因组、菌株测序或定向进化可以快速产生数千条蛋白质序列,但项目最终需要回答的是:哪条序列可能催化目标反应,偏好什么底物,在什么温度和pH下工作,又该优先验证哪几个候选?
这使蛋白质序列预测酶功能从“注释任务”变成了“资源分配任务”。预测若只输出一个宽泛酶类别,对底物选择、反应条件和实验排期帮助有限;预测若把置信边界说得过满,又可能把研发资源推向错误方向。更有效的做法,是把酶功能拆成多个可以独立取证的问题。
蛋白质序列预测酶功能其实包含五层问题
第一层是它是否可能是酶。这一层关注蛋白家族、保守基序、结构域组合及是否存在合理的催化残基环境。第二层是它可能催化哪类反应,通常需要连接同源注释、反应数据库和酶分类信息。第三层进一步追问底物或辅因子偏好,这往往比判断酶大类更困难,因为同一家族成员可能因少数口袋残基不同而具有不同底物谱。
第四层是反应条件,包括最适温度、最适pH、金属离子依赖,以及蛋白自身的稳定性和溶解度。第五层是动力学表现,例如在明确底物与条件下的周转能力。层级越靠后,序列单独提供的约束通常越弱,对结构上下文、训练数据适用范围和实验条件的依赖越强。
因此,蛋白质序列预测酶功能不应被压缩成一个真假判断。数据库中的EC号、GO注释和功能概述应优先检索,而不能被包装成模型“直接预测”的确定事实;活性位点、结合位点、保守残基或kcat等计算结果,则应清楚标为Predicted,并与具体任务条件绑定。
序列能提供三类信号,但每类信号回答的问题不同
家族相似性给出最可靠的起点
当序列与已有实验注释的酶高度相似,且比对覆盖催化核心与关键辅助区域时,同源关系可以快速缩小功能范围。但“相似”并不自动意味着底物相同。只看全长一致性,可能忽略决定口袋大小、电荷或辅因子选择的少数关键残基;只看局部命中,又可能误判完整蛋白的功能背景。
保守基序提示催化可能性
序列基序是蛋白家族的重要特征,催化残基在许多酶家族中具有可识别的排列模式。基序的价值在于提出“这里可能承担什么化学角色”的假设,而不是单独证明活性。一个基序是否可信,还要看它在三维空间中能否形成合理的催化几何、周围残基是否支持底物结合,以及整体折叠是否完整。
局部差异决定底物与性质分化
同一酶家族中的成员可能共享催化机制,却在入口通道、第一壳层残基或柔性区域上存在差异。这些差异会影响底物谱、选择性和环境适应性。高质量分析应在家族共性之外,专门标出候选的差异位点,并说明它们是已知实验规律、同源推断还是模型预测。

催化口袋中的底物与关键残基共同定义反应可能性
从“像某种酶”到“值得做实验”需要置信度分层
面对一条未知序列,可以把结论整理成三层证据。Measured表示数据库或文献中已有实验测量;Predicted表示由同源关系、序列模型、结构模型或属性模型推断;Unknown则保留尚无可靠信息的部分。这样的分层能防止一个强证据覆盖所有弱问题。
例如,某候选可能有可靠的家族归属,但底物偏好仍不确定;活性位点位置可能得到多个方法支持,但最适温度和kcat仍只是计算估计。项目团队据此可以设计不同的验证优先级:先用小型底物面板确认反应类型,再测温度和pH窗口,最后在统一条件下比较动力学,而不是一次性对所有候选做完整表征。
一份可直接进入研发会议的结果,至少应包含:候选身份、可能反应类别、关键催化残基、潜在底物或辅因子、环境属性、每项结论的证据等级,以及最小验证实验。它不是一张排名表,而是一组能够被实验否证或确认的假设。
MatwingsVenus™(晓鹜™)把功能问题拆成证据卡片
MatwingsVenus™(晓鹜™)的价值并不是用一个模型替代所有数据库和实验,而是先判断问题属于检索还是预测。面对裸序列,系统遵循“序列先识别”:先确认身份和同源背景,再检索已有注释与实测数据;只有证据仍有空白、且用户确认后,才进入计算预测。
围绕蛋白质序列预测酶功能,MatwingsVenus™(晓鹜™)可把不同粒度的能力组织在同一任务中。VenusX面向活性位点、结合位点和进化保守位点等残基级问题;VenusG面向稳定性、溶解度、最适温度、最适pH、金属离子结合和kcat等蛋白级属性;理化性质计算则补充分子量、pI等基础信息。EC号、GO注释和功能概述仍通过权威数据库检索获得,避免混淆“已有记录”和“模型推断”。
这种编排方式让每项输出都带着来源与状态进入下一步。研究者可以看到哪些结论是Measured,哪些是Predicted,哪些保持Unknown;对重计算任务,MatwingsVenus™(晓鹜™)保留用户确认点,便于在运行前核对序列、目标属性和预期输出。这种透明度尤其适合多人协作的酶筛选项目。

微流控芯片与酶活检测设备验证功能预测结果
让预测结果直接服务于候选筛选和实验设计
蛋白质序列预测酶功能的最终交付,不应止于“候选A得分最高”。更有价值的输出是将候选按研发问题分组:哪些适合验证目标反应,哪些可能具有不同底物谱,哪些在目标温度或pH下更值得优先测试,哪些因关键残基缺失而应暂缓。
对于低同源、新颖序列或多结构域蛋白,应主动扩大不确定性范围。模型一致可以提高候选优先级,却不能改写成实验结论;预测的kcat也必须放在底物、温度、pH等条件中理解。验证实验不只是最后的质量检查,而是用于更新功能假设、校正筛选标准和指导下一轮候选选择的数据入口。
蛋白质序列预测酶功能要走向可验证假设
蛋白质序列预测酶功能真正解决的是“下一步做什么”。先用身份和数据库证据建立基线,再分别判断酶类别、催化位点、底物环境、反应条件与动力学属性,最后用证据分级和最小实验关闭关键不确定性,才能把海量序列压缩成可执行的候选组合。
MatwingsVenus™(晓鹜™)通过检索优先、分层预测、用户确认和证据标记,把分散的分析环节连接为可追溯的研究过程。对需要在有限实验资源下提高候选选择质量的团队而言,这种“先形成可证伪假设,再安排验证”的方式,比追求一个看似完整却无法解释的单一答案更可靠。