
MAFFT多序列比对:快速傅里叶变换如何让同源序列对齐又快又准
发布于 2026年11月9日
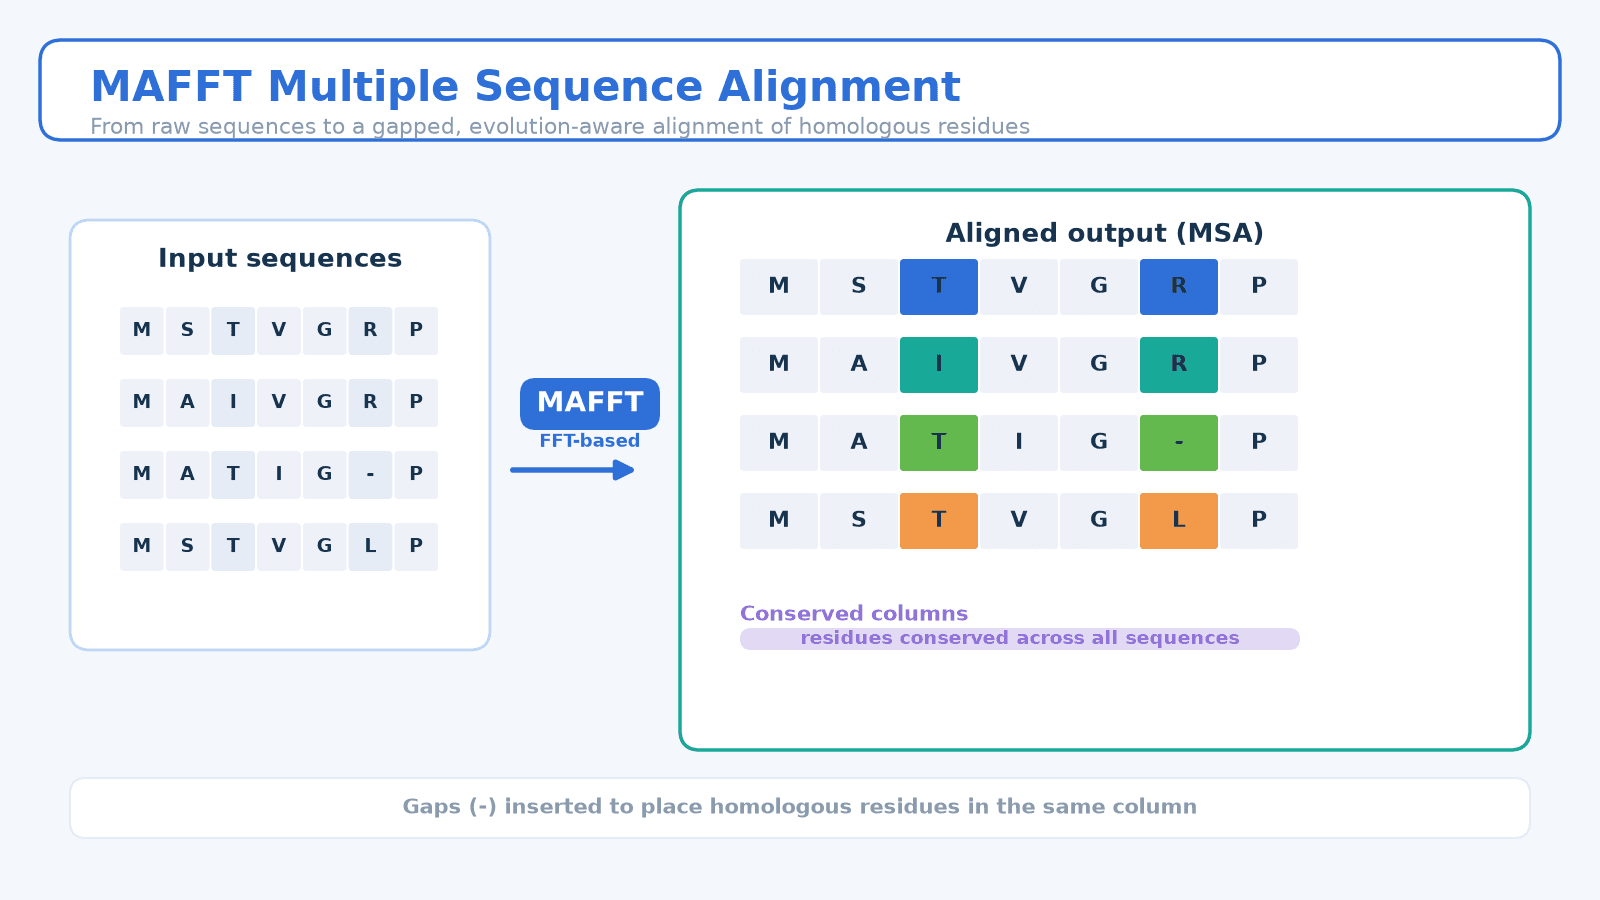
图1 多序列比对:插入空位对齐同源残基
MAFFT多序列比对:快速傅里叶变换如何让同源序列对齐又快又准
多序列比对(Multiple Sequence Alignment, MSA)是生物信息学的基石操作之一:它把多条同源序列按列对齐,让进化上对应的残基落在同一列,从而揭示保守位点、功能关键残基和进化关系。MAFFT(Multiple Alignment using Fast Fourier Transform,基于快速傅里叶变换的多序列比对)是其中最常用的工具之一,由大阪大学 Katoh 等人于 2002 年提出,至今仍是速度与准确度兼顾的默认之选。
一、背景:为什么需要多序列比对
多序列比对把两条以上的同源序列放在一起,通过插入空位使进化上同源的位点纵向对齐,是解读序列功能与进化信息的第一步。其核心目标是在“对齐质量”与“计算成本”之间取得平衡。
没有多序列比对,单条序列只是“一串字母”;而一旦把几十上百条同源序列列在一起,序列中哪些位置重要、哪些位置可变,就会在纵向比较中显现出来。这也是它成为系统发育分析、功能注释和蛋白设计前置步骤的根本原因。
· 揭示保守位点:跨物种或跨同源物都高度保守的残基,往往承担关键结构或催化功能,是设计时最不该动的位置。
· 识别共进化信号:比对后能计算残基间的相关性,为结构与相互作用预测提供依据。
· 构建系统发育树:对齐的列位点是进化距离与树重建的基础。
· 服务于同源建模:高质量比对是把已知结构映射到目标序列、搭建三维模型的前提。
不过,多序列对齐本质上是一个“NP 难”的组合优化问题:序列一多,寻找全局最优对齐几乎不可行。因此所有实用工具都在走“近似启发式”路线——把问题分解成若干步,用贪心或迭代策略逼近高质量解。理解这一点,就理解了为什么工具之间存在“速度—准确度”的取舍。
二、MAFFT 的原理:FFT 与渐进式比对
MAFFT 用快速傅里叶变换(FFT)在频域中快速定位同源区,再用渐进式比对与迭代精化完成整段对齐,从而把复杂度从 O(N²) 降到近 O(N log N)。
具体做法是:把每条氨基酸序列编码成两种数值谱——体积谱(volume)与极性谱(polarity)。两条序列做互相关时,峰值就指示出“同源片段”大致落在哪里。利用傅里叶变换的卷积定理,这种互相关可以在频域快速算出,从而在几乎线性时间内为整条序列找到候选同源区,而非逐一枚举所有偏移。

图2 FFT 同源检测与五步比对流水线
MAFFT 的整体流程可用五步概括:
1. 两两比对(Pairwise alignment):用FFT 把每条序列编码成体积与极性两种数值谱,通过互相关快速定位可能的同源片段。
2. 距离计算(Distance matrix):基于两两相似度得到序列间距离。
3. 引导树构建(Guide tree):把距离聚成树,决定比对顺序。
4. 渐进式比对(Progressive alignment):按树从亲缘最近的序列开始,逐对合并进已有比对。
5. 迭代精化(Iterative refinement):重复重排比对,优化整体得分,减少“一旦错位就固化”的渐进式固有缺陷。
这里的关键在于:FFT 负责“哪里同源”,渐进式与迭代精化负责“怎么对齐”。 前者保证速度,后者保证准确度,二者结合正是MAFFT “快而准”的来源。渐进式方法速度快,但有个天然弱点——早期合并进来的错位会被“锁死”并一路带下去;迭代精化就是在后期反复调整空位与列位,尽量把这种累积误差纠正回来。
三、MAFFT 的算法策略怎么选
MAFFT 不是单一算法,而是一族策略,用户按数据规模与准确度需求在“速度—准确度”之间选型。选对策略往往比调参更重要。
策略 | 特点 | 适用规模 | 典型用途 |
FFT-NS-1 | 极快,纯渐进 | >2000 条 | 超大规模初筛 |
FFT-NS-2 | 快,默认 | ≤约5000 条 | 常规默认 |
FFT-NS-i | 迭代精化 | 中小规模 | 需要更准 |
L-INS-i | 局部两两信息+迭代,准确度高 | 约<200 条 | 推荐高精度 |
G-INS-i | 全局两两信息+迭代 | 约<200 条 | 序列长度相近 |
E-INS-i | 广义仿射空位+迭代 | 约<200 条 | 含大空位/嵌合 |
· 小规模、要准:选L-INS-i(--localpair --maxiterate 1000),这是 MAFFT 官方推荐的高精度默认,最易得到高质量比对。
· 大规模、求快:用FFT-NS-2(默认)或更快的 FFT-NS-1。
· 不确定:可用--auto,让程序按数据量自动在 L-INS-i、FFT-NS-i、FFT-NS-2 之间选择。
为什么要分“局部”和“全局”信息?L-INS-i 用 Smith-Waterman 局部两两比对,适合序列只有部分区域同源、或含可变区与插入片段的场景;G-INS-i 用全局比对,适合长度相近、整体同源的序列。选对“信息来源”,往往比单纯堆迭代次数更有效。
权威来源(MAFFT 官网)给出的经验法则是:约 200 条序列、约 2000 列以内,用 L-INS-i;更大规模用 FFT-NS-2。这个“规模决定策略”的取舍,正是使用 MAFFT 时最实用的选型逻辑。处理数万条序列时,还可借助近似引导树(如 PartTree)方法进一步提速。
四、MAFFT 的运行条件与参数
使用MAFFT 时,输入格式、空位罚分与迭代次数等参数会直接影响对齐质量;理解这些“工艺条件”,才能让结果稳定可复现。下面是最常被问到的几个设定。
· 输入格式:FASTA。程序会自动识别是氨基酸还是核苷酸序列。
· 空位罚分(gap penalty):控制空位“开(open)”与“延伸(extension)”的代价,影响序列中空位的位置与长度;对含大空位或可变区的数据需谨慎调整。过高的罚分可能抑制真实空位,过低则可能引入过多空位。
· 迭代次数(--maxiterate):越多越准但越慢,1000 是 L-INS-i 的推荐值,0 表示纯渐进不迭代。
· --retree:控制引导树重建等级,影响速度与稳定性。
· --thread:多线程并行,可显著加速大规模比对。注意迭代精化方法在多线程下结果可能不完全一致,复现时可用--thread 0。
· --auto:交给程序按规模自动选策略。
在实际项目中,通常先用默认速度策略快速把全库跑通,再对感兴趣的子集用L-INS-i 精细对齐。

图3 从比对到系统发育与蛋白工程的应用
此外,评估比对质量也不应只靠一个得分。保守列位的比例、空位的分布是否符合生物学预期、以及已知功能位点是否被正确对齐,都是重要的核查点。可用Jalview 等工具可视化比对结果,人工确认关键区域是否合理。若结果用于下游预测(如共进化、结构预测、突变设计),更应提高迭代次数并人工核查保守列位,避免把错误比对带入结论——这是“垃圾进、垃圾出”最典型的防线。
五、MAFFT 多序列比对与蛋白工程:MatwingsVenus®(晓鹜®)的视角
对蛋白工程而言,多序列比对不是终点,而是把“进化信息”注入设计流程的桥梁。从比对中提取的保守位点与共进化信号,是判断哪些残基不可动、哪些位置能容忍突变的重要依据。
在MatwingsVenus®(晓鹜®)相关技术流程中,多序列比对承担着“给 AI 模型喂进化先验”的角色:
· 保守性图谱:比对出的高保守列位提醒设计时避开结构/功能关键残基。
· 共进化残基对:比对驱动的相关性可用于推断接触位点,为结构与功能设计提供线索。
· 适应度景观(fitness landscape):把进化信息与AI 模型结合,可将“哪些突变可能被接受”的推断用于指导新一轮突变设计。
这一思路与当今AI 蛋白设计的主流范式一致:用MSA 编码的进化信息约束生成模型,再通过预测与实验验证闭环迭代。 当你要在已有蛋白骨架上做工程化改造——例如抗体人源化、酶稳定性优化或亲和力提升——一份高质量的 MAFFT 比对往往决定后续设计能否站得住脚。它帮助你把“有限的分析时间”花在真正重要的保守位点上,而不是在整条序列上盲目试错。
六、FAQ
MAFFT 和 ClustalW、MUSCLE 有什么区别?
MAFFT 用 FFT 快速定位同源区,在保持渐进式框架的同时大幅提速,并通过迭代精化兼顾准确度;相比 ClustalW 更快,相比 MUSCLE 在大规模与准确性上各有优势,最终选择取决于你的数据规模与精度需求。三者都是成熟方法,评价应结合具体数据集,不宜一概而论。
MAFFT 的 L-INS-i 和默认 FFT-NS-2 该怎么选?
小规模(约200 条以内)且追求高质量时推荐 L-INS-i(--localpair --maxiterate 1000);大规模或追求速度时用默认 FFT-NS-2。若不确定,用 --auto 让程序按数据量自动选择。
MAFFT 能处理多少条序列?
· 渐进式策略(FFT-NS 系列)可处理约数千条序列,FFT-NS-2 可应对约 5,000 条规模。
· 超大规模(数万条)可借助PartTree 等近似引导树方法。
具体上限受序列长度、输入文件大小与内存影响。
MAFFT 的结果可以直接用于蛋白设计吗?
可以,但需注意:比对只是提供进化先验,不等于实验或结构证据。建议把MAFFT 得出的保守位点与共进化信号作为设计约束,再结合实验数据或预测工具(如 MatwingsVenus®(晓鹜®)相关流程)综合判断,避免把计算得出的相似性直接当作功能结论。
七、总结
MAFFT 用快速傅里叶变换加速“同源区识别”,再用渐进式与迭代精化完成高质量对齐,因此在速度与准确度上同时胜出,成为多序列比对的常用首选。理解它的五步流程、按规模选策略、并合理设置空位与迭代参数,是得到可靠比对的关键。而对比对结果的进一步解读——保守位点、共进化信号、适应度景观——正是把进化信息转化为蛋白工程设计决策的桥梁。在 MatwingsVenus®(晓鹜®)为代表的 AI 蛋白工程流程中,一份高质量的 MAFFT 多序列比对,往往是“从序列到设计”的第一步。
【一句话结论】MAFFT 用快速傅里叶变换加速多序列比对,速度与准确度兼优,并为蛋白工程提供进化先验。
