
什么是Foldseek 结构搜索?为什么它能把蛋白质结构比对做到毫秒级?
发布于 2026年11月8日
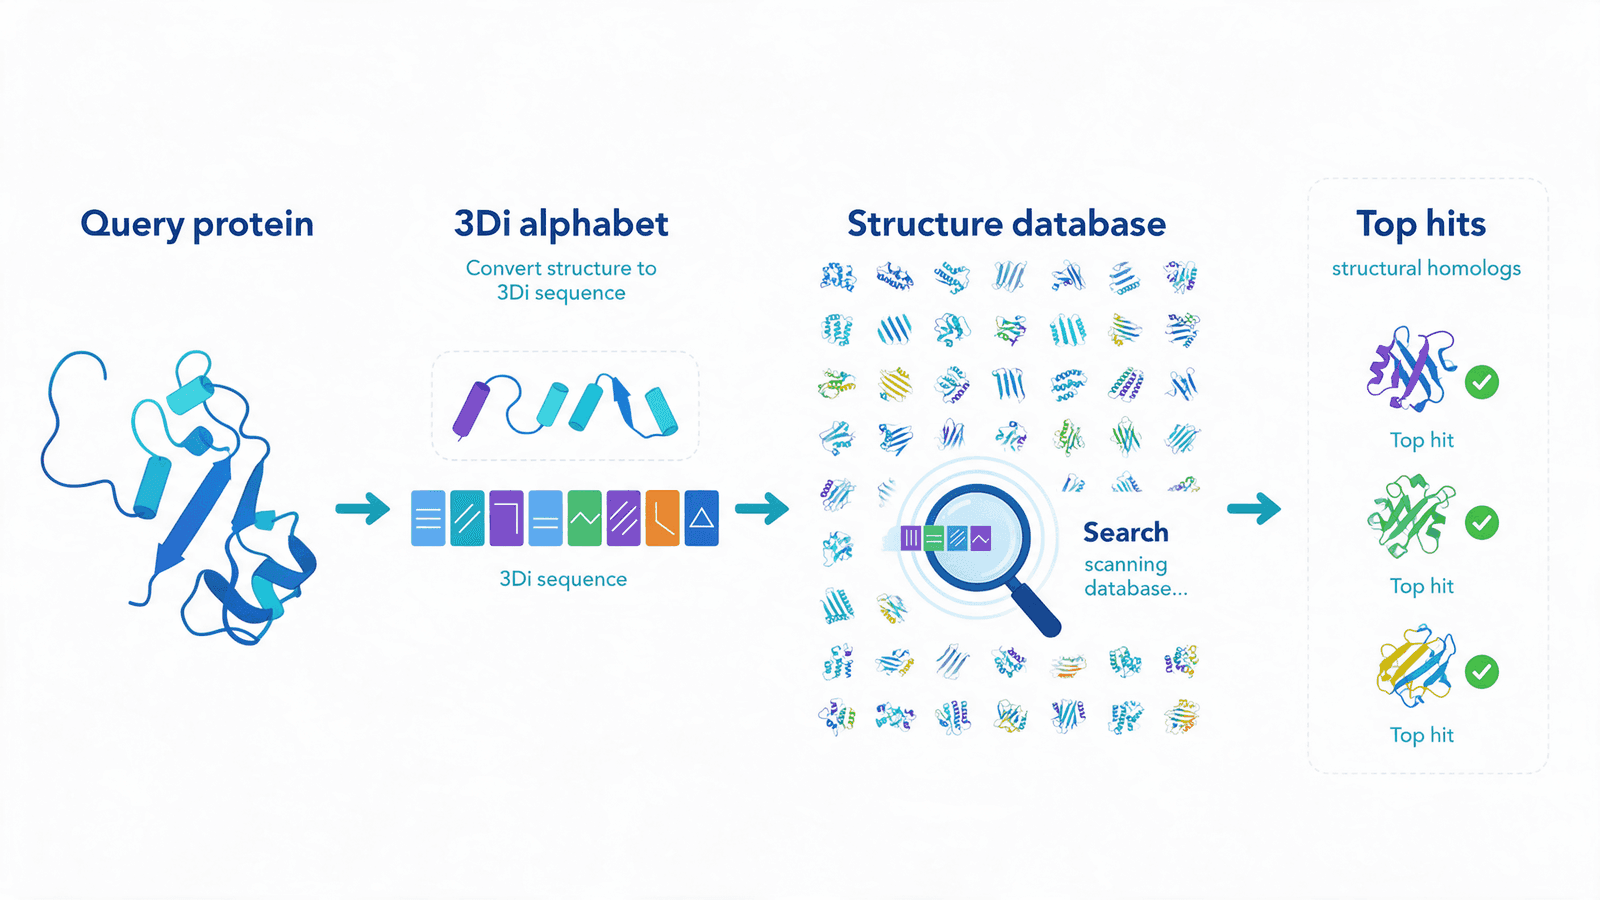
图1:Foldseek 结构搜索概念全景
当结构预测把数据库推上"亿级"后,如何在庞大结构库里快速找到相似蛋白,成为新一代结构生物学的核心瓶颈。
当AlphaFold 等工具让蛋白质结构预测进入"亿级"时代,各大数据库里躺着超过 2 亿条预测结构。此时,如何快速找出"和我的蛋白长得像"的其他蛋白,成了结构生物学和数据科学共同面对的新瓶颈。Foldseek 正是为解决"如何在巨大结构数据库里快速搜索"而生的一把钥匙:它来自德国马普研究与韩国首尔国立大学团队(Nature Biotechnology, 2024),把需要数天才能完成的全库结构比对,压缩到几秒内完成。它回答的问题很简单:如果只看三维折叠方式,两个蛋白到底像不像?这往往比只比对序列更触及功能本质。下面,我们从"为什么慢"讲起,一步步拆解它又快又准的秘密。
背景与瓶颈:当结构库膨胀到"亿"级,传统比对跟不上了
要理解Foldseek 的价值,先要明白"慢"的根源。传统上,判断两个蛋白质是否"像",靠的是三维结构比对,代表算法有 TM-align、Dali、CE。它们通过旋转、平移、叠合三维坐标来给"相似度"打分,精度确实高,但计算开销也巨大:每做一次全库比对,常常要跑上几天,甚至十几天。
十年前这种"慢"还能接受,因为当时蛋白质结构总数不过几万条;而如今,仅 AlphaFold DB 就已收录超过 2 亿条预测结构,再加上 PDB 中的实验结构,规模再上一个台阶。要在这样的数据库里,把一个查询蛋白与所有结构逐一叠合,在算力上几乎不可行。更重要的是,序列会变,但折叠方式往往更保守——许多远缘蛋白序列差异巨大,却共享同一套三维骨架,这正是"结构搜索"比"序列搜索"更能揭示功能联系的根本原因。
打个比方:你要在几亿本书里找一本内容最接近的,逐字逐页地比对当然最准确,但根本慢到没法用。你真正需要的,是一个能先快速"检索索引"再精读的搜索引擎。Foldseek 就是蛋白质结构世界的这个"搜索引擎"——它不逐字比,而是先索引、再对齐。
原理与结构:3Di 结构字母表,把 3D 结构"翻译"成可比对的序列
Foldseek 的核心创新,是把蛋白质结构编码为一维"序列":用 3Di 结构字母表描述每个残基与最近邻残基的三维相互作用,让结构像 DNA 一样被快速比对。
传统做法之所以慢,是因为非要在三维空间里做旋转、平移与叠合。Foldseek 换了个思路:不比较坐标,而比较"拓扑关系"。它把每个氨基酸残基 i 与其最近邻残基j 之间的相对几何(也就是二者虚拟中心的距离与朝向)聚类成一组离散状态,构成一个"结构字母表",即 3Di 字母表。这个字母表并不是拍脑袋定的,而是通过对大量已知结构的相互作用几何做无监督聚类学习而来。于是,一条蛋白链就被"翻译"成一条 3Di 序列——这条序列记录的不是氨基酸种类,而是"谁和谁在空间上挨得近、以什么朝向相对"。
有了"序列",就能复用成熟的序列比对引擎,形成两段式工作流:
· 第一步,用MMseqs2 的 k-mer 预过滤,以极快速度把上亿条候选缩小到极少数;
· 第二步,做向量化Smith–Waterman 局部比对,同时融合3Di 状态打分与氨基酸替换打分,得到高质量的比对结果;
· 必要时,还可以用加速版TM-align 做全局比对作为补充。
类比来说,这就像把一座复杂乐高模型先"压缩"成一张零件清单:对着成品图纸逐像素对齐很慢,但先比对零件清单,很快就能判断两座模型是不是同款。3Di 就是结构世界的"零件清单"。

图2:3Di 结构字母表机制,把结构编码为可比对序列
测定与选型:速度和灵敏度,Foldseek 值不值得用?
基准测试表明,Foldseek 在标准数据集上的灵敏度接近甚至超过经典结构比对工具,而速度高 4–5 个数量级,是"又快又准"的组合。
那"快"会不会牺牲"准"?论文(Nature Biotechnology, 2024)给出的一组核心数据可以回答。这里的"灵敏度"衡量的是算法在产生误报之前能正确找回多少真正的同源,数值越接近 100% 越理想:
· 灵敏度:在SCOPe40 单结构域同源检测基准上,Foldseek 的灵敏度约为 Dali 的 86%、TM-align 的 88%、CE 的 133%——对 CE 反而更敏感,对 Dali/TM-align 也基本持平。
· 速度:在SCOPe40 上,Foldseek 比 TM-align、Dali 快 4000 倍以上,比CE 快 21000 倍以上;在规模更大的AlphaFoldDB(版本 1)上,约比 Dali 快 184600 倍、比TM-align 快 23000 倍。
· 实例:以SARS-CoV-2 RNA 聚合酶(PDB 6M71 链 A,942 残基)在 AlphaFoldDB 检索,Dali 约需 10 天、TM-align 需 33 小时、Foldseek 仅需约 6 秒。
把这些数字换算到日常使用,就是:原本要跑一整天的全库检索,现在几分钟内就能拿到结果,而且找回的命中与经典方法大体一致。选型建议:当你需要大规模、结构化地扫描上亿条结构(例如做大范围同源聚类、结构基因组学筛查)时,Foldseek 是首选;当你要对单对结构做极高精度的叠合、用于发表级结构分析时,可以用更慢但更精细的算法做局部验证。两者互补,而非互相替代。需要提醒的是,Foldseek 在个别指标(如某些 HOMSTRAD 家族的比对精度)上可能略低于 CE/Dali/TM-align,但对"快速检索"这一目标而言,它的性价比几乎无可替代。
条件与工艺:安装、命令行与数据选择
Foldseek 通过 bioconda 一条命令即可安装,核心的 easy-search 子命令能在几行参数内完成"查询结构 vs 结构库"的检索,并输出标准 TSV 比对表。
动手之前,先准备环境:
· 安装:`conda install -c conda-forge -c bioconda foldseek`;也可以用官方 Docker 镜像,或者干脆用在线服务器 `search.foldseek.com` 直接上传结构检索。
· 常用命令:
· 检索:`foldseek easy-search <query> <targetDB> <result.m8> <tmp>`,用 `--format-output` 控制输出字段;
· 结构聚类:`foldseek easy-cluster` 可对大规模结构库做去冗余聚类;
· 复合物分析:`foldseek multimer` 支持多链复合物的结构比对与聚类。
· 数据:官方提供预构建索引(如AFDB50、PDB、Swiss-Prot),省去本地建库步骤,上手更快。
· 输出字段:建议保留`query, target, evalue, bits, qstart/qend, tstart/tend`,即可读"哪段结构对上了哪段"。判断命中时,`evalue` 越小越可信,通常 `evalue < 1e-3` 可视为显著命中。
再记住一个小技巧:命令里的`-s` 参数控制搜索灵敏度,值越大越敏感、但也越慢,一般从默认值起步,再按需调高即可。

图3:Foldseek 应用工作流:查询、注释与药物发现
结合MatwingsVenus®(晓鹜®):让结构搜索进入"发现—设计—验证"闭环
在MatwingsVenus®(晓鹜®)蛋白工程平台上,Foldseek 结构搜索是"起点"而非终点:它帮你快速锁定可借鉴的结构模板,再交给定向进化与生成式设计做下一步。
MatwingsVenus®(晓鹜®)平台把蛋白工程抽象成一条闭环:天然候选挖掘→ 结构搜索定位 → 定向进化/蛋白设计 → 湿实验验证 → 数据回流。在这条链路上,Foldseek 承担"结构侧"的初筛与定位:从亿级结构库中找出与目标蛋白同源的已知蛋白,快速回答"有没有现成的模板或家族成员"。
为什么要特意用"结构"而非"序列"来搜索?因为传统纯序列搜索(如 BLAST)在远缘同源(序列相似度低、但结构相似)时容易失灵;而Foldseek 靠 3Di 结构特征,能"跨序列"找到同源体,为后续设计提供更广的候选空间。这一步还能用于功能注释:把未知蛋白映射到已知功能的蛋白上,减少"从零猜功能"的试错成本。
再往前一步,它还能服务蛋白设计:结构搜索给出的"哪些位置、哪些模块值得改"的信息,会与 MatwingsVenus®(晓鹜®) 的活性位点图谱、AI 突变预测相结合,转化为可执行的突变与设计建议。这样,结构搜索就不再是一次性的查询,而是"发现—设计—验证—学习"高效闭环的起点。
举个例子:你想改造一个工业用酶,却不知道从何下手。先用它的结构跑一次Foldseek 结构搜索,看看它在结构库里最接近哪些已知蛋白,往往就能立刻判断它属于哪一类、有哪些可借鉴的同源模块,从而为后续的理性设计定好方向。
FAQ
Foldseek 和 BLAST 有什么区别?
BLAST 比对的是氨基酸序列,Foldseek 比对的则是三维结构。前者速度快,但对远缘同源不敏感;后者把结构编码成 3Di 序列再比对,能发现序列差异大、结构却相似的蛋白,更适合"跨家族找同源"的场景。
Foldseek 的中文含义就是"结构搜索"吗?
可以这样理解。Foldseek 的名字由 "fold"(折叠/结构)与 "seek"(搜索)组成。所谓 Foldseek 结构搜索,就是"用结构去搜索结构库",而不是用序列去搜。
一定要装本地环境才能用吗?
不一定。官方提供在线服务器`search.foldseek.com` 与 Colab 笔记本,上传结构即可检索;只有需要批量或本地运行时,才用 bioconda 或 Docker 部署。
如果我的结构是AlphaFold 预测的,能用 Foldseek 吗?
可以。Foldseek 与 AlphaFold DB(2 亿+结构)深度联动,预测结构与实验结构都能建库检索;官方预构建索引 AFDB50 正是为大规模预测结构库准备的。
总结
Foldseek 结构搜索的核心,是"用结构字母表把 3D 变成 1D"。它平衡了速度与灵敏度,是亿级结构时代不可或缺的基础设施。对蛋白工程与功能注释而言,它既是快速检索的工具,也是"从结构到功能"推理的起点。把它接入 MatwingsVenus®(晓鹜®)平台,你就能从"盲目试错"走向"有依据的设计"。下一步,不妨用一个你真正关心的蛋白质,亲手跑一次结构搜索,体会从"序列相似"到"结构相似"的视角转换。
一句话结论:Foldseek 用 3Di 字母表把结构编码成"序列",以提升 4–5 个数量级的速度实现接近 Dali/TM-align 的灵敏度。
