
Clustal Omega序列比对:大蛋白家族快速精准分析
发布于 2026年11月9日
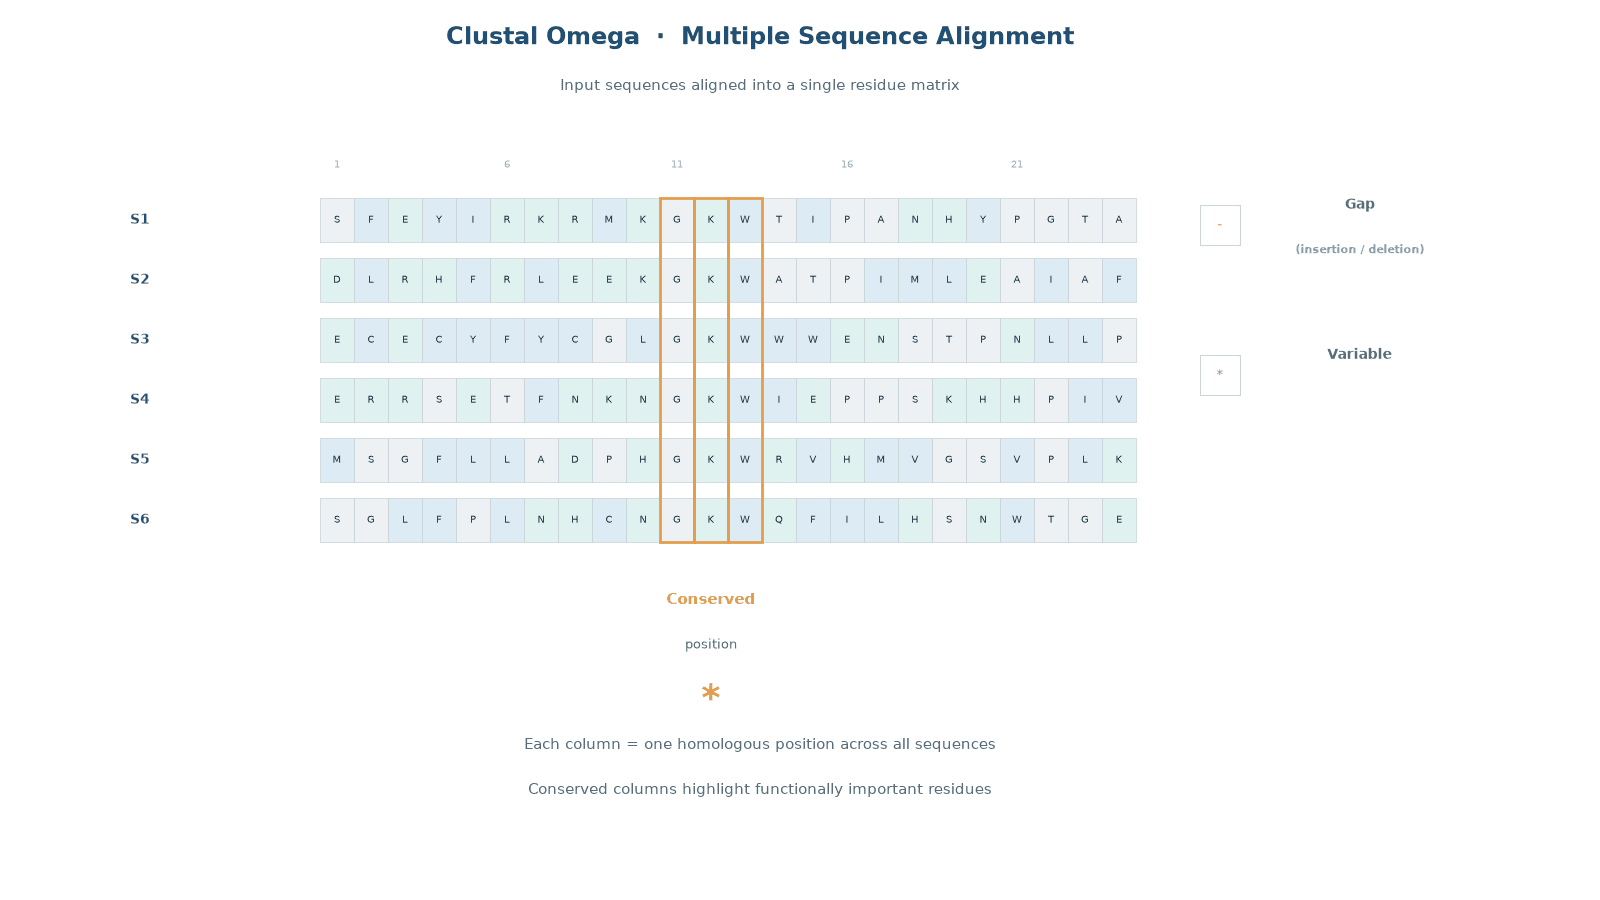
图1 Clustal Omega序列比对概念全景:多序列比对矩阵
什么是Clustal Omega序列比对?为什么它是大蛋白家族分析的首选?
当你手里有几十条、甚至几千条同源蛋白序列,想要弄清楚哪些位点高度保守、哪些区域是结构域边界、它们之间的进化关系如何,就需要把多条序列"对齐"在一起。Clustal Omega正是做这件事的高效工具:它属于经典的Clustal家族,是该家族面向大数据时代的升级版,以"快、准、能扩展"著称。
一、背景与机制:从ClustalW到Clustal Omega,多序列比对为何重要
一句话可摘录结论: 多序列比对(MSA)是同时比对三条及以上序列的方法,用于发现保守位点、结构域边界与进化关系,是蛋白注释与设计的基础。
序列比对解决的是"同源"问题:不同蛋白可能源自共同祖先,通过比对,我们能看到哪些位置在进化中被"固定"下来(保守位点),哪些位置允许变化。多序列比对(MSA)把三条或更多序列摆到同一张"对齐表"里,逐列对齐残基。
如果把多序列比对比作"把同一篇文章的不同版本逐行对齐",那么MSA就是在几十行文字里,找出所有版本都用同一个词的关键句——那些"关键句"就是保守位点。比对的结果是一个矩阵:每一行是一条序列,每一列代表一个同源位点;为了让不同长度的序列对齐,列与列之间可以插入"空位"(gap)。
· 保守位点:在同一列中出现次数最多的残基,往往承载结构或功能上的关键作用。
· 结构域注释:比对能暴露同一结构域在不同蛋白中的分布。
· 进化关系:比对结果是构建系统发育树(进化树)的基础。
这里需要区分两类比对:双序列比对(pairwise,如BLAST、Smith–Waterman)只比较两条序列,适合找相似片段;多序列比对则同时处理三条以上,能揭示仅在多个成员中才显现的保守模式。Clustal家族正是MSA的经典工具——从1994年的ClustalW,到带图形界面的ClustalX,再到2011年的Clustal Omega,它们见证了序列数据从小规模走向规模化。
早期工具ClustalW 与ClustalX 采用"渐进式比对"思路,但复杂度随序列数近似平方增长,难以应对快速增长的大规模序列数据。Clustal Omega 保留了渐进式比对的框架,却在"构建指导树"和"两两比对"两个环节做出了根本性改进。
二、核心原理与结构:Clustal Omega的mBed指导树与HHalign
一句话可摘录结论: Clustal Omega通过mBed快速构建指导树,再用HHalign做两两profile-HMM比对,在保证精度的同时把整体复杂度降到近线性。
渐进式比对的思路是:先按序列间的相似度搭一棵指导树(guide tree),再沿着树的合并顺序,从最相似的两条序列开始,逐步把更多序列/比对"合并"进来。Clustal Omega的关键改进集中在两点。
完整流程可分三步:先估算所有序列间的相似度,据此构建指导树;再按树的分支顺序,从最相似的两条开始合并;最后把每一步得到的"比对块"逐步扩大,直到所有序列都被纳入。Clustal Omega的前两步用mBed加速,第三步用HHalign保证精度。
· mBed构建指导树:传统方法要把所有序列两两比较,时间和内存是O(N²)。mBed("embedding")把每条序列放进一个维数约等于logN的空间,用一个由若干"参考序列"距离组成的短向量代表它,再快速聚类(如K-means或UPGMA),从而把建树成本压到近似O(N log N)。
· HHalign做profile-HMM比对:到合并阶段,Clustal Omega不再只对比对"字符",而是把每条序列/每个比对建成profile隐马尔可夫模型,用HHsuite中的HHalign去对齐两个profile-HMM。这比传统的profile-profile比较更灵敏,能更准确地捕捉到弱同源信号。
mBed可以这样理解:与其把人群里每个人两两比较,不如先选出少数几个"地标"(参考序列),再让每个人报告自己与各地标的距离。由于地标数量只需随总人数缓慢增长(约logN),定位成本大幅下降,建树也就能在近线性时间内完成。HHalign则类似"比较两份详细档案",而不是只看档案封面的关键词——它用概率模型来捕捉弱同源信号,因此在进化距离较远、序列相似度较低时,仍能保持较好的对齐质量。
比起ClustalW,这一"embedding树 + profile-HMM比对"的组合,是Clustal Omega在精度与速度上领先的关键。

图2 Clustal Omega核心机制:mBed指导树与HHalign比对
三、测定与选型:如何选择序列比对工具,Clustal Omega的适用边界
一句话可摘录结论: 选择比对工具应依据序列数量、同源程度与分析目标;Clustal Omega在中等到大规模、同源性尚可的蛋白集合上,速度与精度综合表现突出。
· 什么时候选Clustal Omega:序列数量从几十到几千甚至上万条、需要"足够准"又要求"足够快"的场合,例如全基因组蛋白家族分析、结构域批量注释。
· 与其他工具的中性对比:与ClustalW/X相比,Clustal Omega在可扩展性上明显更强;在精度上,它接近一些"一致性(consistency)"方法(如T-Coffee、M-Coffee),但速度通常更快。与MAFFT/PartTree等超大规模工具相比,Clustal Omega在精度与速度间提供了不同的取舍,具体选择应结合数据规模与目标。
· 注意边界:Clustal Omega对低同源、且N端或C端存在长延伸的序列集合表现会下降;网页端(如EMBL-EBI的MSA服务)通常有一次可提交的序列数/文件大小上限,超大输入建议改用本地命令行版本。
一句话:先看序列数量与同源性,再选工具;Clustal Omega是"大规模、中高同源"场景下的稳健默认项。
选型时可以按三个维度快速判断:序列数量决定是否需要可扩展的工具;同源程度决定是否需要更灵敏的模型;分析目标决定是追求极致精度还是可接受的规模。经验上,当序列数在几十到几千、成员间尚能辨认出保守列时,Clustal Omega是兼顾速度与精度的稳健选择;若需超大规模(数万条级以上)且可接受精度折中,可考虑PartTree等方案;若数据量小但对精度要求极高,一致性方法更合适。
四、条件与工艺:Clustal Omega实战使用要点
一句话可摘录结论: 运行Clustal Omega时,准备好高质量的FASTA输入、设定合适的输出格式与迭代次数,即可同时得到比对结果与指导树。
· 输入:常见FASTA格式,支持蛋白质、DNA与RNA(自1.1.0版起支持核酸)。
· 输出格式:Clustal、FASTA、Stockholm、Phylip等;如需下游建树,可额外输出指导树或距离矩阵。
· 参数:迭代次数(按需提高精度)、输出树状图/距离矩阵开关、cluster大小上限等。
· 常见坑:输入序列应去除冗余与低质量片段,避免污染比对;低同源区域可先做修剪;结果中应检查gap分布,判断对齐是否"跑偏"。
Clustal Omega会同时返回"比对"和"树"两件输出,前者用于位点分析,后者用于进化/分组判断。
在跑比对前,建议先对输入做基本清理:去除明显冗余或低质量的序列、统一序列方向、去掉过短或高度重复的片段,避免它们"污染"比对结果。运行时可关注迭代次数:适当增加迭代(基于HMM的迭代)往往能提升弱同源区域的对齐质量,但会消耗更多时间。输出应重点检查空位分布与保守列:若某列出现大量空位或残基过于零散,说明该区域可能比对"漂移"或本身低同源,需要修剪或换参数。比对结果可进一步用于构建系统树、绘制序列logo,或定位关键残基。

图3 Clustal Omega应用流程:由比对到蛋白工程设计
五、MatwingsVenus®(晓鹜®)如何将序列比对融入蛋白工程闭环
一句话可摘录结论: 在MatwingsVenus®(晓鹜®)平台,多序列比对是蛋白工程流程的上游一环,用于识别保守位点、为后续AI驱动的设计提供序列层面的证据。
在真实的蛋白工程里,序列比对从来不是终点,而是起点。MatwingsVenus®(晓鹜®)把多序列比对作为流程中的基础步骤:先通过MSA定位保守位点与可变区域,再结合结构信息,判断哪些残基适合做突变、哪些位置应保持稳定。比对结果与结构、功能注释相互印证,再交给AI驱动的高通量设计与筛选闭环——从序列证据到候选设计,都力求"有据可依"。
· 上游定位:保守位点提示关键残基,可变区提示可工程化空间。
· 证据整合:比对、结构与功能标签相互校验,减少盲目筛选。
· 闭环回流:设计产物的经验又可回流到下一轮比对与学习中,形成持续优化的流程。
在实际工程中,平台先以MSA快速定位哪些位点高度保守、哪些区域允许变化,再把结果与结构、功能注释交叉验证。这样,AI驱动的设计不再只是"盲目试错",而是有序列证据支撑的方向性探索。设计产物经表达与功能验证后,其数据又能回流到比对与注释中,持续校准后续模型,形成一个不断迭代的闭环。
MatwingsVenus®(晓鹜®)由天鹜科技(Matwings Technology)打造,其目标是把需要大量专家经验的序列分析,沉淀为可复用、可量化的蛋白工程能力。
六、常见问题FAQ
Clustal Omega与ClustalW有何不同?
Clustal Omega是新版多序列比对程序,核心差异在"指导树构建"与"两两比对"两处:用mBed快速建树,用HHalign做profile-HMM比对,因而在相似精度下能扩展到更大规模、速度也更快。
Clustal Omega最多能比对多少条序列?
网页端工具通常有一次提交的序列数上限,如EMBL-EBI的MSA服务可提交约4000条序列或4MB文件;本地命令行版本可处理更大规模。具体能力取决于内存与序列长度。
Clustal Omega输出哪些格式?
可输出Clustal、FASTA、Stockholm、Phylip等比对格式,并可额外生成指导树或距离矩阵,便于下游建树或进一步分析。
Clustal Omega适合蛋白还是DNA?
两者都支持(核酸自1.1.0版起)。它最初为蛋白序列优化,蛋白同源分析是其主要用途;在做DNA/RNA比对时需留意参数与评分的差异。
七、总结
Clustal Omega序列比对用"mBed指导树 + HHalign profile-HMM比对"这一组合,把多序列比对从"能跑"推进到"跑得大、跑得快、也够准"。它适合中等到大规模、中高同源的蛋白家族分析,是结构域注释、保守位点识别与进化研究的稳健默认工具。在蛋白工程的真实流程中,它是定位关键残基、指导设计的可靠起点——而这也正是MatwingsVenus®(晓鹜®)把它纳入自身闭环的原因。
一句话结论
Clustal Omega用mBed建指导树、HHalign做比对,兼顾速度与精度。
