
自动化蛋白研发平台:蛋白研究如何从手工实验走向全流程自动化?
发布于 2026年11月10日
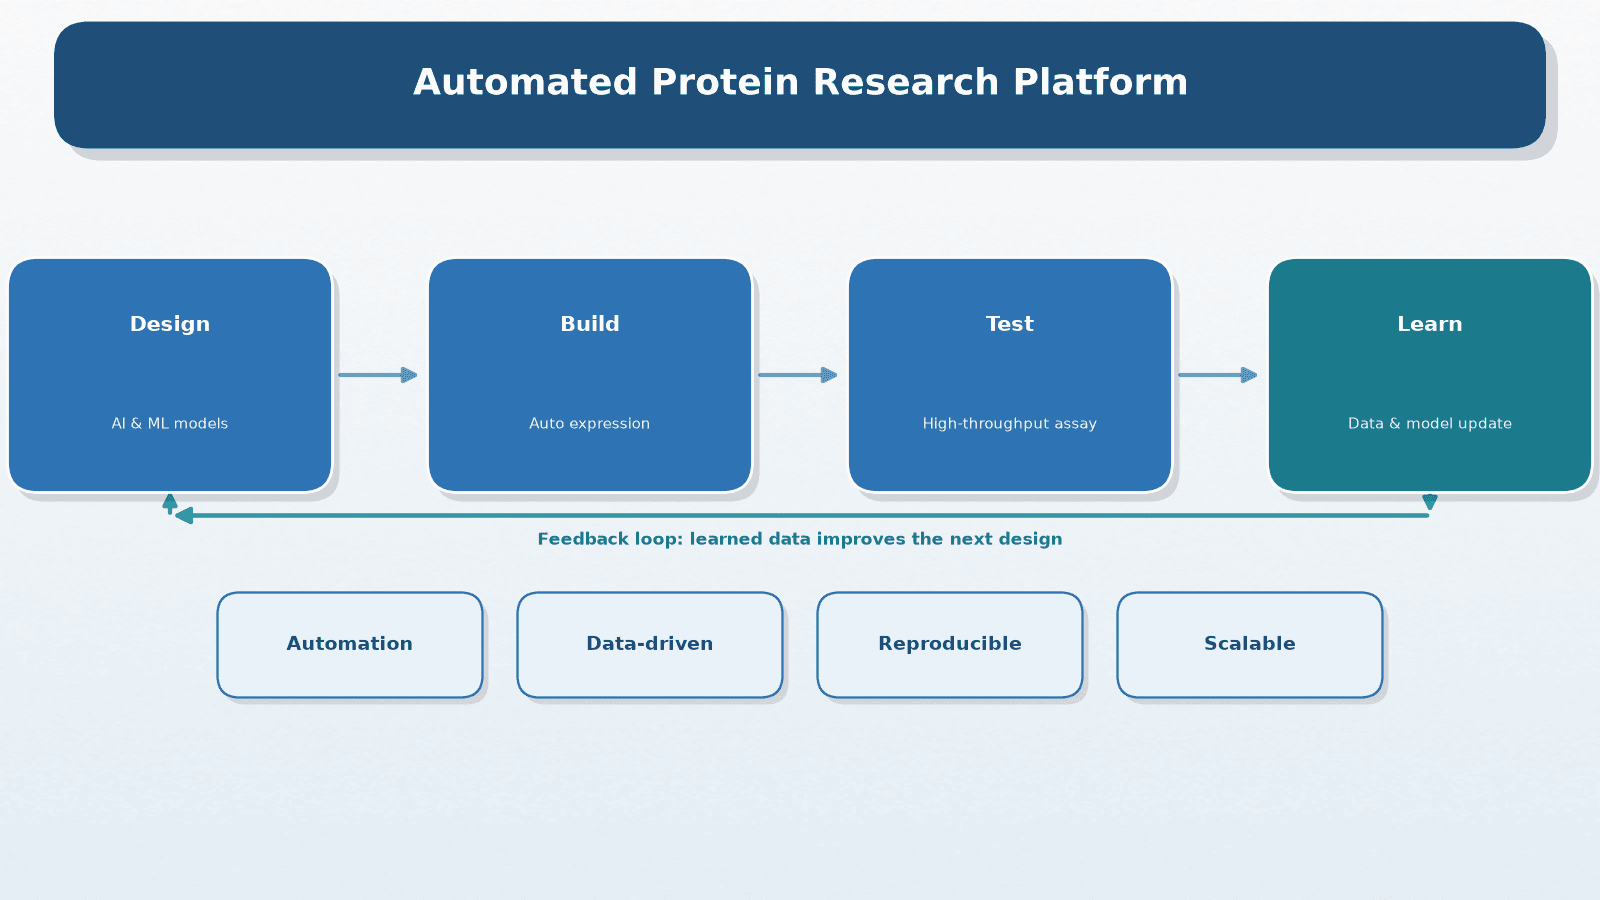
图1 自动化蛋白研发平台:从设计到表征的自动化闭环
自动化蛋白研发平台(Automated Protein Research Platform)是一套把「设计—构建—测试—学习」串成数据闭环的智能研发系统。传统上,蛋白研究依赖研究者在实验室反复手工操作:构建表达、纯化、活性测试,步骤多、周期长,批次之间结果还容易波动。当 AI 算法与自动化设备真正协同起来,重复劳动交给机器,研究者就能把精力留给判断与创新。本文用几组图讲清这个平台解决了什么、如何运作、哪些环节真正有效,以及如何结合MatwingsVenus®(晓鹜®) 落到实际研发里。
一、背景:蛋白研究为什么需要自动化?
蛋白研发正从「经验驱动」走向「数据驱动」,但多数团队仍卡在这些环节:
· 手工实验瓶颈: 表达、纯化、活性测试包含大量重复操作,人力成本高,也容易因疲劳出现人为误差。
· 迭代周期长: 一轮「设计—测试」往往以周、月计算,很难覆盖足够大的候选空间,许多有潜力的想法来不及验证。
· 可复现性差: 手工操作差异大,同一批次的重复实验也常出现波动,结果不稳定就难以判断哪个方向真正有效。
· 数据孤岛: 设计工具、实验记录、分析软件彼此割裂,数据难以沉淀、复用,前期积累常被浪费。
可以用一个类比来理解:如果把蛋白研究比作「试错」,自动化并不是让机器替你想,而是让「试错」更快、更便宜、更系统——从一个一个地试,变成一批一批地筛。这正是自动化蛋白研发平台被越来越多酶工程、抗体研发团队采用的原因:它把「人花时间在重复」变成「机器负责重复、人负责决策」。
推动这一转变的,是现实中的成本压力。一次失败的蛋白设计,往往意味着数周甚至数月的实验投入;如果能把候选空间铺得更广、筛得更快,就能更快找到真正可用的方向。再加上机器学习让「预测—验证—再预测」成为可能,自动化与 AI 的组合,正把过去依赖老师傅经验的手艺活,变成一套可复制、可规模化的工程流程。对需要持续交付新蛋白的企业而言,这已经不只是「效率选项」,而是决定研发速度与成本竞争力的关键能力。
二、原理与架构:自动化蛋白研发平台如何运作?
平台通常采用「四环节闭环」的模块化架构,四个环节缺一不可:
· Design(设计): 用机器学习、结构或序列模型生成候选序列、突变组合,把「要试什么」先想清楚。
· Build(构建): 自动化合成、克隆与表达,批量制备候选,把「想出来的」真正做出来。
· Test(测试): 高通量筛选与表征,测活性、亲和力、稳定性、表达量、溶解度,把「做出来的」量出来。
· Learn(学习): 把实验结果回馈给模型,用主动学习挑选下一轮「最有价值」的实验点,让下一轮更聪明。
关键在于数据能不能真正「闭环」。很多团队不是缺 AI,而是缺高质量、结构化的实验数据。平台的价值不只是自动化某一个环节,而是把每个环节产生的数据都标准化、结构化地收进同一个数据底座,让模型越用越准、迭代越用越快。设计、构建、测试、学习四者不是孤立的工具,而是一整套互相咬合的体系。
两个关键概念,用大白话解释:
· 适应度景观(fitness landscape): 可以把蛋白性能想成一片高低起伏的地形图,山越高性能越好。序列或结构空间极其广阔,AI 的任务就是在里面找到最高峰,而不是盲目乱走。
· 主动学习(active learning): 模型「最不确定」的地方往往最值得做实验。与其平均撒网,不如优先测量信息量最大的样本,少做无用功、更快逼近最优。

图2 平台核心:数据驱动的蛋白工程主动学习闭环
三、测定与选型:自动化能测什么、适合识别什么?
一个平台能不能帮到团队,先看它测什么、测量是否可靠。可自动化测定的常见指标包括:
· 酶活性、底物转化率;
· 结合亲和力与动力学参数;
· 热稳定性、熔解温度;
· 表达量与可溶性;
· 聚集体、降解等质量属性。
更适合选用自动化的场景,往往满足以下几个特征:
· 候选量大: 需要批量评估大量候选(定点突变组合文库、定向进化文库),人工逐个测不现实。
· 指标标准化: 关键指标已可用自动化设备稳定检测,读数与工艺一致。
· 多轮迭代: 需要跨多轮次迭代,并且希望数据可追溯、可复用,而不是每轮从头开始。
选型建议要务实:如果只是零星改两三个位点,人工单点验证可能更快,不必盲目上自动化;自动化更适合「规模化、迭代式、数据驱动」的研发。判断标准不是「别人有所以我也要」,而是「我的项目是否真的需要批量、重复、可持续的测量」。还有一个容易被忽略的点:自动化更适合「重复、可量化」的测量。如果某个指标要靠人工判断、难以标准化,强行自动化反而会引入新的偏差。因此选型时先问一句:这个指标,能不能被稳定、机械地重复测出来?
四、条件与工艺:把自动化落地到实验流程
自动化不是「买了设备就有了」,需要把实验条件与工艺控制到位,否则机器也会「放大错误」:
· 移液与样品处理: 自动移液工作站处理 96/384 孔板,减少人为误差与批次差异,是自动化稳定性的第一步。
· 工艺窗口稳定: 表达温度、诱导条件、纯化缓冲、检测缓冲等需在自动化下保持一致,并完整记录,避免「换了人结果就变」。
· 质量控制: 每个批次保留质控样品,持续监控关键指标与数据质量,快速发现漂移。
· 数据可追溯: 从样品条码到检测结果自动关联,过程可审计、结果可复现,也方便回溯问题。
还需要考虑通量与成本的平衡。高通量意味着更多试剂、更多耗材,也意味着更复杂的数据管理;自动化并不是「通量越高越好」,而是要在通量、成本与数据质量之间,找到匹配项目需求的平衡点。把工艺固化下来、把异常自动暴露出来,自动化才能真正「省心」,而不是单纯「添乱」。

图3 自动化蛋白研发流程与工艺条件
五、MatwingsVenus®(晓鹜®) 如何实现自动化蛋白研发?
MatwingsVenus®(晓鹜®) 聚焦蛋白研发的智能化与自动化。核心思路是:以高质量数据为底座,把先进算法与自动化工具结合起来,让团队在同一平台上完成从序列设计、构建、筛选到表征的协同,并在每轮迭代中积累、复用数据。
· 平台价值: 减少重复实验,把研究者更多时间留给判断与创新;让数据流动起来,为下一轮设计提供依据。
· 能力边界: 平台提供算法与自动化工具,任何预测结果都应通过实验验证;平台不替代实验证据,也不虚构实测数据。
· 企业级落地: 如需定制化部署与整体方案,可联系 Matwings Technology(天鹜科技)。
在具体使用中,研究团队通常从已有序列或结构出发,在平台上设定目标(例如提升活性、让蛋白更耐热),平台结合模型给出候选;经过自动构建与高通量表征,结果回到模型,下一轮候选就更有针对性。如此反复,平台积累的不只是一批实验结果,更是一份可复用的「研发知识库」——这也是自动化与 AI 结合时,最容易产生长期价值的地方。
六、常见问题 FAQ
Q1:自动化蛋白研发平台适合哪些场景?
适合需要批量筛选候选、跨多轮迭代的蛋白工程,如酶改造、抗体优化、蛋白定向进化。若是零星单点验证,人工可能更快。
Q2:平台能保证预测准确吗?
不能也不应承诺。平台提供算法与自动化计算,预测结果是「假设」,必须用实验证据验证;实验数据才是最终依据。
Q3:自动化投入大吗?需要什么条件?
需要样品处理、检测设备与数据系统协同。对规模小、迭代少的项目,人工可能更快;对规模化、持续迭代的项目,自动化更值得投入。
Q4:数据安全与可追溯如何保障?
建议保留质控样品、批次记录与数据日志,使过程可审计、结果可复现;对涉及商业敏感的数据,按企业合规要求处理。
七、总结
自动化蛋白研发平台的本质,是把「试错系统化」。它不会取代科学判断,而是把设计、构建、筛选、表征串成闭环,让每次实验都为下一次提供依据。对规模化、数据驱动、需要持续迭代的蛋白工程而言,这是从「经验驱动」走向「数据驱动」的现实路径。MatwingsVenus®(晓鹜®) 愿与研发团队一起,把自动化落地到真实的研发流程之中。
一句话结论: 自动化蛋白研发平台把设计—构建—筛选—表征串成闭环,让蛋白研究更快、更省、更可复现。
