
什么是AlphaFold数据库(AlphaFold DB)?从氨基酸序列到三维结构的AI蛋白质库
发布于 2026年11月4日
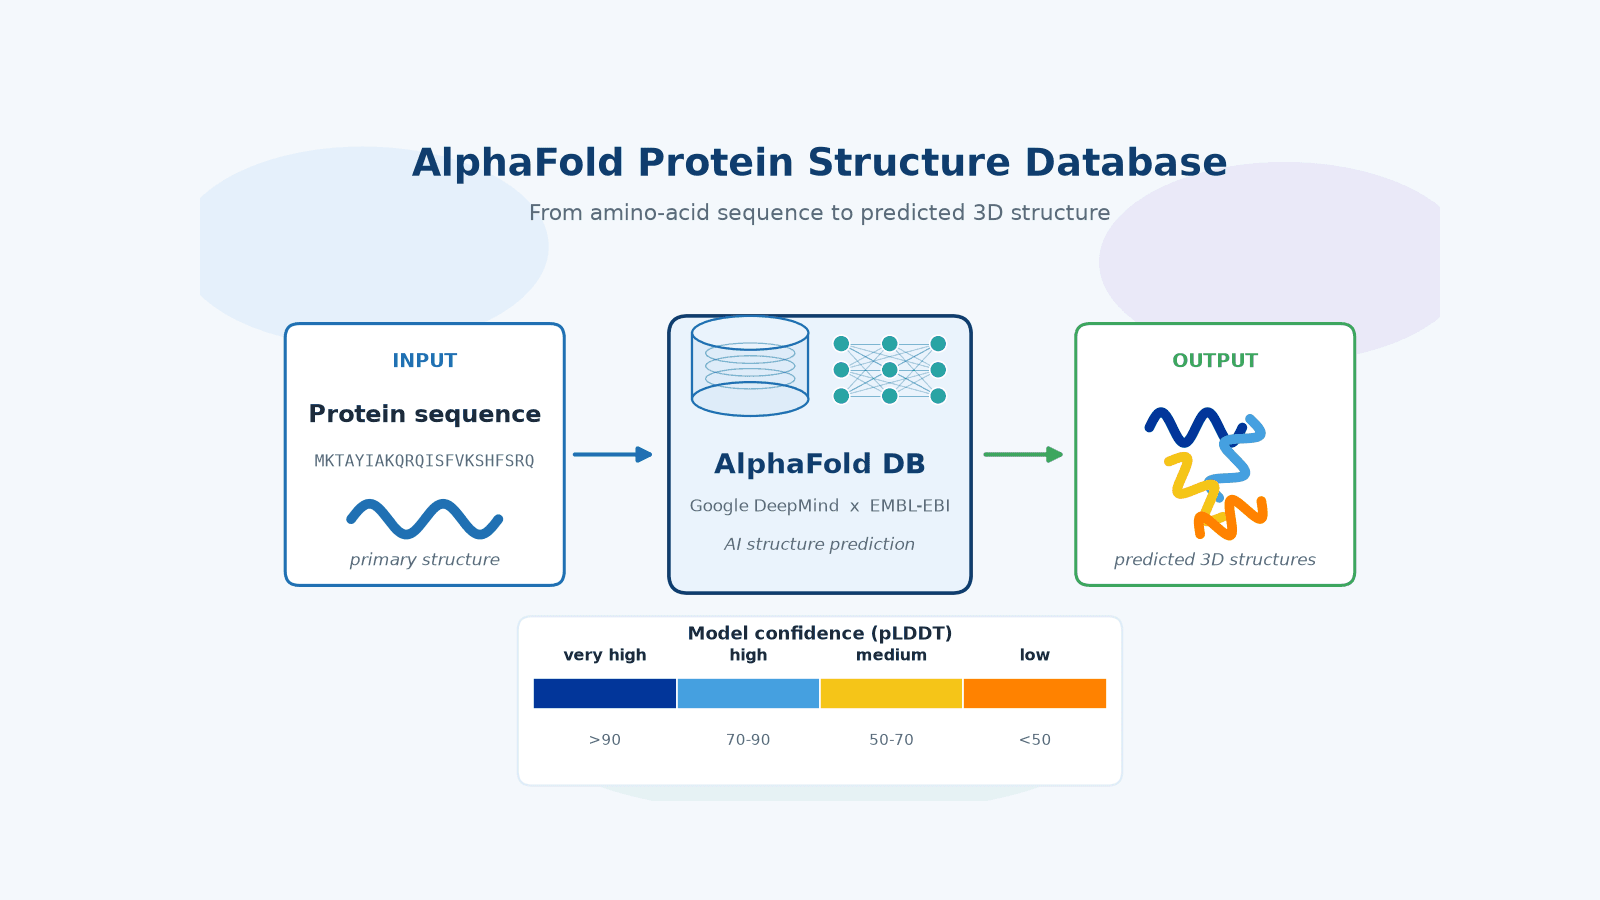
图1:AlphaFold数据库把序列转成AI预测的三维结构。
分类:D AI/算法/平台(主);E 结构/机制/序列分析(兼)
蛋白质是生命的“分子机器”,而它的三维折叠结构几乎决定了它能做什么。可长久以来,科学家手里“已知序列”的数量远超“已知结构”的数量。把这两者之间的距离拉近,是结构生物学几十年的难题,也是AlphaFold数据库在短时间内广受关注的根本原因。
背景:蛋白质结构为何稀缺,AlphaFold数据库为何而来
蛋白质的功能由它的三维结构决定,但实验测定结构既慢又贵,科学家已知的蛋白序列数量远多于已知结构,这就是AlphaFold数据库要填补的缺口。
为什么结构这么重要?因为蛋白要真正“干活”,往往需要把特定的氨基酸侧链摆到特定的空间位置,去结合底物、传递信号、催化反应。一个细微的折叠差异,就可能让蛋白失去功能。可以说,结构是蛋白功能和活性的“物理地图”。
实验测定结构为什么难?主流手段各自有短板:X射线晶体学要求把蛋白培养成晶体,很多膜蛋白和柔性蛋白难以成晶;冷冻电镜(cryo-EM)分辨率持续提升,但设备昂贵、数据处理复杂;核磁共振(NMR)则受蛋白尺寸限制。它们共同的问题是“慢”和“贵”,解析一个结构往往要数月甚至数年。
于是“结构缺口”长期存在:已知蛋白序列数以亿计,而实验解析出的结构只有几十万个,且其中许多来自少数模式生物或被反复解析。正是这个缺口,让“用AI预测结构”变得极具价值。Google DeepMind开发的AlphaFold,在2020年国际蛋白质结构预测大赛(CASP14)上以接近实验的精度夺冠;因其在蛋白质结构预测上的突破,核心开发者Demis Hassabis与John Jumper获得了2024年诺贝尔化学奖。2021年,Google DeepMind与EMBL-EBI联合上线AlphaFold数据库,把预测结果做成公开可检索的资源,随后扩展到覆盖超过2亿个预测结构。
原理:AlphaFold如何从序列“猜”出三维结构
AlphaFold用深度学习,把氨基酸序列与多序列比对(MSA)中的进化信号作为输入,通过Evoformer与结构模块输出三维坐标,并为每个残基标注置信度。
可以把它想象成一位“结构推理师”:输入一份氨基酸序列,输出一份三维折叠。它靠的并不只是序列本身,而是叠加了自然界“已经演化了亿万年的经验”。
· 三类输入:①氨基酸序列本身;②多序列比对(MSA),即进化上相近的蛋白序列集合——自然选择会“记住”对结构与功能重要的氨基酸约束,如果两个位点在进化中总是一起变化(共进化),往往意味着它们在空间上靠得很近;③已知结构的模板。
· 注意力机制(attention):这是模型“读懂”序列的关键。它让模型能注意到序列里相距很远、却可能在三维空间上相互靠近的残基,就像阅读时去捕捉前后呼应的线索。
· 模型分两步:Evoformer用注意力机制整合序列与配对信息,提取残基间的相互依赖;Structure Module再把这些关系“组装”成三维坐标。
· 输出不止坐标,还有两个质量指标。
· pLDDT:给出每个残基的置信度(0–100分),像“这一步猜得有多有把握”。
· PAE:给出残基对之间相对位置的误差估计,像“这两个部位的相对位置猜得对不对”。
· 一个默认假设:AlphaFold通常给出一个最可能的静态构象。遇到天然就会“动”的区域(柔性环、无序区),pLDDT会偏低——这其实是模型在提醒你:这里我也不确定。

图2:Evoformer与结构模块输出坐标、pLDDT与PAE。
怎么用:检索AlphaFold数据库并判断可信度
在AlphaFold数据库可用UniProt访问号、基因名或序列检索目标蛋白,再借助pLDDT与PAE判断哪些区域的预测可信、适合拿去做后续研究。
· 如何检索:用蛋白的UniProt访问号或基因名搜索最直接;也支持按序列搜索(一般要求至少20个氨基酸)。近年又加入基于序列相似的搜索和结构聚类(Foldseek Cluster),方便找到结构相近的蛋白。
· 如何判断可信度:预测结构可用pLDDT着色分级——深蓝(>90)非常可信、浅蓝(70–90)可信、黄(50–70)一般、橙(<50)基本不可信。做结构分析时应优先关注深蓝/浅蓝区域。
· 注意PAE:若某对残基PAE较高,说明它们相对位置不明确;即便单个残基的pLDDT很高,整体折叠仍可能不够稳定。
· 覆盖范围:数据库覆盖UniProt,并提供人源及几十种模式生物的参考蛋白组批量下载;超长序列(如超过2700个残基)会被切成分段。
· 实践提醒:预测结构是“单一静态快照”,不显示构象变化,也不含配体、金属离子或翻译后修饰;这些细节需用其他工具或实验补充。近年数据库还整合了细菌、病毒等社区数据集,进一步拓宽了预测覆盖。
· 如何获取数据:每个条目可下载PDB或mmCIF格式坐标,也可通过API获取。
应用与流程:AlphaFold数据库能加速什么
把AlphaFold数据库的预测结构当作起点,可以在药物发现、酶工程与抗体设计中快速筛出值得进入湿实验验证的候选,从而显著缩短研发周期。
一个典型流程是:定义目标蛋白→ 检索预测结构 → 按pLDDT/PAE筛选可信区域 → 结合下游分析(分子对接、结合位点识别、功能注释等)→ 选出候选 → 湿实验验证。
· 药物发现:当靶点缺乏实验结构时,预测结构可用于虚拟筛选与靶点分析,先缩小候选范围再实验确认。但要注意,预测结构不等于结合亲和力,需结合对接工具与实验验证。
· 酶工程:预测结构帮助定位活性位点、底物通道与催化残基,为定点突变提供“可下手”的位置;
· 抗体与蛋白设计:预测结构辅助设计新的结合界面,但抗体本身柔性大,需多个判断。
· 明确能力边界:AlphaFold不直接预测突变对稳定性的影响(ΔΔG),也难以处理多构象与配体结合态;这些场景需要专门的预测工具,并最终靠实验确认。把预测结构当作高质量“假设”而非结论,是用好它的关键。

图3:预测结构接入蛋白工程流程,并与平台集成。
MatwingsVenus®(晓鹜®):序列如何直达功能,跳过结构环节
MatwingsVenus®(晓鹜®)走出了一条“从序列直接到功能”的路径——无需等待结构,直接以氨基酸序列为输入,用适应性景观与主动学习把AI的序列—功能预测变成可验证的湿实验方案。
很多蛋白研发项目其实是从“手上有一段序列”开始的,而不少目标蛋白既没有实验结构,也没有高质量预测结构。这正是MatwingsVenus®(晓鹜®)的定位:不把结构当作前置门槛,而是直接用序列开启“功能感知”的设计。
起点:把序列本身作为设计输入,基于序列特征推测哪些位点可能影响活性、稳定性或可开发性,直接圈定重点关注区域。
闭环:结合适应性景观(fitness landscape)——反映不同突变组合对功能的影响——与主动学习(active learning),用模型挑选“最有信息量”的下一轮实验,让每一次湿实验都有方向,少做无效试错。
功能感知筛选:进入湿实验前,先做基于序列—功能模型的计算机打分,过滤明显不合理、缺乏价值的候选。
模型→湿实验→数据→再训练:实验数据回流模型,形成可迭代的正反馈闭环。
它的价值在于,把“AI预测”从一个概念,变成可执行、可验证、可迭代的研发路径:用序列圈定重点、用学习算法规划实验、用湿实验检验假设,再把结果喂回模型——全程无需依赖结构,序列即可直达功能。
常见问题(FAQ)
AlphaFold数据库和PDB有什么区别?
PDB(蛋白质数据库)收录的是实验测定并验证过的真实结构,数量有限;AlphaFold数据库收录的是AI预测结构,数量超过2亿、覆盖面更广,但本质是预测,需要用置信度指标判断可信度。
AlphaFold预测的结构一定可靠吗?
不一定。每个条目都带有pLDDT与PAE作为质量信号:pLDDT越高越可信,深蓝(>90)区域通常接近实验水平,橙(<50)区域基本不可信。可靠与否要结合这些指标来判断,关键用途仍建议实验验证。
我可以免费使用AlphaFold数据库吗?
可以。AlphaFold数据库对全球开放、免费使用,可直接在网站检索下载,也可通过API或批量下载获取数据;另有AlphaFold开源代码和Colab工具可用于预测不在库中的自定义序列。
AlphaFold数据库能完全替代实验测结构吗?
不能。对高置信度区域,它能显著减少实验工作量,但无法覆盖所有情况,例如多构象、柔性区、翻译后修饰、配体结合态等;关系到结论的关键结构仍依赖实验或需谨慎验证。
总结
AlphaFold数据库把AI结构预测从实验室成果变成随时可检索的公共资源,正在重塑结构生物学与蛋白质工程的工作方式。
它免费、开放,覆盖超2亿个预测结构;它把“从序列到结构”的门槛大幅降低,让更多蛋白“有结构可用”。但预测不等于事实,pLDDT与PAE正是我们用好它的“使用说明书”。对想高效做蛋白工程的团队来说,结构起点+ AI工具 + 湿实验验证的闭环,是实打实的提速方式。
