蛋白质序列去冗余:让分析从代表序列开始
发布于 2026年9月17日
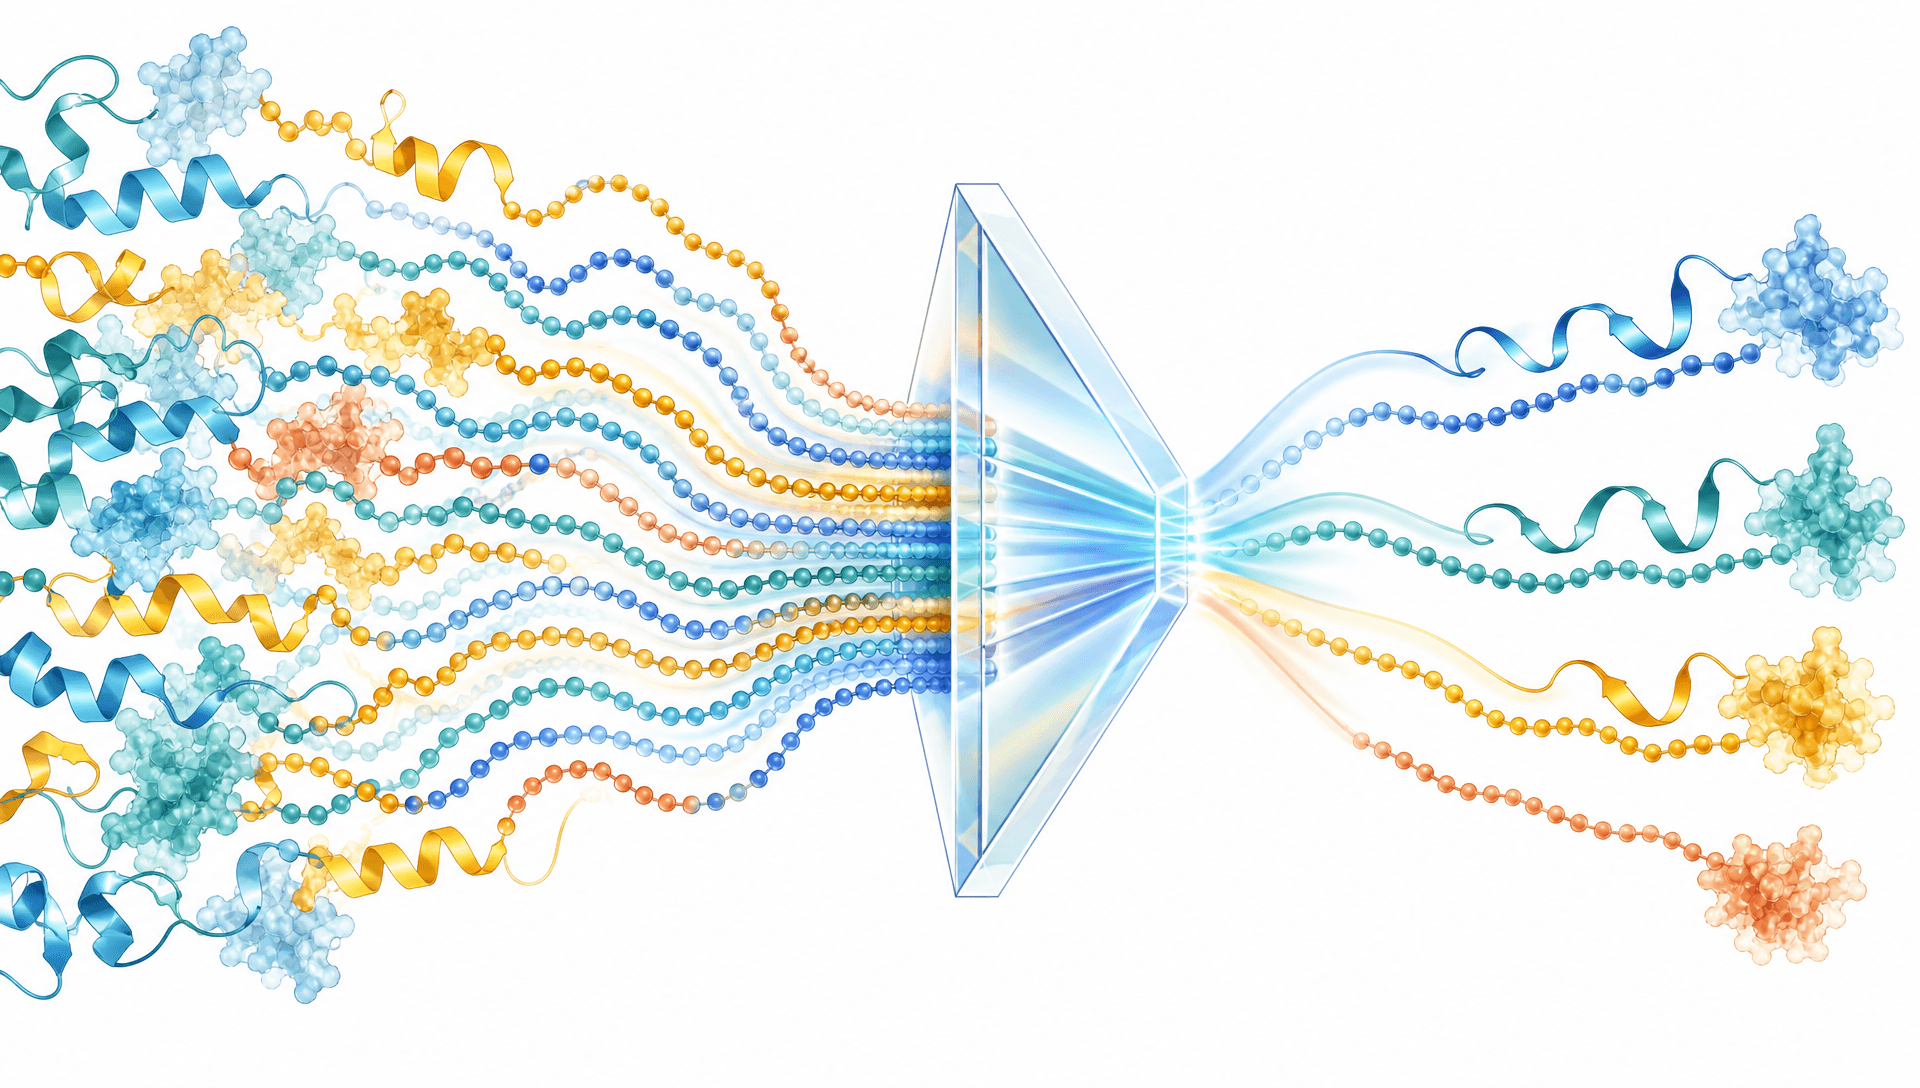
彩色序列流经筛选后汇聚为清晰的代表路径
当一个FASTA文件从几百条扩展到几万条,真正拖慢研究的往往不只是计算量,而是同一或高度相似序列被反复统计、训练与解释。蛋白质序列去冗余的价值,在于把“条目很多”转化为“信息层次清楚”:既减少重复信号,又保留每条原始记录如何归入代表序列的证据链,让后续同源检索、功能注释、结构建模和变体设计建立在更可控的数据基础上。
去冗余的核心不是“删多少”,而是“保留什么”
生物数据库中的冗余序列会增加相似性搜索的负担,也可能让某些物种、家族或高频提交来源被过度代表。对机器学习数据集而言,这种不均衡还可能造成训练集与测试集之间的信息泄漏;对蛋白质工程而言,重复候选则会挤占表达、纯化与验证预算。
因此,蛋白质序列去冗余不能等同于简单字符串去重。完全相同的序列可以合并,但高度相似的序列是否应归为一簇,要看研究问题:注释迁移通常关注近邻关系,家族级探索需要更宽的序列空间,而评估模型泛化能力时还要防止同源序列跨数据集分割。真正可靠的输出至少包括代表序列、簇成员清单、阈值、覆盖关系、原始标识符和处理版本。
这也是UniRef思路值得借鉴之处。UniRef100用于组织相同序列及子片段,UniRef90和UniRef50则分别在90%与50%序列一致性层级构建聚类。它们展示的是不同分辨率的数据组织方式,而不是对所有科研项目都适用的唯一参数。阈值应服务于问题,不能先选一个“常用数字”,再让研究问题被动迁就。
蛋白质序列去冗余应先回答三个决策问题
阈值要匹配下游任务
若目标是减少数据库搜索中的完全重复记录,可先处理相同序列;若要构建候选家族或训练数据,则需同时考虑序列一致性、比对覆盖度和长度差异。只看局部高一致性,可能把共享短结构域但整体功能不同的蛋白错误合并;只看全长一致性,又可能遗漏由端部缺失或注释边界差异造成的近重复记录。
代表序列要有可解释的选择规则
“每簇第一条”方便,却不一定科学。更稳妥的代表序列可优先考虑序列完整性、注释质量、异常字符、长度合理性及研究对象范围。若同一簇同时包含不同物种、亚型或结构域架构,应判断这些差异是否正是研究需要保留的生物学信号。
映射关系不能随去重一起丢失
去冗余后的集合适合计算,但原始成员仍承载物种、样本、功能描述和证据等级。保留“成员—簇—代表序列”的映射,才能把下游结果回填到原始条目,检查某个结论是否由单个大簇主导,并在阈值调整后复现实验。

多层相似性网络把蛋白序列组织为嵌套簇
蛋白质序列去冗余的可审计工作流
第一步是统一输入。检查FASTA标题、非标准字符、空序列、终止符、异常短片段与重复标识符,并明确是否保留亚型、前体肽或片段记录。此时不要急于聚类,因为输入定义不一致会把注释问题伪装成序列差异。
第二步是分层处理。先识别完全相同序列,再基于项目目标测试多个一致性与覆盖度组合。不要只看最终序列数,还要观察簇规模分布、单例比例、不同物种或功能标签是否被不成比例地压缩。
第三步是选择代表并保存成员映射。建议把代表序列FASTA、簇成员文件、参数、软件版本和运行日期作为一组产物保存。蛋白质序列去冗余完成后,还应抽查边界簇:例如长度差异明显、仅局部匹配或注释冲突的成员,确认它们没有被错误折叠为同一生物学实体。
第四步才是进入下游任务。对于只有裸序列的项目,可在MatwingsVenus™(晓鹜™)中先遵循“序列先识别”原则,利用权威数据库检索建立蛋白身份与注释基线;检索得到的数据库信息与计算预测应区分证据属性。这样,代表序列不是分析终点,而是更高质量的检索入口。
把“精简数据”升级为“可解释研究链”
蛋白质序列去冗余常见的失败,不是程序没有跑完,而是结果无法回答“为什么保留这条”。一个可交付的数据集应让合作者快速看懂:采用了什么阈值,代表序列如何产生,哪些成员被合并,哪些边界情况被保留,以及这些选择会怎样影响下游结论。
MatwingsVenus™(晓鹜™)可在这一链路中承接去冗余后的身份核验与多数据库信息检索,围绕蛋白身份、序列、结构和功能信息进行结构化查询。若权威记录不足,平台可在用户确认后衔接功能位点或蛋白属性预测,并将预测结果与数据库实测或注释信息区分呈现。对于研究人员,这种“先检索、再预测、保留证据等级”的顺序,有助于避免把模型输出误写成实验事实。
进一步进入蛋白质工程时,代表序列还可作为候选筛选、功能位点测绘和突变设计的统一起点。MatwingsVenus™(晓鹜™)支持从数据库证据出发衔接功能预测、天然蛋白发现与蛋白质改造等任务;涉及重计算时仍需用户确认,预测结论也需要后续实验验证。平台的价值不在于替代研究判断,而在于把分散的检索、证据分层与后续任务连接成更清楚的分析路径。

序列质控、聚类、映射与下游分析形成连续流程
判断去冗余质量,别只看压缩比例
序列数从十万降到一万看似高效,却不能单独证明结果可靠。建议同时检查代表序列的完整性、簇内一致性与覆盖度、功能和物种分布、边界簇错误率,以及训练集与测试集之间的同源隔离情况。对关键项目,还应在不同阈值下复跑少量下游任务,确认结论是否稳定。
如果去冗余后同源搜索更快,却丢失了稀有亚型;如果模型指标更高,却来自近重复序列泄漏;如果候选更少,却无法回溯原始注释,那么这种“精简”并没有提高研究质量。蛋白质序列去冗余的合格标准,应是数据更小、语义仍完整、决策可复现。
常见问题
UniRef90可以直接作为所有项目的默认阈值吗?
不建议。90%序列一致性是一种常见聚类分辨率,但是否适合取决于研究目标、覆盖度规则、蛋白长度和家族多样性。最好以多个阈值做敏感性检查,再冻结项目参数。
完全相同的序列是否可以直接删除多余记录?
序列本体可以合并,记录信息不应丢失。不同条目可能对应不同物种、样本或注释证据,因此应保留成员映射和原始标识符。
去冗余后为什么还要做数据库检索?
聚类回答“哪些序列相似”,不自动回答“它们是什么、证据来自哪里”。MatwingsVenus™(晓鹜™)可帮助将代表序列接入权威数据库查询与后续分析,使精简后的数据继续保持身份和证据上下文。
总结:让每条保留序列都有理由
蛋白质序列去冗余是一项研究设计工作:先定义问题,再设定一致性与覆盖度规则,随后选择代表序列、保留成员映射,并用边界簇和下游稳定性验证结果。以UniProt和UniRef的术语体系理解非冗余数据,再借助MatwingsVenus™(晓鹜™)连接身份识别、数据库检索与后续蛋白分析,能让“删掉重复”升级为可解释、可回溯、可继续推进的科研流程。
行动建议: 准备好代表序列FASTA、成员映射和项目目标后,可在MatwingsVenus™(晓鹜™)中从身份检索与证据核验开始,逐步规划后续分析。