
什么是Pfam蛋白质家族数据库?它如何帮你读懂蛋白质的“身份标签”?
发布于 2026年11月3日
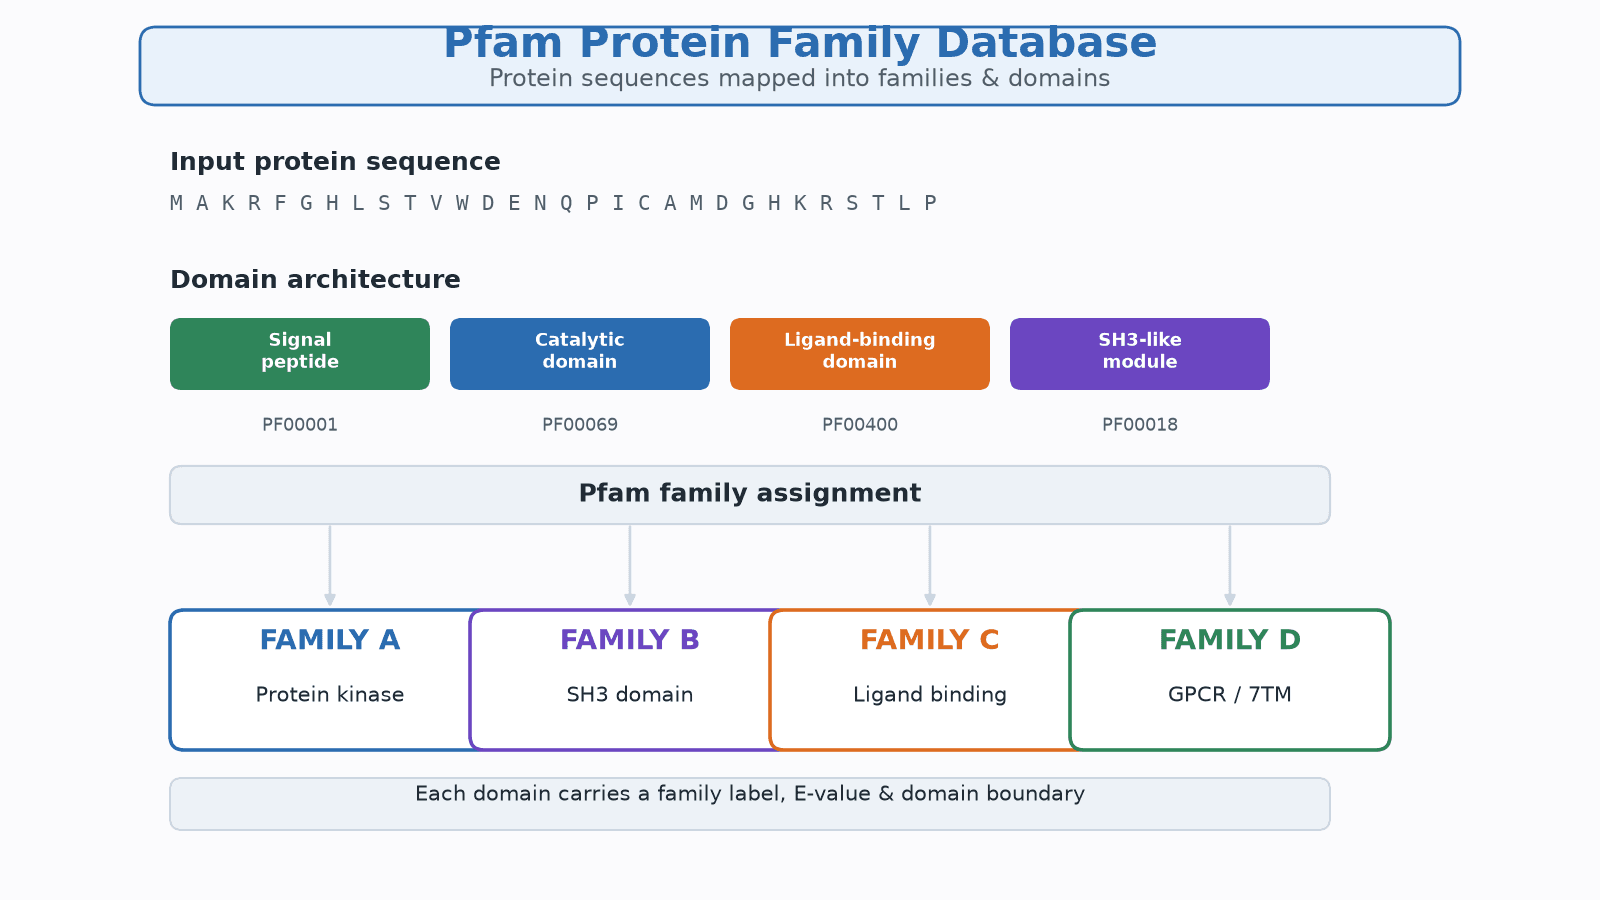
图1 蛋白序列映射到家族与结构域
一句话可摘录结论:Pfam蛋白质家族数据库通过隐马尔可夫模型把蛋白质序列归入已注释的家族与结构域,回答“这条序列属于哪个家族、携带哪些结构域”,是功能注释与蛋白工程的通用地图。
一条蛋白质序列,本质上是一个由几十到几千个氨基酸按顺序排列的字符串。面对一个全新的、未知功能的蛋白质,科学家首先想知道的往往不是它的三维长相,而是:“它是谁?和哪些已知蛋白是一家?” 这正是Pfam 蛋白质家族数据库(Pfam protein families database)存在的意义。Pfam 由 EMBL-EBI 维护运行,自 1997 年发布以来,已成为全球公认的蛋白质家族“户籍登记处”,被实验生物学家、结构生物学家、计算生物学家和进化生物学家共同使用。
为什么说它是“身份证”? 因为在漫长的进化里,许多蛋白质共享相似的功能或结构片段,我们称之为同源(homologous)。把这些同源序列归为一个个“家族”,科学家就能借助已知家族的知识,快速推断未知蛋白的功能、结构域组成和进化来历。Pfam 做的,正是为这些家族建立可检索的“户籍档案”。
背景与机制:为什么我们需要Pfam 蛋白质家族数据库?
一句话可摘录结论:测序技术让蛋白质序列数量爆炸式增长,而实验验证每种蛋白功能成本过高,于是用序列相似性按家族归并、再借已知家族推断功能,成为蛋白组学时代的必然选择。
序列爆炸与功能验证的鸿沟。 今天,UniProt 参考蛋白组已收录约 7500 万条序列,被 Pfam 匹配过的比例高达 76.2%,其中约 48.6% 的氨基酸残基落在某个 Pfam 家族内。面对如此海量的序列,逐一做实验解析功能几乎不可能;而按家族归并后,一个家族的功能、结构域边界与关键位点可以作为“先验知识”外推到所有成员,极大提升效率。
“家族”是蛋白质进化的单元。 同源蛋白质往往共享一个共同的祖先基因,并在功能或结构上保留相似特征。Pfam 把这些相似序列放进同一个“档案袋”,把档案袋当作可检索的家族单元。这个思路,让序列层面数以亿计的“个体”,被压缩成万级、可管理的“家族”。
数据库解决三个痛点: 一是注释,为未知序列标注家族与结构域;二是比较,跨物种、跨蛋白对比结构域架构;三是外推,把已知家族特性迁移到新成员,指导后续实验与设计。
原理与结构:Pfam 如何工作?隐马尔可夫模型与结构域架构
一句话可摘录结论:Pfam 用“profile 隐马尔可夫模型”为每个家族建立概率模型,模型能刻画每条序列在各位点出现何种氨基酸的概率,因此比简单序列比对更灵敏、更能识别远缘同源蛋白,并可同时输出结构域边界。
Pfam 的核心工具是profile 隐马尔可夫模型(profile HMM)。要理解它,可以打个比方:想象一位“记谱人”,他为每个蛋白质家族记下一条“概率谱”——在每个位置上,家族成员更可能出现哪些氨基酸、更愿意插入还是跳过某段。这条“谱”就是 HMM 模型。
模型的三类状态。 一个profile HMM 包含三类状态:匹配态(Match, M)——正常对齐并发射一个氨基酸;插入态(Insert, I)——允许在家族成员中插入额外残基;删除态(Delete, D)——允许某些成员缺失这段。每个匹配态都有一套发射概率,描述该位置出现各氨基酸的可能。当一条序列与模型比对时,算法会在这些状态间“走出一条最优路径”,并给出概率得分。
为什么比BLAST 更灵敏? 普通序列比对只比较两两残基是否相同;而profile HMM 把“这个位置家族通常是什么氨基酸”的统计信息也纳入比较,因此能捕捉那些只有微弱相似性、却同源的长距离关系(remote homology)。这也是 Pfam 能识别远缘同源蛋白、并做系统分类的原因。
Pfam-A 与 Pfam-B。 Pfam 分为两部分:Pfam-A 由人工精心整理、质量高,每条都有稳定编号(如PF00001)与核对过的比对;Pfam-B 由算法自动聚类生成、质量较低,用于扩展覆盖面。此外,clan(氏族) 把同属一个进化起源的多个家族进一步归组,帮助理解家族间的亲缘关系。
结构域架构(domain architecture)。 蛋白质常由多个模块化“结构域”拼接而成。把一条序列逐一比对到 Pfam 的模型库,就能标出它携带哪些结构域、在什么位置、按什么顺序排列,这就是它的“结构域架构”。

图2 三维状态HMM模型判定家族归属
测定与选型:如何用HMMER 搜索 Pfam?结果怎么读?
一句话可摘录结论:用HMMER 的工具 hmmscan 把一条序列扫过整套 Pfam-A 模型,即可得到每条命中家族的 E 值与得分,再结合 gathering threshold 判断“是否真的属于该家族”,从而完成结构域注释。
工具是HMMER。 HMMER 是运行 profile HMM 搜索的软件套装。当前主流版本 HMMER3 相比早期版本快约 100 倍,且因默认使用 forward 算法而更灵敏。常用命令有二:`hmmsearch`——拿一个 HMM 模型去搜序列库;`hmmscan`——拿一条序列去扫 Pfam 的模型库,这是做结构域注释最常用的方式。
执行流程。 下载Pfam-A.hmm 并构建索引后,对目标序列运行 `hmmscan`,输出通常包含:命中的 Pfam 家族编号与名称、比对得分(score)、E 值(E-value) 以及结构域边界。E 值越小,说明这条序列与该家族模型匹配越“出乎意料地好”,即越可能是真成员。
怎么判读? 单看E 值不够,还要结合每个家族人工设定的gathering threshold(汇聚阈值)——超过它才被判定为家族的真成员。同一个 clan 内若出现多个重叠命中,通常只保留最显著(E 值最小)的那个。读懂这些指标,才能避免把“偶然相似”误判为“同属一个家族”。
指标 | 含义 | 通俗理解 |
Family / Accession | 命中的家族与编号 | 对应的“家族档案袋” |
Score | 模型比对得分 | 匹配强度的量化 |
E-value | 期望值 | 越小越可能真匹配 |
Domain location | 结构域边界 | 命中片段在序列中的位置 |
Gathering threshold | 汇聚阈值 | 真成员的判定门槛 |
条件与工艺:Pfam 在蛋白工程与序列分析中的应用流程
一句话可摘录结论:一条序列经Pfam 注释可得到家族与结构域,随后映射到功能位点与保守残基,再结合结构信息,形成“序列→家族→结构域→位点→设计”的蛋白工程闭环。
Pfam 的价值不止于“贴标签”,更在于它把蛋白质拆解成可操作的功能单元,为下游工程提供骨架。
1. 输入序列:拿到待研究的蛋白质或翻译得到的肽段序列。
2. 家族与结构域注释:用hmmscan 扫 Pfam,确认它属于哪个家族、由哪些结构域组成。
3. 功能位点映射:借助家族内已知的保守残基、活性位点信息,把家族知识落到具体位置。
4. 跨蛋白对比:比较不同蛋白的结构域架构,判断功能模块的异同。
5. 进入设计:把解析出的家族/结构域信息作为约束,指导定点突变、结构域重排或全新蛋白设计。
射频/工业应用中的价值。 在酶工程、工业催化、抗体或结合蛋白开发等场景中,先做家族与结构域注释,能帮助研究者锁定催化核心、识别可工程化的表面位点,避免在不影响功能的区域做无效改动。

图3 序列到家族结构域再到工程设计
当Pfam 家族知识遇上 AI 蛋白工程:MatwingsVenus®(晓鹜®)如何衔接?
一句话可摘录结论:MatwingsVenus®(晓鹜®)把 Pfam 这类家族/结构域知识与机器学习结合,将“归属哪个家族、携带哪些结构域、保守位点在哪”作为先验约束,融入其蛋白设计与功能预测流程,让设计更有据可依。
蛋白工程正在从“经验试错”走向“数据驱动”。Pfam 提供的家族归属与结构域注释,正是这类数据管道中稳定、可解释的“结构化先验”。
· 家族先验:明确目标蛋白属于哪个家族,可框定可行的功能范围,减小搜索空间。
· 结构域拆解:识别模块化结构域,便于做结构域级重组、拼接或移植。
· 保守位点约束:将家族内高度保守的残基作为功能关键点,在设计时优先保留,降低破坏功能的概率。
· 可解释的回溯:Pfam 注释本身自带概率与阈值,能为 AI 模型的预测提供可解释的“证据链”,而非黑箱输出。
MatwingsVenus®(晓鹜®)的 AI 蛋白工程工作流,会将 Pfam 所标注的家族/结构域作为输入特征之一,与结构预测、功能预测相结合,产出既符合进化规律又面向应用需求的候选蛋白。需要说明的是,关于平台具体模型的细节与指标,请以官方最新资料为准。
FAQ:Pfam 蛋白质家族数据库常见问题
FAQ1:Pfam 和 InterPro 是什么关系?
Pfam 是 InterPro 的核心成员数据库之一,InterPro 把 Pfam 与 PROSITE、HAMAP 等签名数据库整合,提供更全面的蛋白序列分类与功能注释。
FAQ2:Pfam-A 和 Pfam-B 有什么不同?
Pfam-A 由专家人工整理、质量高且编号稳定;Pfam-B 由自动化聚类生成、质量较低,主要用于扩展覆盖面。
FAQ3:Pfam 能直接告诉我蛋白质的三维结构吗?
Pfam 本身不直接提供实验结构,但它已为多个蛋白家族发布基于深度学习的预测结构,可大幅缩小结构解析的候选范围。
FAQ4:Pfam 数据库如何访问?
Pfam 现在通过 EMBL-EBI 的 InterPro 网站与 API 访问,也提供 FTP 下载整套模型与数据,方便批量注释。
总结
一句话可摘录结论:Pfam 以 profile 隐马尔可夫模型为核心,为蛋白质建立可检索的家族档案与结构域注释,是连接“序列”与“功能”的桥梁,也是现代蛋白工程的起点。
从序列到家族,从家族到结构域,从结构域到功能位点——Pfam 把复杂多样的蛋白世界整理成一张清晰的地图。对任何想读懂蛋白、改造蛋白的团队而言,Pfam 都是值得先掌握的基础设施。当它与 AI 蛋白工程结合时,这张地图正在从“被动注释”走向“主动设计”。
