
Pfam结构域查询教程:如何从序列定位蛋白功能模块?
发布于 2026年11月9日
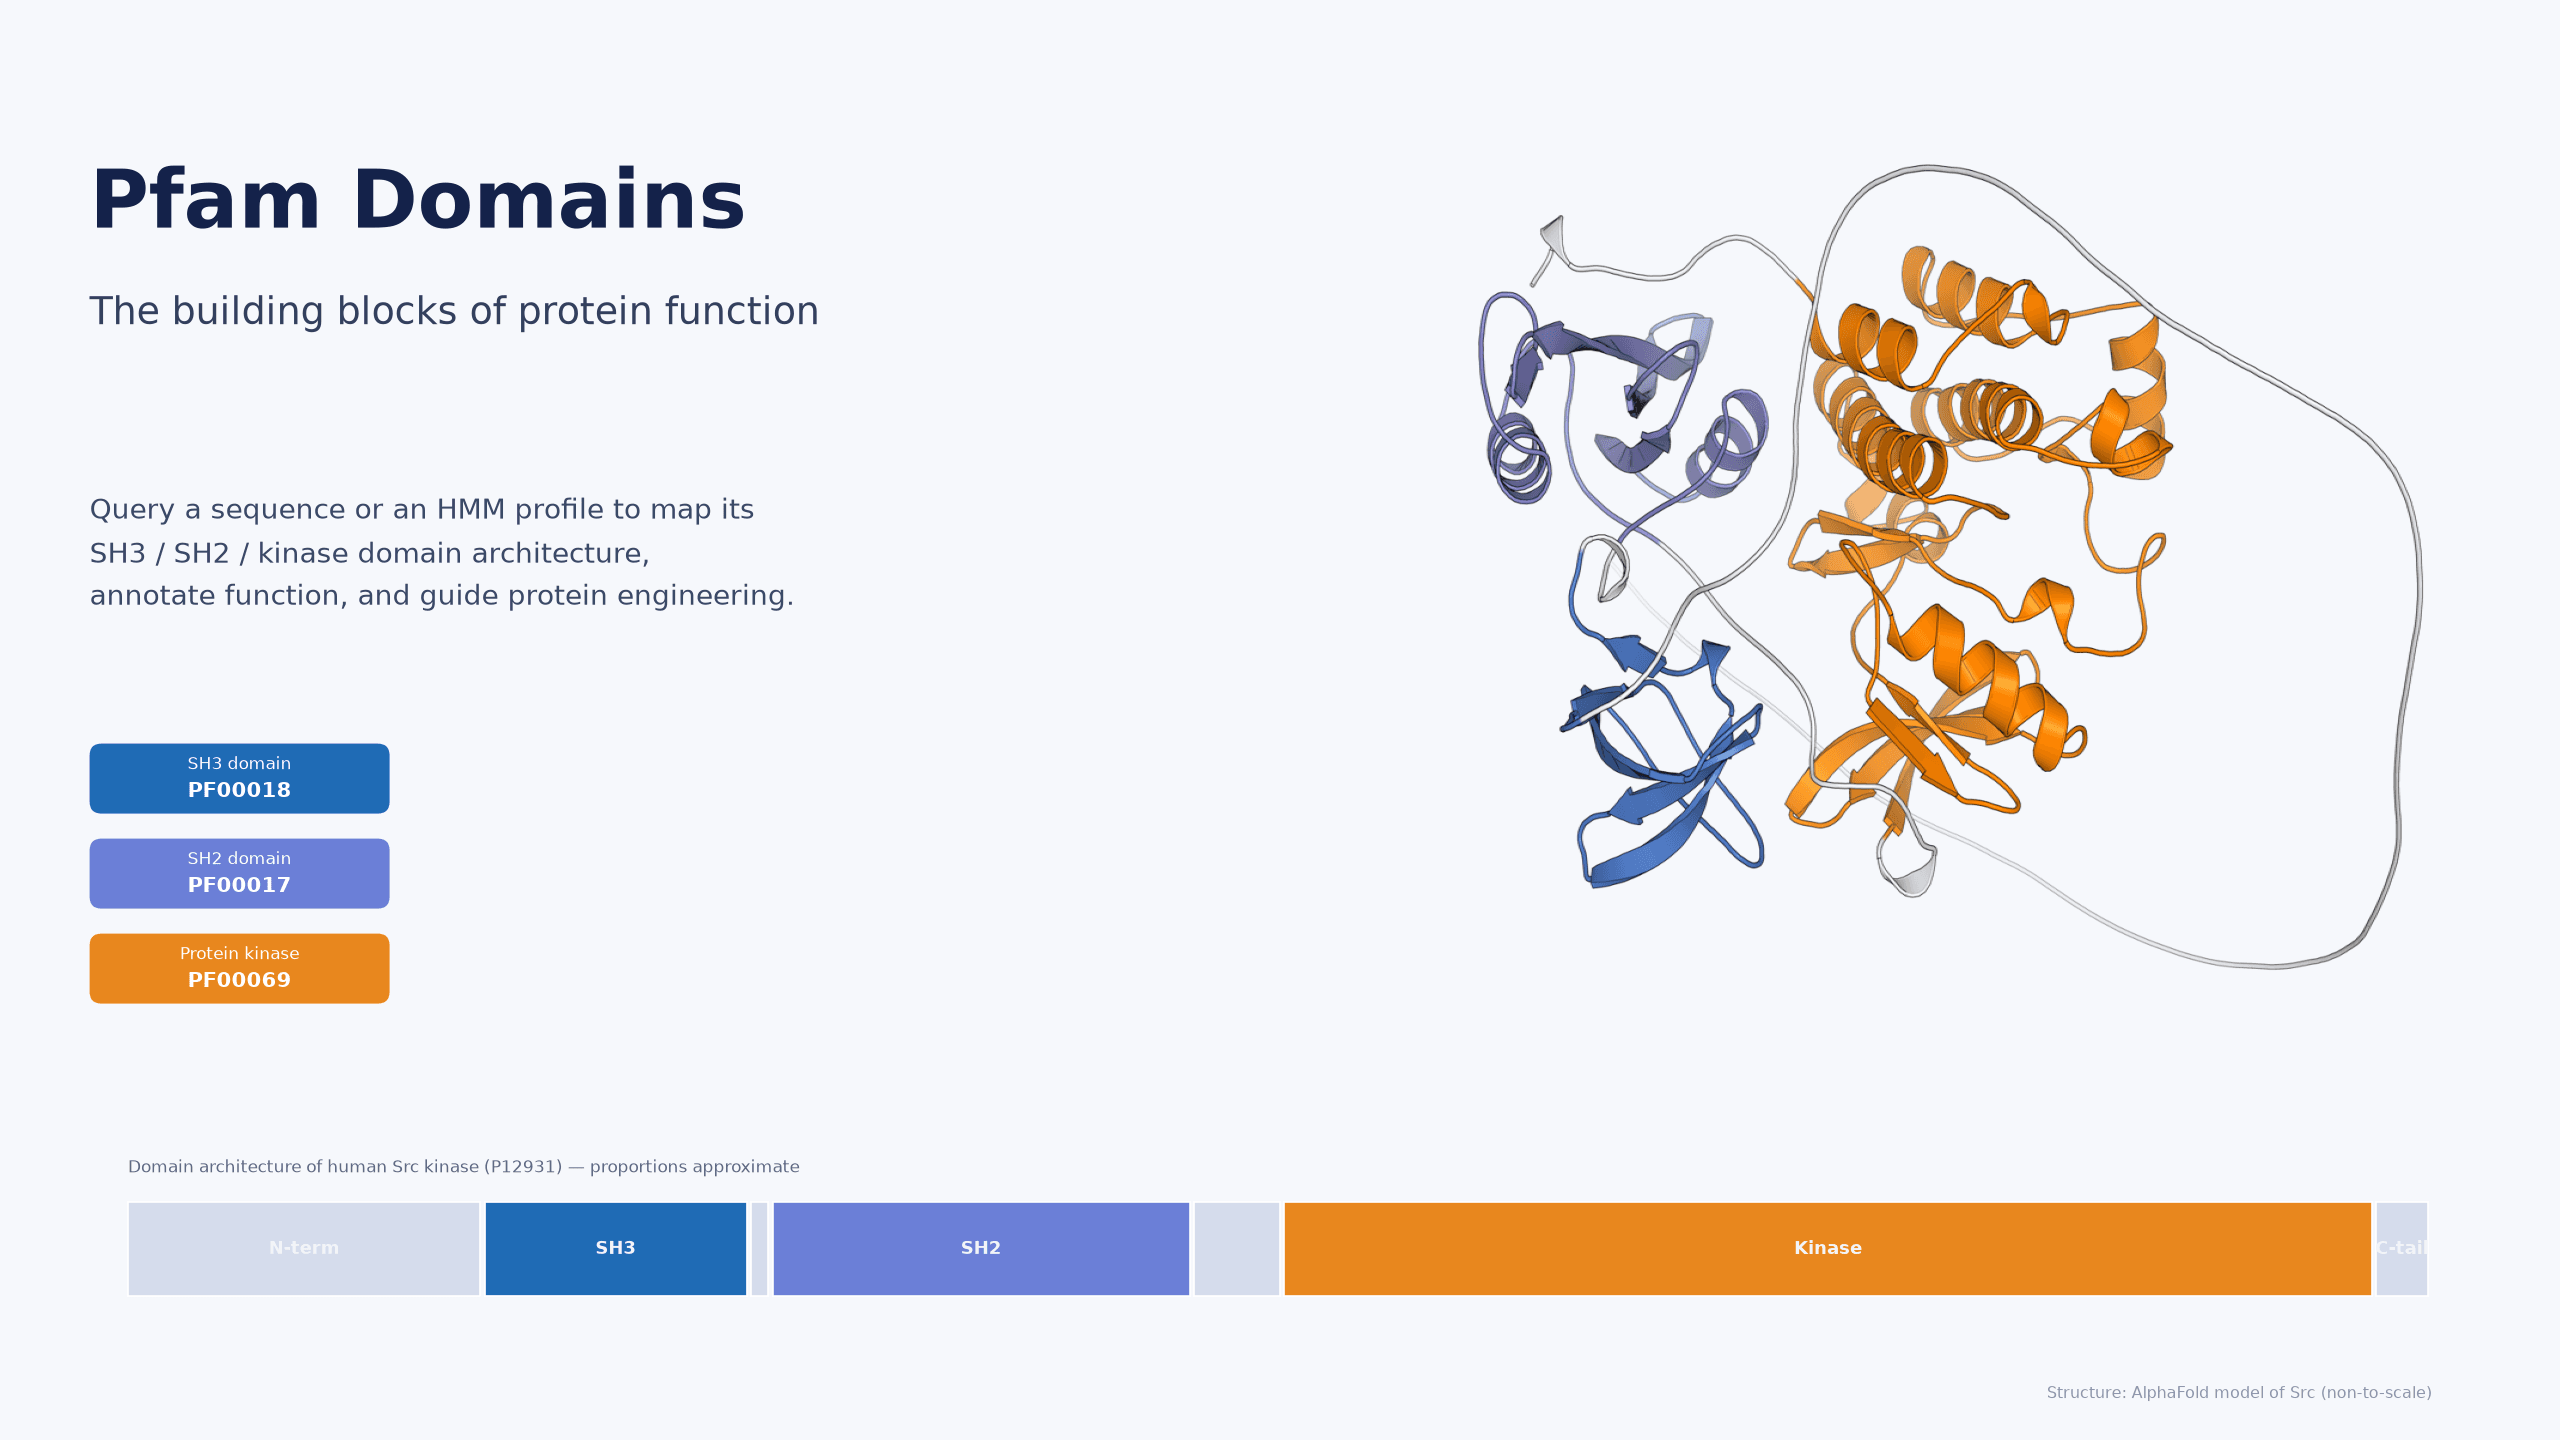
图1:蛋白质由可识别的结构域模块组合而成
蛋白质并非一团无序的多肽,而是由一个个相对独立、可重复使用的「结构域(domain)」拼接而成。一个结构域往往承担一项可识别的功能——比如识别磷酸化位点的 SH2、结合富含脯氨酸序列的 SH3,或催化磷酸转移的 Kinase 结构域。只要明确一条蛋白序列由哪些结构域组成(域架构),通常就能快速推断它可能参与什么过程、结合什么配体、发挥什么功能。
Pfam 正是全球最常用的「结构域字典」:它把大量同源蛋白的多序列比对整理成一张张隐马尔可夫模型(HMM),再用这些模型去「扫描」任意一条新序列,告诉我们这条序列上每一个位置属于哪个家族。今天这篇教程,就带你完整走一遍 Pfam 结构域查询流程。
背景:为什么「蛋白质 = 结构域的组合」?
一条成熟的蛋白序列,通常可以沿主链切分成若干自主折叠、独立进化的模块。进化会「复用」这些模块:同一个 SH3 或 SH2 结构域,会以不同的组合出现在完全不同的蛋白里。因此,结构域是功能的最小可解释单元。
· 结构域有相对稳定的三维骨架与识别面,可与特定配体或底物打交道;
· 结构域的组合方式(域架构)决定了蛋白的「逻辑」——先结合谁、再催化什么;
· 单点突变若落在关键结构域(如催化核心、结合界面),往往直接影响活性与特异性。
理解了这一层,你就明白为什么「结构域查询」如此重要:它把一条陌生序列,翻译成一段人类可以阅读、也可以工程改造的功能描述。
原理:Pfam 家族、HMM 模型与 Clan(结构域体系)
Pfam 的核心资产是一套经过人工校对的「家族(family)」模型。每个家族由一条种子比对出发,训练出一个profile HMM——它记录了每个位点对 20 种氨基酸的偏好、插入与删除概率。用 HMMER 的 hmmscan 把查询序列与整个 Pfam 库比对,就能得到「哪一段序列、与哪个家族、以多强的置信度匹配」。
需要区分几个概念:
· Pfam-A(curated):经人工审核、拥有稳定编号(如 PF00017 SH2、PF00018 SH3、PF00069 Pkinase),是主注释来源;
· Pfam-B:未手工注释的自动聚类,作为补充(通常不用于正式功能注释);
· Entry 类型:Family(家族)、Domain(结构域)、Repeat(重复)、Motif(基序)、Disordered(无序区)等;
· Clan(族):把进化上相关、结构相似的一组 Pfam 条目归为一类,用于在更广层面理解亲缘关系;
· 非严格依赖:自 2022 年起 Pfam 的注释托管于 InterPro,InterPro 还会整合 SMART、PROSITE、CATH-Gene3D 等成员库,因此同一处结果往往比单一 Pfam 更全面。

图2:查询序列与 Pfam 的 profile HMM 比对
查询:从一条序列到完整域架构
以人源 Src 激酶(UniProt:P12931)为例,完整走一遍查询流程:
1. 获取序列。复制蛋白的氨基酸序列(FASTA 格式),或直接用 UniProt 的登录号。
2. 选择入口。打开 InterPro 主页,使用「Search by sequence」;也可以直接用「Search by text」或「Search by Domain Architecture」按家族编号/域架构检索。
3. 勾选成员库。在应用配置里只勾选 Pfam(或保留全部 InterPro 成员库以获得更全结果),提交 InterProScan。
4. 读取结果。得到一个个「hit」:家族编号(PF00017)、名称(SH2 domain)、匹配区段(151–248)、E-value、覆盖度,以及该家族所在 Clan。
5. 归纳域架构。把命中按 N→C 顺序拼起来,就得到该蛋白的域架构——对 Src 即 SH3 | SH2 | Kinase。
6. 交叉验证。回到 UniProt 的「Family & domains」视图,与 InterPro/Pfam 注释互相对照。
进阶查询:如果你更关心「哪些蛋白同时含有某几个结构域」,可用 Search by Domain Architecture,指定包含/排除的 Pfam 条目,快速筛出具有特定「域组合」的蛋白集合——这在做同功酶挖掘、蛋白工程母本筛选时非常实用。
参数与判读:E-value、覆盖度与家族类型
拿到结果后,怎么判断一条 hit 是「靠谱」还是「弱命中」?主要看三个量:
· 期望值:随机情况下出现同等或更好匹配的期望次数,越小越显著。惯例上,E-value < 0.01 常被认为可靠;结构性/功能性的强命中往往低到 1e-5 甚至更低。
· 覆盖度:查询序列被该结构域模型覆盖的比例。覆盖度过低,可能是片段或只匹配到模型的一部分,需谨慎。
· 家族类型:Family/Domain 通常更「硬」,Motif/Repeat 更敏感但更易误报;标注一条蛋白时,优先采信 Family/Domain 级命中。
Pfam 还提供每家族的 gathering threshold(GA)——不同家族对「可信命中」的阈值不同,是比统一 E-value 更精细的判据。若你只想要「整条序列覆盖、无误报」的结果,可把阈值收紧、并检查是否只命中了一个结构域的局部。
判读提醒:E-value 与覆盖度是模型计算的结果,用于判断「是否匹配」,不等于「该结构域一定具有某生物学功能」。功能赋值仍需结构和实验证据;本教程涉及的结构图基于 AlphaFold 模型,属计算模型,非实验测定结构。
MatwingsVenus®(晓鹜®)赋能:从域注释到工程闭环
结构域注释不只是「读懂」,更是工程的起点。MatwingsVenus®(晓鹜®)把「域注释—AI 设计—湿实验验证」串成一条闭环:
· 域驱动的功能解读:先在 InterPro/Pfam 层面定位催化核心、结合界面与关键残基(如激酶的活性中心),为后续设计提供「可解释」的锚点;
· AI 定向进化与序列设计:基于域边界与保守位点,用 AI 生成/优化候选序列,减少盲目筛选;
· 干湿闭环:序列设计与表达/活性/亲和力测定反复迭代,注释信息与实测数据回流,持续校准模型;
借助这条闭环,研究者可以把「结构域查询」从一次性的资料查阅,变成持续产出高活性、高稳定性候选分子的工程流程。

图3:从「输入序列 → Pfam 搜索 → 域架构注释 → 工程应用」到干湿闭环的完整流程
相关产品 / 服务
· 湿实验验证与表达服务:wet-lab 实验中心 —— 完成域注释后的表达、纯化与活性测定。
· 专家咨询与联合设计:expert-center 专家中心 —— 蛋白工程方案与结构域解读。
· AI + 实验闭环平台:dry-wet closed-loop 干湿闭环平台 —— 从序列到候选分子的端到端流程。
常见问题
Q1:Pfam 和 InterPro 是什么关系?
Pfam 是结构域/家族数据库,自 2022 年起其注释托管于 InterPro;InterPro 是整合了 Pfam、SMART、PROSITE、CATH-Gene3D 等多成员库的蛋白分类与注释入口。直接用 InterPro 的「Search by sequence」即可调用 Pfam。
Q2:我只想知道一条序列属于哪个家族,最快怎么做?
把 FASTA 序列粘贴到 InterPro 的「Search by sequence」并提交(可只勾选 Pfam),得到 hit 列表;看最低 E-value 的家族条目,即最可能的归属。
Q3:E-value 多小才算「命中」?
无统一标准。惯例上 E-value 小于 0.01 常视为可靠,功能强命中往往到 1e-5 以下;可结合家族的 gathering threshold(GA)与覆盖度一起判断。
Q4:为什么一个蛋白会命中很多个 Pfam 条目?
因为蛋白往往含多个结构域(多域蛋白),每个结构域各匹配一个家族;也可能有 Motif/Repeat 类敏感命中。看「域架构」而非单一条目,才更接近真实功能。
Q5:如何查询「同时含某几个结构域」的蛋白?
用 InterPro 的「Search by Domain Architecture」,指定需要包含(或排除)的 Pfam 条目,即可筛出具有特定域组合的蛋白集合。
Q6:Pfam 查询结果能直接当作功能证据吗?
不能。Pfam 命中是「序列相似性模型」的结果,用于判断结构域归属;是否真的具有某生物学功能,还需结构、表达与实验证据支撑。
Q7:我的蛋白序列没有命中任何 Pfam 家族怎么办?
可能是全新家族、低同源片段,或比对参数太严。可尝试放宽 E-value、检查是否截短/片段化、或改用结构搜索(Foldseek/结构比对)寻找远源同源。
总结
Pfam 结构域查询,本质上是把「一条陌生序列」翻译成「一段可读、可预测、可改造的功能描述」。掌握 InterPro/HMMER 的查询入口、读懂 E-value 与覆盖度、并把结果组织成域架构,你就拥有了蛋白功能注释与工程化的通用起点。若再把这份注释接入 AI 设计与湿实验闭环,就能把「看懂蛋白」推进到「改造蛋白」。MatwingsVenus®(晓鹜®)的干湿闭环平台,正是为这条路径提供的一站式落点。
声明:本文中涉及的结构图为 AlphaFold 计算模型(非按比例、非实验测定结构);E-value/覆盖度等为模型判定结果,不等同于功能实验证据;具体数值请以您查询的 Pfam/InterPro 版本为准。
