
MMseqs2序列搜索:如何在数亿条蛋白质序列中快速锁定同源序列?
发布于 2026年11月8日
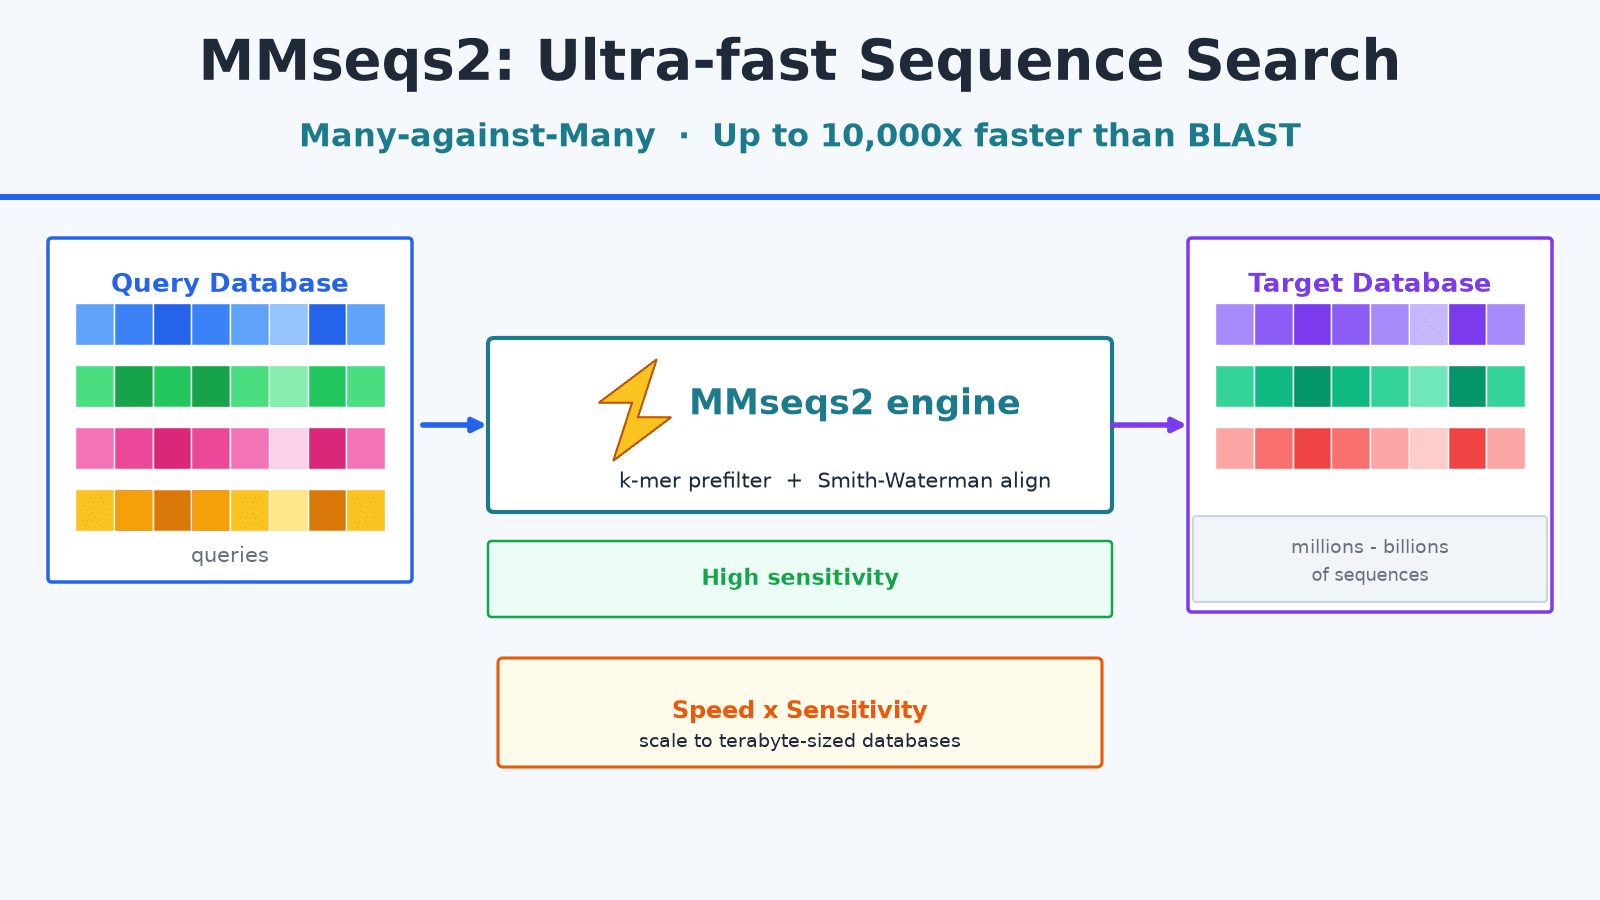
图1 MMseqs2序列搜索概览:多对多快速检索
在生命科学里,判断“这个陌生蛋白像谁、可能有什么功能”,往往要从序列相似性入手。可当数据库膨胀到上亿条序列时,传统工具会慢到难以承受。MMseqs2序列搜索正是为解决这一“规模难题”而生的开源算法:它用“多对多”(Many-against-Many)的思路,把超大规模序列比对从“以天计”压缩到“以分钟计”。
一、背景与机制:为什么需要更快的序列搜索?
当已知蛋白质序列的规模从数千条膨胀到数亿条,逐条两两比对的BLAST式搜索会逐渐变得不可行。MMseqs2序列搜索通过在查询集与目标集之间同时建立索引并成批比对,让大规模同源检索在分钟到小时量级内完成,为功能注释与结构推断提供了可持续的路径。
序列相似性搜索是生命科学里的核心分析之一:把未知序列与已知序列比对,以推断其功能、结构或进化关系。传统BLAST采用的是“查询逐条、目标逐条”的做法,随着数据库变大,计算量快速上升。像UniProt这样的数据库已收录数亿条序列,宏基因组数据更动辄数十亿条。
这就好比在一座藏书数千万册的图书馆里查资料:一本一本翻找显然不现实,需要“索引+快速筛检”。
这类搜索支撑着诸多下游任务:为未知蛋白标注功能、为结构预测积累模板、为进化分析搭建同源网络,它也是大规模功能注释流水线的第一道关卡。
MMseqs2 的名字“Many-against-Many”点出了关键——它不再一次只处理一条查询,而是把一批查询和一批目标同时纳入,通过建立索引做“多对多”搜索。这种思路让它能在普通服务器上处理 TB 级数据库,并被集成到多个大规模蛋白质结构与功能预测流程的同源检索环节中。
二、原理与结构:两阶段流水线如何做到又快又准?
MMseqs2序列搜索的核心是一条两阶段流水线:先用双连续k-mer匹配与无空位比对快速筛出一个小候选集,再对候选序列执行矢量化Smith-Waterman比对。这个“先快筛、后精比”的组合,让它在获得接近BLAST灵敏度的同时,把计算量压缩到原来的几百分之一。

图2 MMseqs2两阶段流水线:预过滤与精比对
第一是预过滤(prefilter)。把查询与目标序列都切成长度固定的“k-mer”(例如k=7的连续短片段),把“双连续k-mer命中”作为相似性的快速判据,再补一次无空位(ungapped)比对打分。只有分数越过阈值的序列才进入下一阶段。这一步就剔除了绝大多数不相关序列。
第二是比对(align)。对通过预过滤的候选做 Smith-Waterman 动态规划比对,并利用 SIMD 指令(如 AVX2/AVX-512)做“矢量化”,一次处理多条序列,进一步提升速度。
k-mer 的长度与“双连续”判定是这里的另一组旋钮:更短的 k-mer 更灵敏但噪音更多,更长则更快却可能漏掉远缘同源;要求相邻两个 k-mer 同时命中,能在不显著牺牲灵敏度的前提下压低误报。mmseqs2 还提供级联式预过滤,以更廉价的粗筛先行,再逐步加严,从而更快逼近全比对的灵敏度。
灵敏度的来源在于迭代profile 模式:MMseqs2 用位置特异性打分矩阵(PSSM)构建 profile,灵敏度可媲美 PSI-BLAST。工程实现上,它以 C++ 编写、遵循 GPLv3 开源,支持多核与多服务器扩展,并要求至少 SSE4.1 指令集。
一句话概括:它并非用牺牲精度换速度,而是用“预筛+精比”把昂贵的全量比对,只留给最可能相似的少数序列。
三、测定与选型:何时该用MMseqs2,如何与 BLAST 权衡?
选MMseqs2还是BLAST,取决于序列规模、可用时间与灵敏度要求:当查询或目标库达到几十万条以上、希望把结果周期从数天压到数小时,MMseqs2通常更合适;而在需要最高灵敏度或核验单条精细比对时,可结合BLAST或迭代profile。
速度与灵敏度的权衡是核心。公开基准显示:在CPU 上,MMseqs2 在保持与 BLAST 相当灵敏度时,可比 BLAST 快出几个数量级(官方资料称特定配置下可达上万倍);在迭代 profile 模式,它能在达到 PSI-BLAST 灵敏度的同时快 400 倍以上。
近年加入的GPU 加速进一步拉开差距:单张 GPU 可比最快的 CPU 方法 BLAST 快约 6 倍,最佳设置(8 张 GPU)下约 17 倍。
· 数据库或查询规模大、追求吞吐——首选 MMseqs2;
· 查询量小,或希望沿用成熟工作流并对单条命中做最严格核验——BLAST 与 HMM 工具(如 HMMER)仍是可靠选择;
· 需要去重或聚类——用 MMseqs2 cluster(及其线性时间聚类 Linclust,官方基准曾用单服务器 10 小时聚类 16 亿条序列)。
关键参数如--sensitivity(灵敏度档位)、--e-value(显著性阈值)、--threads(并行核数)与分块/内存策略,都会在“速度—灵敏度”之间滑动。需要说明的是,不同工具各有落点,“谁更快更好”取决于数据规模与任务,并非孰优孰劣的绝对结论。
四、条件与工艺流程:从原始序列到候选集合的标准化流水线?
把MMseqs2序列搜索用好,通常遵循“建库—预过滤—比对”三步:先用createdb建库,再prefilter做粗筛,最后align精比对;配合--threads并行、--e-value阈值与分段策略控制规模与时间。

图3 MMseqs2在蛋白质发现与工程流水线中的应用
标准化的命令流(示意)为:createdb(把 FASTA 转成数据库格式)→ prefilter(k-mer 相似性打分,得到候选)→ align(Smith-Waterman 精比对);也可用 easy-search 或 easy-cluster 一条命令完成。
资源与环境方面,所需是多核并行、SSE4.1 及以上指令集;大规模任务可借助 GPU(Ampere 或更新)进一步提速;为数据库先建索引,可显著降低后续重复检索的开销。
输出方面,MMseqs2 可生成类 BLAST 的 TSV、ASCII 比对与序列数据库格式,便于批量与下游处理;灵敏度可按档位调节,档位越高越接近全量比对、耗时也越长,适合在不同任务间按需权衡。
结果解读时,主要看显著性(E-value)、序列覆盖度与一致性(identity):数值越小或越高,命中越可信,并应以“检索到的独立同源证据”而非单一分数下结论。工程化上,超大输入需分块,留意内存与磁盘;迭代 profile 与聚类会带来额外成本,需要权衡。
正是这些流程,让“海量序列→同源集合”变得可重复、可追溯,成为下游结构建模、功能注释与模板选择的可靠入口。
五、与MatwingsVenus®(晓鹜®)的结合
在MatwingsVenus®(晓鹜®)的蛋白质发现与工程数据流水线中,超快序列搜索扮演“入场券”角色:为候选蛋白快速建立同源网络、为结构与设计挑选模板,并为海量序列去重,从而把宝贵算力留给更昂贵的三维建模与AI设计。
MatwingsVenus®(晓鹜®)面向蛋白质发现与工程设计,其数据流水线需要一个能吞吐海量序列、又可重复的“同源挖掘”入口。借助 MMseqs2 这类超快检索,平台可以在候选挖掘阶段:
· 为每条候选快速建立同源网络(homolog network),支撑功能与进化推断;
· 从结构数据库挑选合适模板,为后续结构预测与设计提供参考;
· 对宏基因组等超大规模序列做去重与聚类,降低冗余,聚焦多样化的代表序列。
由此把有限算力集中在三维建模、AI 设计与实验筛选等更昂贵的环节,形成“序列→结构→设计→验证”的闭环。具体能力与性能以平台官方信息为准,本文不作未经验证的数据承诺。
六、FAQ
1. MMseqs2 凭什么比 BLAST 快这么多?
关键在于“多对多+两阶段”。MMseqs2 同时处理一批查询与目标,先用 k-mer 预过滤剔除绝大多数不相关序列,再对极少数候选做矢量化 Smith-Waterman 比对;而 BLAST 需要对每条查询逐条扫库。这种“先快筛、后精比”的架构,让它以相近灵敏度获得数量级的速度提升。
2. MMseqs2 会牺牲灵敏度吗?
在默认或较低灵敏度档位下,快速确实可能带来一定灵敏度折损;但同时提供可调的--sensitivity 与迭代 profile 模式,能在达到与 PSI-BLAST 相当灵敏度时仍保持数百倍于其的速度。是否牺牲,取决于你设定的档位,而非工具本身。
3. MMseqs2 只能搜索蛋白质序列吗?
不是。MMseqs2 既支持蛋白质,也支持核酸(nucleotide)序列搜索与聚类。不过它针对蛋白质序列的同源挖掘与 profile 搜索最为成熟,核酸场景可按需结合其它比对工具。
4. 我该用普通搜索还是 profile/HMM 搜索?
若目标是快速、宽泛地找同源,普通搜索(k-mer + Smith-Waterman)已足够;若要捕捉远缘同源、更灵敏,迭代 profile(PSSM)模式通常更优但更耗时。一般策略是先用快速模式粗筛,再对重点候选切换到更灵敏的模式。
七、总结
理解MMseqs2序列搜索的原理、性能与适用边界,能帮你在“速度”与“灵敏度”之间做出合理取舍。作为开源、可扩展的序列相似性检索引擎,它为大规模数据的同源挖掘、去重与功能注释提供了高效底层工具,也为蛋白质发现与工程流水线奠定了快而稳的入口。
回顾要点:多对多、两阶段(快筛+精比)、速度与灵敏度权衡、参数与流程,以及它与MatwingsVenus®(晓鹜®)数据流水线的衔接。一句话——选对工具、调对参数,就能在可接受的时间内拿到可信的同源证据。
