
Evo蛋白质模型到底能做什么?它凭什么“读懂”并“改写”生命指令?
发布于 2026年11月1日
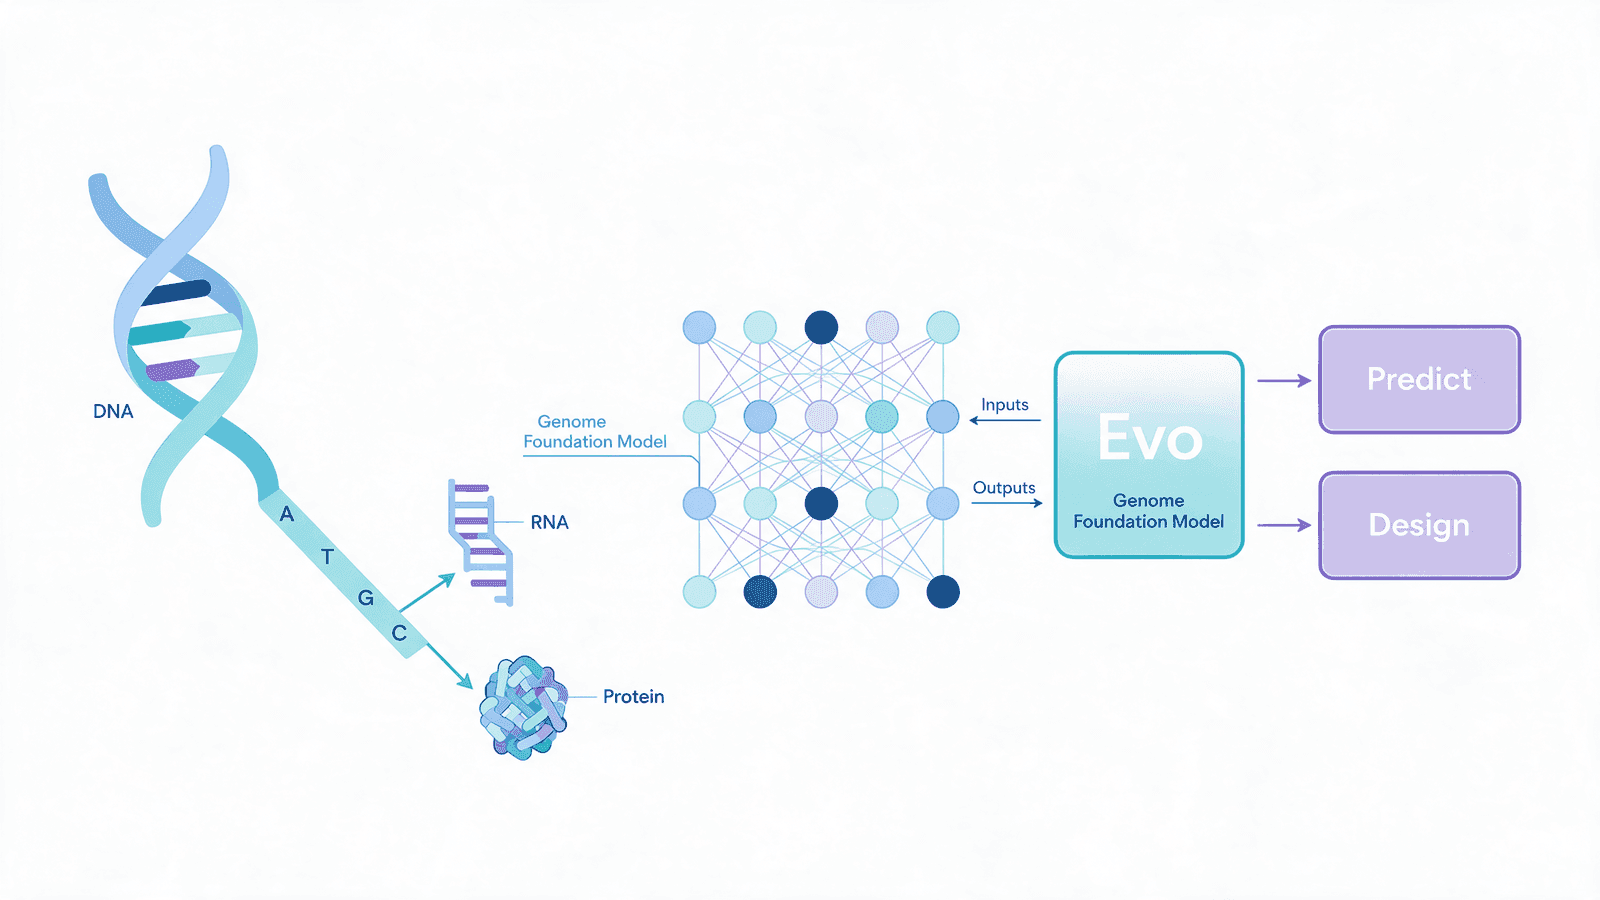
图1 Evo蛋白质模型概念全景:从DNA到预测与设计
【分类】D(AI/算法/平台)
在分子生物学的中心法则里,DNA写下指令、RNA传递指令、蛋白质执行指令。过去,我们只能靠一个又一个实验去解读这些指令的含义;Evo蛋白质模型换了一种思路——把海量基因组当成“语料”,让AI像学语言一样学出生命的“语法”。它把DNA、RNA、蛋白质统一放进同一个序列模型里,既能预测,也能生成。
一、Evo从何而来:为什么需要“基因组级”的AI模型?
Evo蛋白质模型的诞生源于一个判断:生命的程序写在基因组里,而要真正“计算”生命,模型必须看得见整条DNA链,而不只是一段蛋白质序列。
要理解这个判断,不妨对比一下现有工具。
• 传统AI蛋白工具大多只盯住“蛋白质序列”(氨基酸)或“单个突变”,视野止步于单个分子。
• 但很多功能由多个基因、甚至整个基因组协同决定。Evo把建模尺度推向“基因组”,更贴近真实生物系统。
• 一个类比:如果蛋白质语言模型是一个“会写句子”的AI,那么Evo更像“能读会写整篇文章”的AI。读得越多、看得越全,对生命逻辑的理解就越完整。
更深一层,任何一段蛋白序列都不是孤立的。它在基因组里的位置、周围的调控元件、密码子使用偏好,都会影响它的表达与功能。Evo的价值,正是把这种“上下文”装进模型,让设计不再只盯着一个分子。
二、原理与结构:Evo如何以“单核苷酸分辨率”建模DNA/RNA/蛋白?
Evo把DNA的每一个碱基当做一个“字母”,以单核苷酸分辨率处理长达13万甚至100万个碱基的上下文,让模型在DNA、RNA、蛋白质三种“语言”间迁移学习。
这是Evo区别于许多单蛋白工具的核心,也是它“全能”的技术根源。
• 【架构】Evo 1采用混合架构(StripedHyena/深度信号处理),把“卷积”(捕捉局部基序)与“注意力”(捕捉长程依赖)结合,在长上下文下仍保持接近线性的算力与内存扩展。
• 【训练规模】Evo 1:70亿参数、131 kb上下文(131,072个碱基),用270万个原核与噬菌体基因组训练;Evo 2:400亿参数、1 Mb上下文(100万个碱基),用9.3万亿核苷酸、覆盖生命所有域的12.8万以上完整基因组与宏基因组训练。
• 【为何关键】单核苷酸分辨率让模型不只“看”氨基酸,还能理解密码子、基因结构、甚至非编码区。这是它能跨DNA/RNA/蛋白做零样本功能预测的根本原因。
• 【跨尺度】因为见过整条基因组,Evo还能理解“单碱基变化如何影响整个生物体的适应度(fitness)”,为突变评估与序列设计提供基因组级的视角。
• 【开放生态】Evo与Evo 2的模型权重和代码已开源(GitHub、HuggingFace),研究者可直接复现、微调并集成到自己的流程中。

图2 单核苷酸分辨率的混合神经网络架构
三、能力与边界:Evo适合预测什么?又能设计什么?
Evo的能力可概括为“预测”与“设计”两件事:预测基因变体对功能的影响,设计新的蛋白、CRISPR系统乃至完整基因组;但它并非无所不能,边界同样真实。
先看它能做什么。
• 【预测】识别导致疾病的基因突变(variant effect prediction)、评估基因重要性(gene essentiality)。
• 【设计】生成新蛋白与蛋白-核酸复合物、设计功能性CRISPR-Cas基因组编辑器,甚至生成接近真核生物长度的基因组。
• 【协同设计】蛋白-RNA、蛋白-DNA联合设计。这类“跨分子类型”生成,是许多单蛋白工具做不到的。
• 【对工程师的意义】对蛋白工程而言,Evo更像一位“广撒网”的生成器:能快速产出大量多样、可表达的候选序列,把“该试哪几千个”变成“先看模型筛过的几千个”,显著压缩早期实验试错成本。
• 【边界】基准研究提示Evo 2在密码子使用偏好等短程信号上存在“盲区”,并对部分生物学上“中性”的上下文特征敏感。模型生成的是“统计上合理”的序列,不等于“有功能”的序列,最终必须回到湿实验验证。这是审慎使用的前提。
四、落地条件与工艺:如何把Evo用于真实的蛋白工程?
把Evo的“计算”变成“产品”,需要一套工程纪律:明确目标、控制输入质量、做多轮迭代,并最终回到湿实验去验证与筛选。
模型再聪明,落地仍取决于工程方法。
• 【明确任务】是预测功能、找关键位点,还是设计新序列?任务不同,输入与判定标准都不同。
• 【控制输入】给模型的参考序列、物种背景、上下文要准确;生成结果要对齐物理化学约束,而不是只追求“像训练数据”。
• 【迭代闭环】生成→打分/过滤(可用能量、结构合理性等多目标评估)→湿实验验证→把真实数据回喂模型,形成“AI+湿实验”闭环。
• 【组合使用】把Evo用于“大规模序列空间探索”,再结合结构、活性、可开发性评估收敛,比“一次生成、赌运气”可靠得多。
• 【评估指标】评估时要结合“模型打分”与“物理化学约束”:结构合理性、溶解性、热稳定性、可开发性,尽量用多种证据交叉验证,而不是只看单一分数。

图3 AI与湿实验闭环的蛋白工程流程
五、连接MatwingsVenus®(晓鹜®):AI+湿实验闭环的工程化实践
MatwingsVenus®(晓鹜®)把Evo这类开源基因组基础模型视为“序列探索发动机”之一,强调“计算设计—湿实验验证—数据回喂”的工程化闭环,而非依赖单个模型的单次输出。
这是基础模型走向真实产品的关键一环。
• 【平台定位】MatwingsVenus®(晓鹜®)是AI驱动的蛋白智能设计与工艺平台,关注的是把前沿基础模型的能力真正落到“可生产”的候选序列与工艺上。
• 【承接链路】序列生成(可用Evo等模型做“广度探索”)→多目标评估(活性、稳定性、可开发性)→湿实验筛选与工艺放大。
• 【说明】具体模型接入与参数以官方信息为准;此处仅描述平台范式与开放生态,不宣称“已内置Evo”。开源模型负责“开阔探索”,专业评估与湿实验负责“收敛落地”,二者互补。
FAQ:关于Evo蛋白质模型
Q1:Evo和AlphaFold有什么不同?
AlphaFold主要解决“从序列到三维结构”的预测;Evo是序列语言模型,直接在DNA/RNA/蛋白序列层面做预测与生成。两者互补而非替代。
Q2:我能在自己的项目里直接用Evo吗?
可以。Evo与Evo 2的模型权重和代码以开源方式发布(GitHub、HuggingFace),可按需部署;但生成结果仍要按项目目标做评估与湿实验验证。
Q3:Evo生成的序列是“真蛋白”吗?
不是。Evo生成的是“统计上合理、符合演化规律”的序列,属于计算预测;它是否是“有功能的蛋白”,必须以实验数据为准,不能仅凭模型输出下结论。
Q4:用Evo改造蛋白,成功率能保证吗?
不能保证。模型输出的是候选序列,成功率取决于任务复杂度、输入质量与验证设计;业界通行的做法是用“宽探索+多目标筛选+迭代回喂”降低不确定性。
总结
Evo蛋白质模型把“生命语言”变成了可计算的序列,用基因组尺度的数据与单核苷酸分辨率,实现了从突变预测到蛋白/基因组设计的跨越。它的价值不止于“更会生成”,更在于确立了“AI+湿实验”闭环这一范式。真正的落地,取决于能否把预测接回实验、把实验数据喂回模型。MatwingsVenus®(晓鹜®)正是沿着“计算—验证—迭代”链路,把开源基础模型与专业评估、湿实验、工艺放大结合起来,让AI生成的候选序列最终走向可生产。
【一句话结论】Evo蛋白质模型把DNA/RNA/蛋白变成可计算序列,让AI既能预测功能也能从头设计蛋白与基因组。
