
CAZy酶数据库是什么?它如何为碳水活性酶分类?
发布于 2026年11月4日
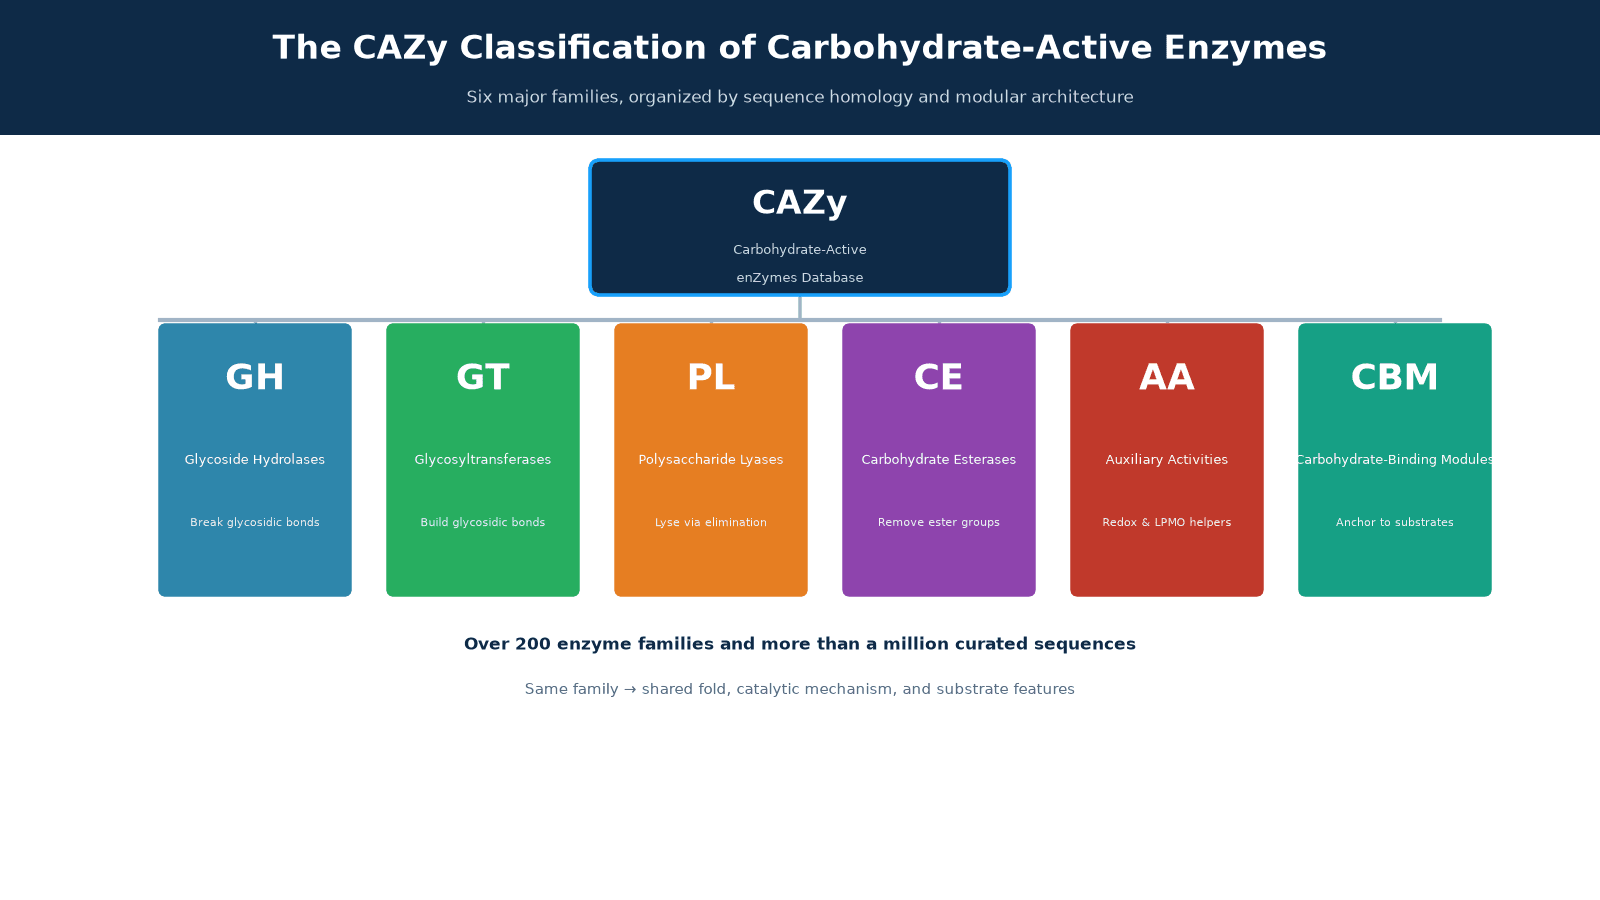
图1 · CAZy 六大碳水活性酶家族分类全景
分类:E 结构/机制/序列分析(主类);D 平台/数据库(跨类)
要研究纤维素、淀粉、几丁质或是任何一种多糖,研究者几乎都会碰到一个名字——CAZy。CAZy 酶数据库(Carbohydrate-Active enZymes Database)把自然界中负责合成、降解和修饰碳水化合物的酶,按它们在进化上的亲缘关系,整理成一张清晰的“家族地图”。有了它,你拿到一条序列,就能快速判断“这是什么酶、它大概怎么工作、能用在哪”。它也把“从序列、到机理、再到应用”的路径,压缩到几步点击之间。
背景与机制:为什么酶学需要一套“家族”分类法?
传统酶学用EC 编号(Enzyme Commission number)给酶命名,依据是“催化什么反应、作用什么底物”。但问题在于:催化同一类反应的酶,在结构和进化上可能毫无关系;反过来,结构相近的酶又可能催化不同反应。EC 编号只能回答“它做什么”,却回答不了“它长什么样、源自哪里”。
CAZy 采用的是一套截然不同的标准——序列同源性。它的源头可以追溯到1991 年,法国科学家 Bernard Henrissat 首次提出“按氨基酸序列相似性给糖苷水解酶分类”的思路,随后由 Henrissat 与 Pedro Coutinho 等人发展成今天公开可用的数据库。
这套“结构优先”的分类法之所以重要,是因为同一家族的酶往往共享折叠方式、催化机理与底物偏好。于是“家族”不再只是一个标签,而变成一种可预测的工具:知道了家族,就能推断酶的大致工作方式。这也是它在工业界被广泛引用的原因——与其从零开始摸索一支未知酶,不如先看它“属于哪个家族”,再顺着家族的机理与底物偏好设计试验。
原理与结构:CAZy 如何按序列同源性给酶分类?
CAZy 的核心依据是氨基酸序列相似性:一个家族内的酶共享保守残基、折叠拓扑与催化机理,因此通过序列比对即可把新酶“对号入座”,反推其催化残基与底物偏好。
CAZy 把“碳水活性酶”分为六大类,各司其职:
• GH(Glycoside Hydrolases,糖苷水解酶):切断糖苷键,是降解多糖的主力,如淀粉酶、纤维素酶、木聚糖酶。
• GT(Glycosyltransferases,糖基转移酶):合成糖苷键,负责“搭建”糖链。
• PL(Polysaccharide Lyases,多糖裂合酶):通过消除反应切断多糖,主要作用于果胶、海藻酸等。
• CE(Carbohydrate Esterases,碳水酯酶):移除糖上的酯基,常与GH 协同工作。
• AA(Auxiliary Activities,辅助活性):参与氧化还原,包括近年备受关注的裂解性多糖单加氧酶(LPMO),辅助降解顽固木质纤维素。
• CBM(Carbohydrate-Binding Modules,碳水结合模块):本身不催化,但能“抓住”底物,帮催化结构域靠得更近。
家族用编号表示(如GH13、GH5、GT2),有的家族还会进一步细分成亚家族(如 GH13_5)。在催化机理上,糖苷水解酶主要走两条路线:保留型(retaining)经过双置换,反应前后异头碳构型不变;反转型(inverting)经过单置换,构型发生翻转。这两条路线的关键催化残基通常是谷氨酸(Glu)或天冬氨酸(Asp),而且在同一家族内高度保守。此外,许多 CAZy 酶是模块化的:一个催化结构域常与一个或多个 CBM 相连,中间由柔性连接肽衔接;这种“催化 + 结合”的组合,是酶吸附并降解不溶性底物(如纤维素)的关键。随着家族不断扩充,研究人员还引入“亚家族(subfamily)”,以便在共享机理的大前提下,进一步区分底物特异性的细微差别。

图2 · CAZy 家族分类与保留型/反转型催化机理示意
测定与选型:如何用CAZy 查询、注释与筛选酶?
查询CAZy 家族只需要一条序列:把它提交到 CAZy 或 dbCAN 等工具做同源搜索,就能得到家族归属、EC 编号与潜在的催化残基,再结合底物特异性与酶活测定,即可判断该酶是否适合目标反应。
具体流程通常是:
• 输入:一条蛋白序列(FASTA 格式),或一个基因组/宏基因组数据。
• 注释:用CAZy 数据库、dbCAN(适合宏基因组的大规模注释)、dbCAN-seq 等工具,对序列做同源比对,输出家族与亚家族归属。
• 解读:结合CAZypedia(配套的“百科全书”)查看该家族的机理、结构与已知代表性酶。
• 选型:家族信息告诉你“可能怎么工作”,接着用活性测定(例如 DNS 法测还原糖)与 pH、温度曲线验证真实活性,再决定是否值得进一步工程改造。
这里有个要点常被忽略:CAZy 家族不等同于 EC 编号。同一家族可能对应多个EC(催化不同反应),反过来一个 EC 也可能分散到不同家族。所以严格来说,家族回答“进化与结构”,EC 回答“反应类型”,二者要结合使用。如果序列来自未培养微生物(如宏基因组),CAZy 注释尤其有价值:它让“看不见”的酶先被归位,再被定向挖掘。当然,自动注释也可能误判,尤其是宏基因组中的短序列,因此关键结论通常要结合结构预测与实验复核。
条件与工艺:CAZy 在工业酶工程中的应用路径
在工业上,CAZy 家族信息能显著缩短酶的筛选与发酵流程:选定目标家族后,可针对底物特异性、热稳定性与 pH 窗口做定向改造,再经发酵放大,投入食品、饲料、生物燃料和纸浆漂白等场景。
这套流程可以用一条主线概括:CAZy 注释 → 底物特异性筛选 → 酶工程改造 → 发酵放大 → 工业应用。
• 生物燃料:纤维素酶、木聚糖酶把木质纤维素降解成可发酵糖,是纤维素乙醇的关键。
• 食品与烘焙、酿造:淀粉酶、糖化酶、葡聚糖酶在制糖、烘焙、啤酒酿造中广泛使用。
• 饲料酶:木聚糖酶、植酸酶帮助畜禽分解抗营养因子,提高饲料利用率。
• 纸浆与纺织:半纤维素酶、果胶酶用于生物漂白、生物精炼,减少化学品用量。
• 洗涤、医药与营养:淀粉酶、糖苷酶进入洗涤剂;糖苷酶也用于制药与益生元等细分市场。
落地时最重要的工艺变量是作用pH、温度、底物浓度与抑制剂。而CAZy 家族恰恰给了你“第一手”线索:它预示了机理与底物偏好,让你在实验前就大致知道该往哪个方向调,减少试错。换句话说,家族信息不只是“分类”,更是工艺设计的输入:知道了作用机理,就能更理性地设定反应条件,也更容易理解酶为何在某一 pH 或温度下失活。

图3 · 从 CAZy 注释到工业酶应用的五阶段流程
把CAZy 与 AI 蛋白工程结合:MatwingsVenus®(晓鹜®)的酶发现思路
把CAZy 的“家族先验”与 AI 蛋白工程结合,能让酶发现从大海捞针变成有据可循:先由 CAZy 家族锁定机理与底物偏好,再用序列-结构-功能建模与定向进化,快速收敛到可工业化的候选酶。
这正是天鹜科技Matwings Technology 旗下 MatwingsVenus®(晓鹜®) 专注的方向——一个以 AI 驱动的蛋白设计与酶工程平台。在这一思路下,一条典型的管线是:
1. 家族定位:用CAZy 注释锁定候选酶的家族与机理;
2. AI 建模:用序列-结构-功能模型预测热稳定性、活性与可开发性;
3. 设计与筛选:结合定向进化/计算设计出突变体,并评估成功概率;
4. 湿实验核验:把计算预测送回实验验证,形成“设计—实验—学习”闭环。
需要强调的是,CAZy 与 AI 都属于“先验”与“预测”,不能替代湿实验:家族归属帮你缩小范围,AI 帮你提高效率,但最终活性与稳定性仍需实验确认。这也是“可解释”与“能力边界”并存的真实状态——对科研与工业用户,这意味着用更少的实验、更快锁定可工业化的候选酶。对研发团队而言,这种“先验驱动 + 计算加速 + 湿实验闭环”的组合,能显著压低盲目筛选的成本;而对可信度要求高的场景,所有计算结果都应以可重复的实验作为最终证据。
FAQ
CAZy 与 EC 编号有什么区别?
CAZy 按序列同源性把酶归入家族,反映的是进化与结构关系;EC 编号按催化反应类型分类,反映的是功能。两者互补,不能互相替代,判断一支酶时常需结合使用。
一个CAZy 家族代表一种酶吗?
不。一个家族往往包含许多来源不同、底物各异的酶;同一家族共享折叠与机理,但底物偏好、最适pH、热稳定性可以差异很大。家族是一个“类别”,不是“单一酶”,更不能把一个家族的编号当作某种特定酶的别名。
如何免费使用CAZy 数据库?
CAZy 官网提供公开检索界面,可按序列、家族、物种或 EC 编号检索;配套的 CAZypedia 是免费家族百科,dbCAN 则适合对宏基因组做大规模自动化注释。多数资源可免费访问,具体授权以官方页面为准。
CAZy 能预测酶的活性位点吗?
可以给出线索,不能直接“给定答案”。通过家族比对与保守残基分析(如糖苷水解酶中保守的 Glu/Asp),可以推断候选催化残基;但要确认活性位点,仍需结构生物学或定点突变等实验验证。
总结
CAZy 是一张按进化关系绘制的“碳水活性酶家族地图”。它把“这是哪种酶、大概怎么工作”变成可查询、可推断的答案,让研究者与工程师在酶发现、注释与改造时少走弯路。当它再与 AI 驱动的蛋白工程平台(如 MatwingsVenus® (晓鹜®))结合,酶学研究的“家族先验”便能转化为更高效的工业化路径。
