
BRENDA酶活性数据查询:从EC编号到动力学参数
发布于 2026年11月9日
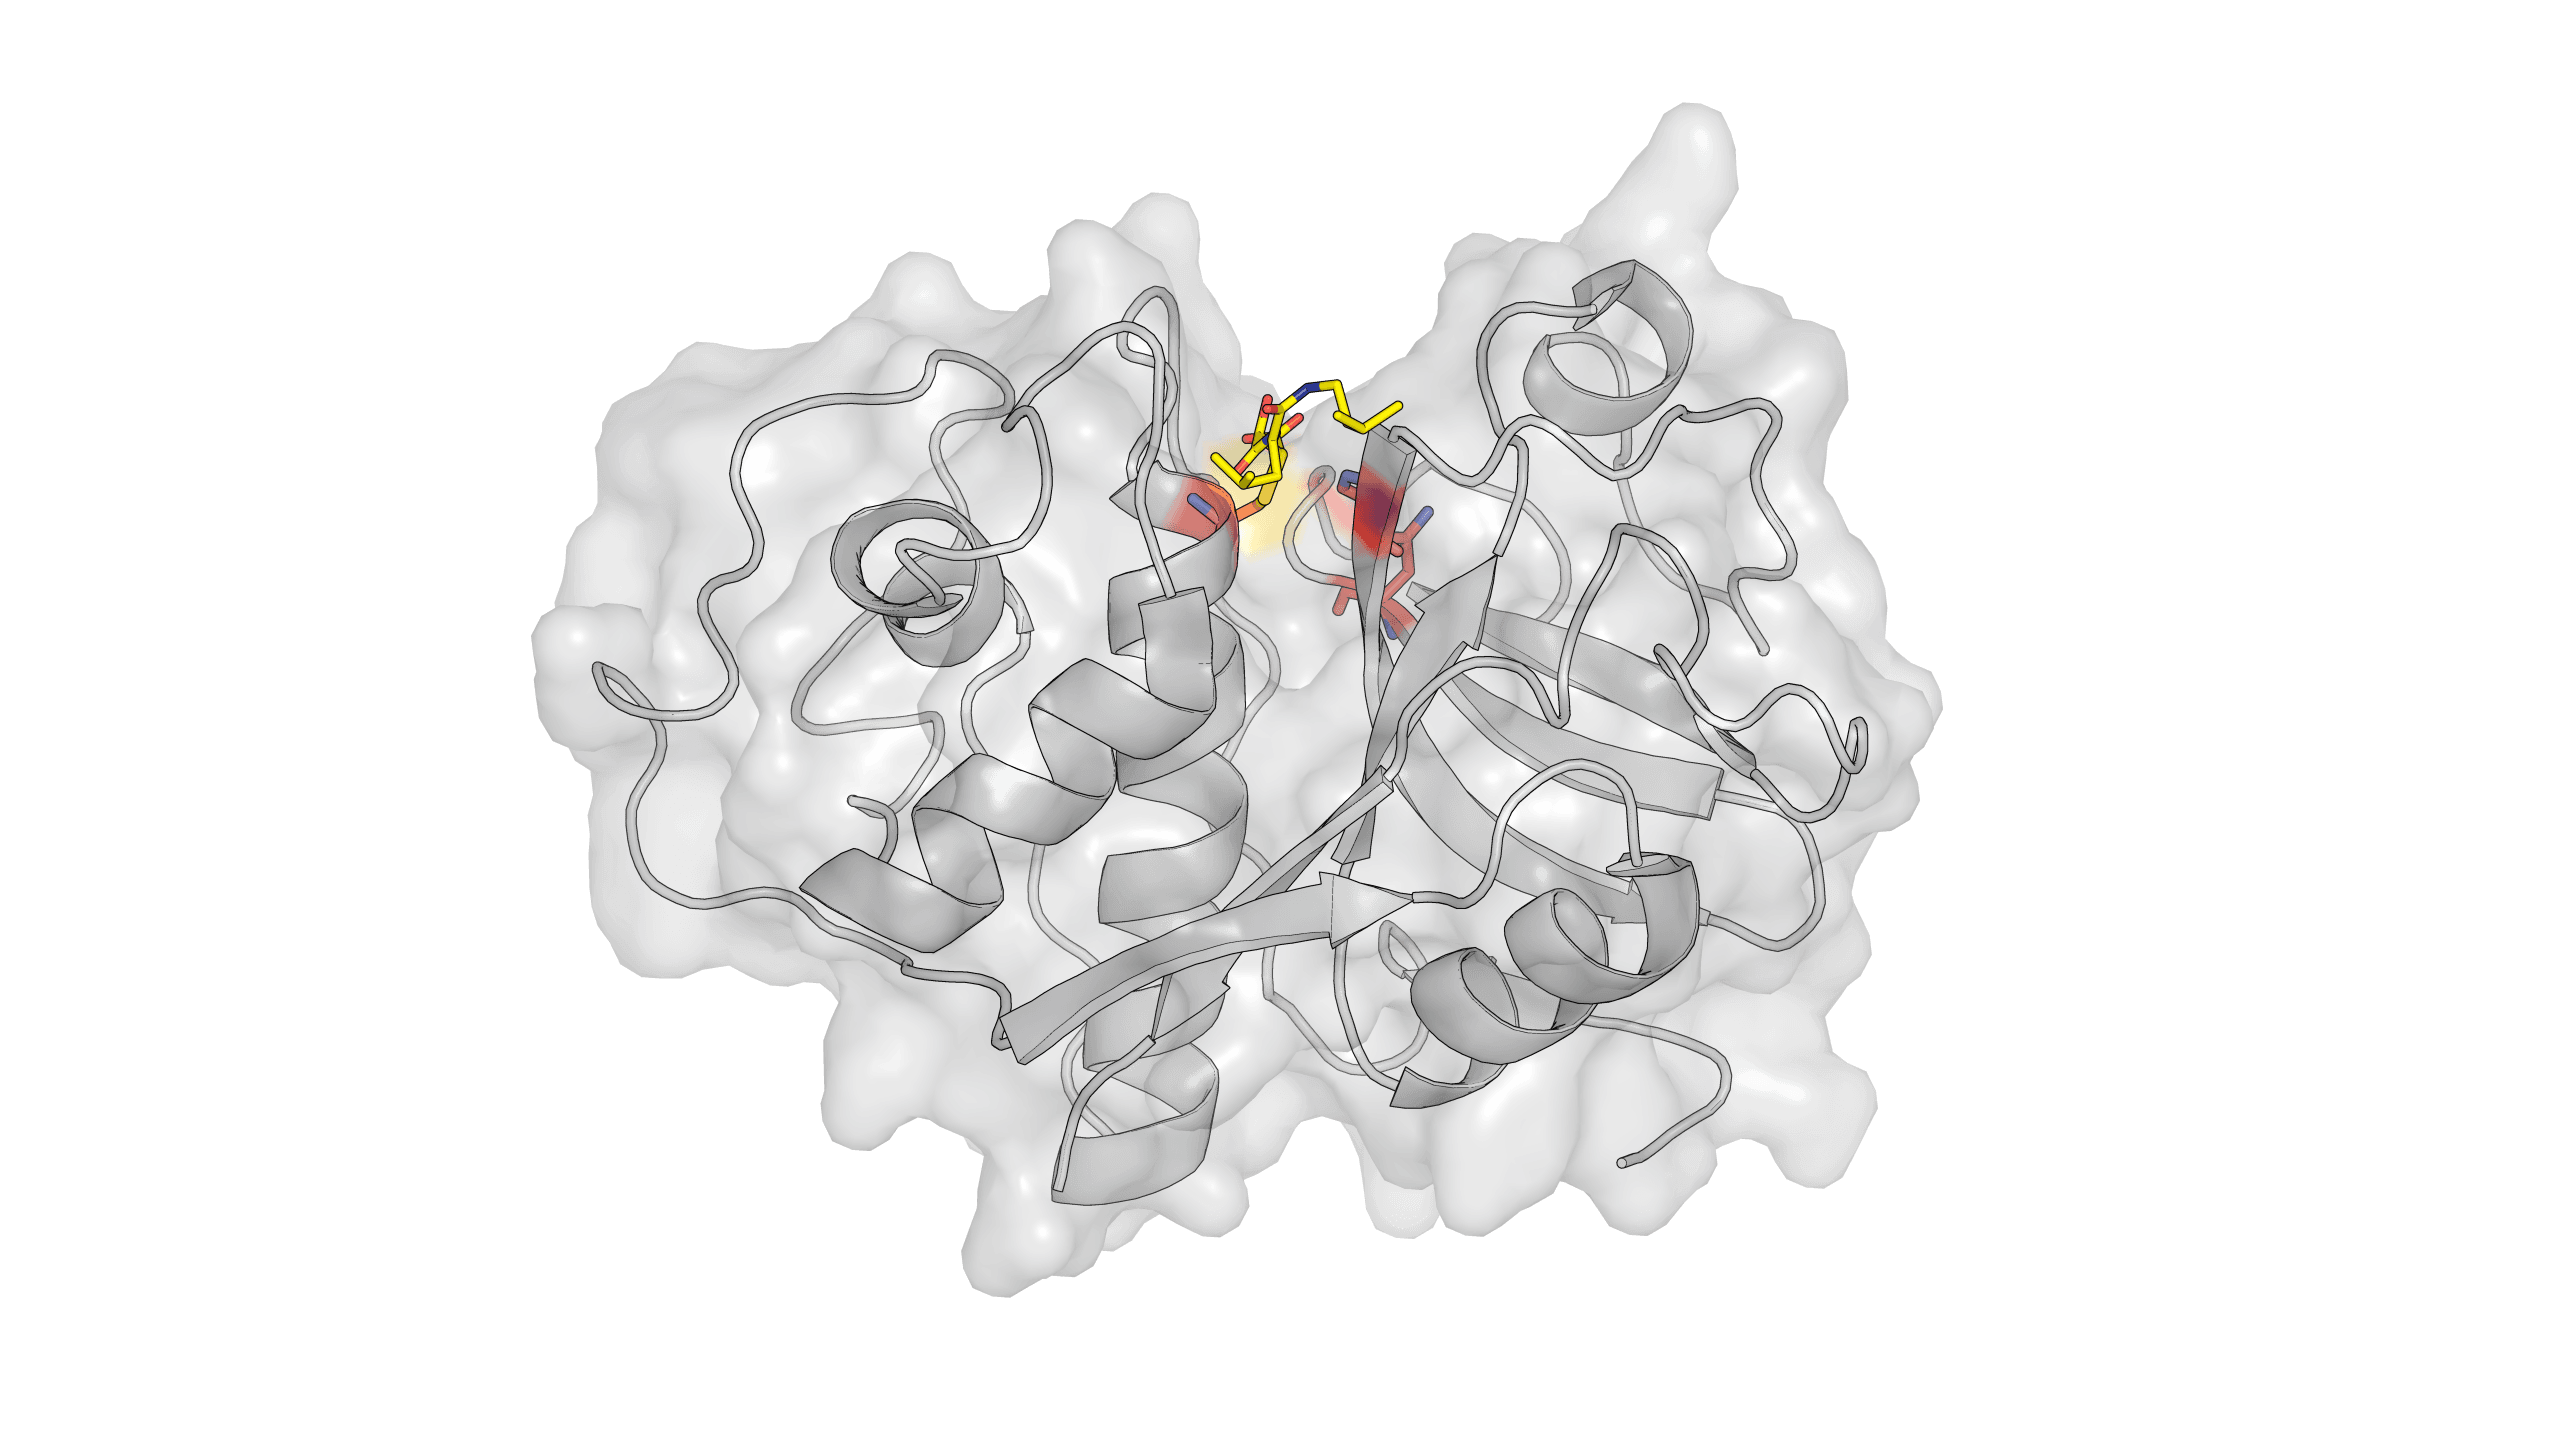
图1|BRENDA酶活性数据查询:从EC编号到动力学参数的概念全景
酶是生物催化的核心。要把一个酶用于科研或工业过程,第一步往往不是"看序列",而是"查数据":这个酶催化什么反应?对哪种底物亲和力最高?反应速率有多快?在什么pH和温度下最稳定?这些问题的答案,集中在一个公开的权威酶功能数据库——BRENDA(Braunschweig Enzyme Database)里。BRENDA酶活性数据查询,就是把"酶的身份"翻译成"可量化的动力学参数",再进一步指导实验设计与工艺优化。
一、为什么需要查询酶活性数据?
在酶学研究与工业生物催化中,酶活性数据是决策的基础。无论是选择一个天然酶、改造一个候选酶,还是设计一条反应路线,都需要先回答几个定量问题:底物特异性如何、催化效率(kcat/Km)有多高、是否被产物或底物抑制、在目标工艺条件下是否稳定。
BRENDA酶活性数据查询的价值,正在于把这些分散在大量文献中的实验数据聚合到一个可检索的数据库。它以EC编号(酶委员会编号,Enzyme Commission number)为骨架,对酶按催化反应类型分类,并记录每种酶在不同生物体、不同来源下的动力学与功能数据。
数据说明:BRENDA为公开维护的酶功能数据库,由德国布伦瑞克工业大学(Technische Universität Braunschweig)开发维护。其数据经文献人工整理与文本挖掘(Text-mining)两条途径汇总。本文涉及的数据库定位与数据字段为公开可核实信息;图中所用示例数值为示意,非来自某一具体BRENDA记录。
二、BRENDA数据库的结构与数据分类
理解BRENDA酶活性数据查询,先要理解它"怎么组织数据"。BRENDA以酶委员会编号(EC number)作为一级分类框架,将酶按其催化的反应类型划分为氧化还原酶(EC 1)、转移酶(EC 2)、水解酶(EC 3)、裂合酶(EC 4)、异构酶(EC 5)、连接酶(EC 6)等大类,再逐级细分到具体的反应。
每个酶条目下,通常关联以下几类功能数据:
• 催化反应:催化的底物与产物、反应平衡、辅因子、金属离子需求。
• 动力学参数:米氏常数Km、转换数kcat、最大反应速率Vmax、催化效率kcat/Km。
• 抑制与激活:抑制常数Ki、半数抑制浓度IC50、激活剂信息。
• 最适条件:最适pH、最适温度、热稳定性、溶剂耐受性。
• 酶学属性:分子量、亚基组成、等电点、细胞内定位。
• 来源与生物体:基因来源、生物体、组织、细胞器。
下面是用一个真实酶结构示意"酶活性数据"中活性位点的含义。下图以半胱氨酸蛋白酶木瓜蛋白酶(papain,EC 3.4.22.2)为例,其催化三联体 Cys25–His159–Asn175 是决定酶活性的关键结构。

图2|木瓜蛋白酶催化三联体Cys25–His159–Asn175(真实结构示意)
图中标注:papain催化三联体Cys25–His159–Asn175(真实晶体结构1PPP,含E64-C抑制剂)。动力学参数(如Km、kcat)描述的是整个酶的宏观行为;而结构数据提示哪些残基参与了催化,二者结合才能理解"活性如何被调节"。
三、如何查询并读取酶活性数据
BRENDA酶活性数据查询的一般路径如下:
1. 确定查询入口:以EC编号为最常用入口;也可用酶名、底物名、产物名或生物体名检索。
2. 锁定目标酶:在结果列表中找到与你体系匹配的酶与生物体来源,注意不同物种、不同同工酶的动力学参数差异很大。
3. 读取动力学字段:查看Km、kcat、Vmax、kcat/Km、Ki、IC50等字段,并注意每条数据对应的底物、pH、温度与测定方法。
4. 交叉校验:同一参数在文献中常有多个数值,因为测定条件(pH、温度、离子强度、底物浓度)不同。优先采用与你目标条件相近的记录,并查看数据来源。
5. 导出与整理:将目标记录导出,整理为结构化的参数表,供建模、对比或实验设计使用。
读取时最重要的是"条件绑定":Km不是一个孤立常数,它绑定在"哪个底物、哪个pH、哪个温度"上。忽略测定条件直接比较不同文献的Km,往往得出错误结论。这一步,正是"数据查询→可用信息"的核心。
四、动力学参数如何指导工艺条件
查询到的酶活性数据,最终要服务于"在什么条件下让这个酶发挥最好"的工艺问题。下图把BRENDA查询的入口、输出的动力学参数,以及它们在酶工程与生物工艺中的落点串成一条链路。

图3|BRENDA酶活性数据查询到酶工程与工艺的流程(示意图,非按比例)
典型应用包括:
• 选型与适配:依据底物特异性与kcat/Km选择最适酶;对比不同来源酶在目标pH/温度下的表现。
• 工艺条件设定:以最适pH、最适温度、热稳定性数据确定反应缓冲液、温度窗口与加料策略。
• 抑制与耐受评估:依据Ki、IC50判断产物抑制或底物抑制风险,指导分批补料或产物移除。
• 酶工程输入:把动力学瓶颈反馈给设计环节,划定需要改造的活性位点或底物通道。
• 测定与质控:以文献动力学参数作为基准,校验自己体系的活性测定是否合理。
需要强调的是:查询数据≠实测数据。来自BRENDA的文献数值属于"已报道数据",其准确性与测定条件绑定;用于自身体系前,应通过实验验证,或与预测值相互佐证,避免直接把文献值当作本体系的真值。
五、MatwingsVenus®(晓鹜®)的作用:让酶活数据落地
查询到酶活性数据,只是认识酶的第一步;真正的价值在于把这些数据转化为可验证的设计、筛选与工艺改进。MatwingsVenus®(晓鹜®)提供"干湿闭环"的酶研发与产品化协同能力:
• 数据到设计:把Km、kcat、Ki等参数与结构、序列信息结合,辅助活性位点与改造位点判断。
• 设计到验证:通过湿实验平台对候选酶进行活性、稳定性与动力学测定,把文献值与实测值对齐。
• 实验到工艺:基于实测动力学与稳定性数据,衔接工艺条件优化,支撑从小试到中试的放大。
• 专家协同:与酶工程、工艺开发专家协作,共同处理数据解读、测定设计与问题排查。
如果你需要把BRENDA查询到的动力学参数落到自己的实验与工艺中,MatwingsVenus®(晓鹜®)的相关能力可以帮助你推进:
• 湿实验与工艺验证
• 专家中心与问题诊断
• 干湿闭环平台
BRENDA酶活性数据查询常见问题
1. BRENDA酶活性数据查询能看到哪些参数?
BRENDA酶活性数据查询通常能获取Km、kcat、Vmax、kcat/Km、Ki、IC50,以及最适pH、最适温度、抑制剂与激活剂信息等,覆盖酶催化反应的功能学特征。
2. 如何用EC编号进行BRENDA酶活性数据查询?
在BRENDA检索框输入目标酶的EC编号(如EC 3.4.22.2),系统会列出该编号对应的酶条目及其来源、动力学与功能数据,再按生物体与底物进一步筛选。
3. BRENDA中的Km、kcat数据可以直接用于我的实验吗?
不建议直接照搬。Km、kcat等参数绑定特定底物、pH、温度与测定方法,不同文献数值差异明显;用于自身体系前应通过实验验证或与预测值相互佐证。
4. 为什么同一个酶在不同文献中Km值差别很大?
因为测定条件(底物、pH、温度、离子强度、酶纯度与底物浓度)不同。读取时应优先采用与目标条件相近的记录,并核对数据来源与测定方法。
5. BRENDA数据库是免费的吗?
BRENDA对学术用户通常可免费访问,商业使用可能需要授权许可。具体访问与许可政策以BRENDA官方页面为准。
6. 如何把BRENDA的动力学数据用于酶工程改造?
先定义动力学瓶颈(如催化效率过低或受产物抑制),结合结构与序列信息定位候选改造位点,再将文献值与实测值对照,形成"设计—验证—迭代"闭环。
7. BRENDA没有我要的数据怎么办?
可结合同源酶的文献数据、结构预测与序列比对进行外推,或通过湿实验测定自身体系的动力学参数,必要时咨询专家协助设计测定方案。
总结
BRENDA酶活性数据查询是连接"酶的身份"与"酶的可用性"的桥梁。它以EC编号为骨架,把文献中分散的Km、kcat、Ki、IC50与最适pH/温度等数据聚合为可检索的图谱;而正确地读取——注意每个参数绑定的底物与测定条件——才是把这些数据变成有效决策的关键。最终,把查询到的数据落到可验证的设计、筛选与工艺优化上,才能让酶活性数据真正产生价值。MatwingsVenus®(晓鹜®)的干湿闭环能力,正致力于让从"酶活数据查询"到"可交付的酶/工艺"的每一步都更清晰、更可验证。
【一句话结论】
BRENDA酶活性数据查询能快速给出酶的Km、kcat、Ki、IC50与最适pH/温度等动力学参数;正确读取并校验这些数据,是把酶从"编号"推进到"设计、改造与工艺验证"的关键一步。
