
AI生物基座模型是什么?它如何成为蛋白质与药物研发的底层引擎?
发布于 2026年11月4日
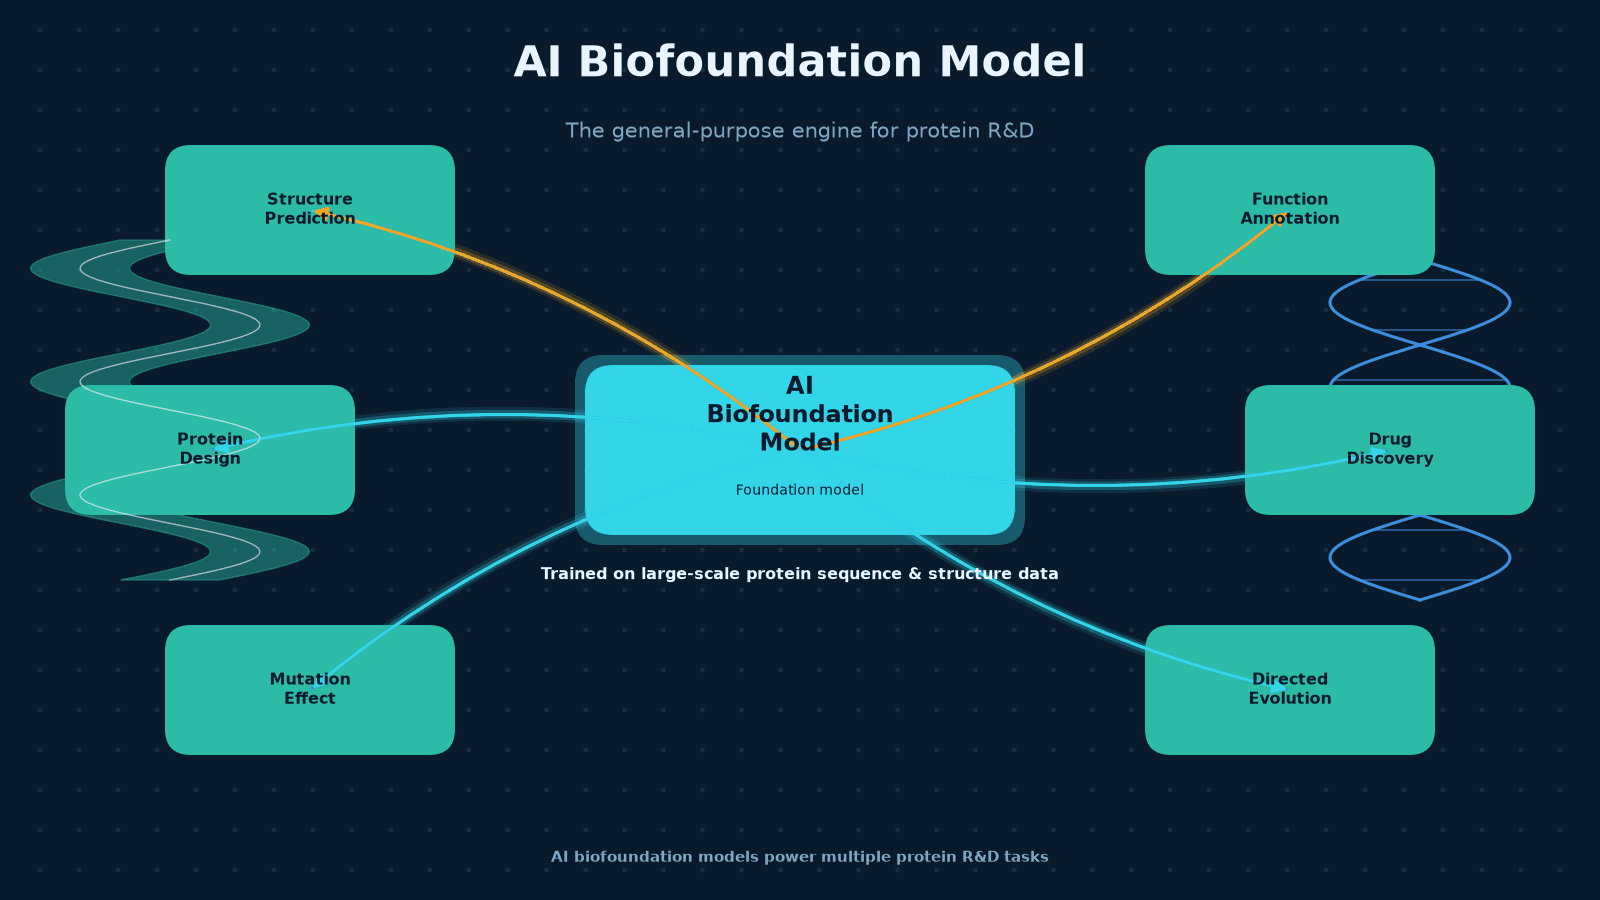
图1 AI生物基座模型:通用引擎驱动多种蛋白研发任务
如果把蛋白质研发比作「读懂一门语言」,AI生物基座模型就像先通读了海量「蛋白质语料」的大模型,再针对具体任务快速适配。它不解决单个问题,而是提供一套可复用的通用能力。下面我们从背景、原理、能力边界讲到落地流程,帮你看清它的价值与局限。
一、背景与机制:从「一任务一模型」到「通用底座+快速适配」
AI生物基座模型是一类先在大规模蛋白质序列、结构与功能数据上预训练、再针对具体任务微调的人工智能模型,它把生物研发从「一任务一模型」转变为「通用底座+快速适配」的新范式。
过去的生物信息学研发,往往是「一任务一模型」:要预测某种蛋白的结构,就得单独训练一套模型;要注释一种酶的功能,又要重新建模。结果就是标注数据稀缺、模型泛化差、重复劳动多,成为制约研发效率的瓶颈。
基座模型(Foundation Model)是先在大量无标注数据上做自监督预训练、学到通用规律,再通过微调或提示适配到各类下游任务的模型。语言领域的 GPT、BERT 是代表;在生物领域,则出现了面向蛋白质序列与结构的基座模型,常被称为蛋白质语言模型(PLM)。
· 序列数据爆炸:已知蛋白序列已超数亿条,但结构与功能标注仍是「万里挑一」。
· 基座模型的价值:把海量未标注序列里隐含的进化、结构与功能规律,压缩进可迁移的特征表示,缓解标注不足。
· 类比:就像学生先通读大量课本建立通识,再学具体科目就快得多。
一句话对比:传统模型是「用有限标注单点攻坚」,基座模型是「用海量数据先建地基、再按需盖楼」。这种通用底座,也正是天鹜科技在蛋白质设计时关注的底层能力之一。
对产业而言,这种范式转移意味着:过去往往要靠大量实验试错,才能定位一条可行序列;如今可以先由基座模型在大空间里快速筛选,再用有限的湿实验确认,从而把研发周期从「数月」压缩到「数周」。
二、原理与结构:预训练、表示学习与微调
AI生物基座模型的核心流程是:先在巨大的蛋白质序列与结构数据上做自监督预训练,学到通用表征,再在结构预测、功能注释等任务上微调,从而用较少的标注数据取得较好性能。
预训练(Pretraining):把氨基酸序列当作「语言」,用掩码预测、对比学习等自监督目标训练。模型在「读懂」海量序列的过程中,会自然学到序列中隐含的进化选择、结构与功能线索。
表示学习(Representation Learning):模型把每条序列映射成一个高维向量(embedding),相似序列、相似功能在向量空间里彼此靠近。这让相似性搜索、功能注释、性质预测有了统一的底座。
微调与适配(Fine-tuning):在有标注的下游任务数据上继续训练,或叠加结构模块(折叠头、注意力层),用于结构预测、活性与亲和力预测,或序列生成与设计。
· 与专用模型的关系:AlphaFold 等是「下游任务」模型,专注结构预测;基座模型是更上游的「通用底座」,可支撑多种任务,二者常配合使用。
· 常见架构:多以Transformer / 注意力机制为骨架,可融合序列语言模型(PLM)与结构感知模块。
如果你想快速理解,可以把流程记成一句话:先「读大量教材」建立通识(预训练),再「学具体科目」形成专长(微调)。
值得一提的是,基座模型的多任务表征还带来「零样本/ 少样本」能力:即使某个任务的标注很少,模型也能借助预训练学到的通用规律给出可用预测,这对冷启动的蛋白项目尤其有价值。

图2 工作流程:预训练—表示学习—微调
三、能力边界与选型:不只看参数量
不同AI生物基座模型在数据规模、架构与任务覆盖上差异很大,选型应重点考察其序列/结构数据处理能力、下游实测性能与可解释性,而不能只比较参数量。
它能做什么:结构预测、功能与家族注释、性质(稳定性、溶解度、表达量)预测、序列生成与设计、突变效应评估。
它不能做什么(能力边界):模型输出的是概率性推断,无法替代真实实验;对训练分布之外的序列(如极端新骨架)外推有限;也存在「看似合理却错误」的幻觉风险。
· 预训练数据:覆盖的物种、序列长度、是否含结构与功能信息。
· 架构与规模:参数量、注意力层层数、是否含结构模块。
· 任务覆盖:支持哪些下游任务、有无公开基准(benchmark)。
· 实测性能:在目标任务上的验证结果,而非宣传口径。
· 可解释性与成本:是否给出置信度/注意力,算力与推理开销。
因此,选型建议先明确任务:你要的是「预测某种性质」还是「设计新序列」?再据此匹配模型。真正关键的问题只有一个——它在你自己的任务上,验证过了没有?
另一个常被忽略的点是「分布外泛化」:目标序列与训练数据差异越大,模型越可能给出置信却错误的判断。因此,把模型用于高度新颖的设计时,应预留湿实验复核,并对低置信度结果谨慎处理。
四、工程化流程:从序列到湿实验的闭环
要把AI生物基座模型真正用于蛋白质工程,需要构建「模型预测—湿实验验证—反馈再训练」的闭环流程,并在数据规范、算力与验证协议上建立条件,才能把预测转化为可复现的性能提升。
一套可落地的工程流程,通常包含五步:
· 1)序列输入与数据准备:统一格式、去冗余、做质量过滤。
· 2)模型推理:选择或微调合适的基座/专用模型,输出候选序列与置信度。
· 3)候选排序与筛选:按预测评分、多样性、可表达性等做过滤。
· 4)湿实验验证:表达、纯化,测定活性、稳定性或亲和力。
· 5)数据回流与主动学习:把实测结果送回训练,让模型随数据迭代改进。
在条件与工艺上,需要把住几个关键点:
· 数据规范:批次一致、标签准确,避免「脏数据」污染模型。
· 算力预算:评估推理成本与资源占用,选择可承受的模型规模。
· 验证协议:指标可复现、设置对照,让结果经得起回到实验台检验。
· 人机协同:模型给候选,实验判真值,二者缺一不可。
整个闭环的价值,在于把「AI 预测」变成「可复现的实验证据」,而不是停留在纸面打分。
衡量闭环是否有效,最终要看「湿实验命中率」与「单轮迭代提升」:即候选里最终验证通过的比例,以及每轮实验后模型对目标性质的预测误差是否下降。这两项指标,比单纯的预测分数更能说明模型是否真正可用。

图3 从序列到验证蛋白的闭环工程流程
五、天鹜科技MatwingsVenus®(晓鹜®):把AI生物基座模型工程化落地
MatwingsVenus®(晓鹜®)平台将AI生物基座模型与高通量湿实验验证闭环结合,面向酶、抗体与蛋白工程场景,提供从设计、预测到筛选验证的一体化服务。
MatwingsVenus®(晓鹜®)是天鹜科技(Matwings Technology)面向蛋白质设计、预测与筛选的一体化平台,致力于把 AI 基座模型的「通用能力」,落到企业真正可用的工程化服务上。
· 用基座模型做序列生成与突变设计,快速缩小搜索空间。
· 配套湿实验设计、筛选与数据回流,形成「预测—验证」闭环。
· 覆盖酶工程(活性、稳定性、底物特异性)、抗体与蛋白设计等场景。
平台强调「AI 预测 + 实验验证」双轮驱动:模型出候选,实验定真值,数据再回流训练,从而减少盲目试错、缩短迭代周期。具体的性能数字与案例,请以实测数据为准,我们不作未经核实的宣传承诺。
六、常见问题(FAQ)
AI生物基座模型和 AlphaFold 有什么区别?
AlphaFold 专注于结构预测这一具体「下游任务」;AI生物基座模型是更上游的「通用底座」,先在海量序列/结构上预训练,可支持结构预测、功能注释、序列生成等多种任务。二者常结合使用:基座模型提供通用表征,AlphaFold 提供高精度结构。
AI生物基座模型能直接替代湿实验吗?
不能。模型给出的是概率推断与候选,湿实验(表达、纯化、活性测定)才是判定真值的依据。基座模型的价值在于缩小搜索空间、减少盲目实验,而不是替代验证。
中小团队如何用上AI生物基座模型?
可以先从开源或云端API 接入序列/性质预测模型起步,重点用于打分与排序,再用少量湿实验做验证;也可以借助像晓鹜®这样的工程化平台,把模型与筛选闭环交给现成工具,降低上手门槛。
AI生物基座模型的预测可信吗?如何验证?
可信度取决于模型在目标任务上的实测表现,以及输入是否落在训练分布内。应关注模型是否给出置信度/注意力,并在独立、可复现的验证集上评估,再结合湿实验确认;对高风险决策应保持保守。
七、结语:AI生物基座模型是起点,不是终点
AI生物基座模型把海量生物数据转化为可复用的通用能力,是蛋白质与药物研发的重要起点;但真正的价值来自「模型预测 + 湿实验验证」的闭环,以及持续的数据迭代。选对模型、跑通流程、对齐实验,才能把技术红利变成可落地的产品与服务。
